
Remarque : comme d'habitude, toute mon écrit public est écrit à la main par moi-même.
Aperçu
Un filtre Bloom est une structure de données probabiliste qui vous permet de répondre rapidement et à moindre coût à la question « la clé X est-elle dans cet ensemble ? » avec soit « définitivement non » soit « probablement oui ». Vous choisissez un taux de faux positifs acceptable pour votre charge de travail et votre matériel, ajoutez des clés à l'ensemble, puis vérifiez leur existence ultérieurement. Les filtres Bloom utilisent une petite quantité de mémoire par rapport à la cardinalité de l'ensemble et sont très peu coûteux en calcul. Pour ces raisons, ils sont fréquemment utilisés dans les systèmes de données à haute performance. Par exemple, une base de données pourrait conserver un filtre Bloom en mémoire et le vérifier avant d'aller réellement sur le disque lors de la recherche de lignes. Cela économise des quantités substantielles d'entrées/sorties de disque très lentes. Nous les utilisons également partout dans le backend de Bluesky. Ils nous permettent d'économiser des millions de requêtes par seconde contre notre base de données Scylla lors de la recherche de blocages, de mutes, de labels et plus encore. Par exemple, nous pouvons souvent répondre à la question « l'utilisateur X bloque-t-il l'utilisateur Y ? » sans même toucher à la base de données.
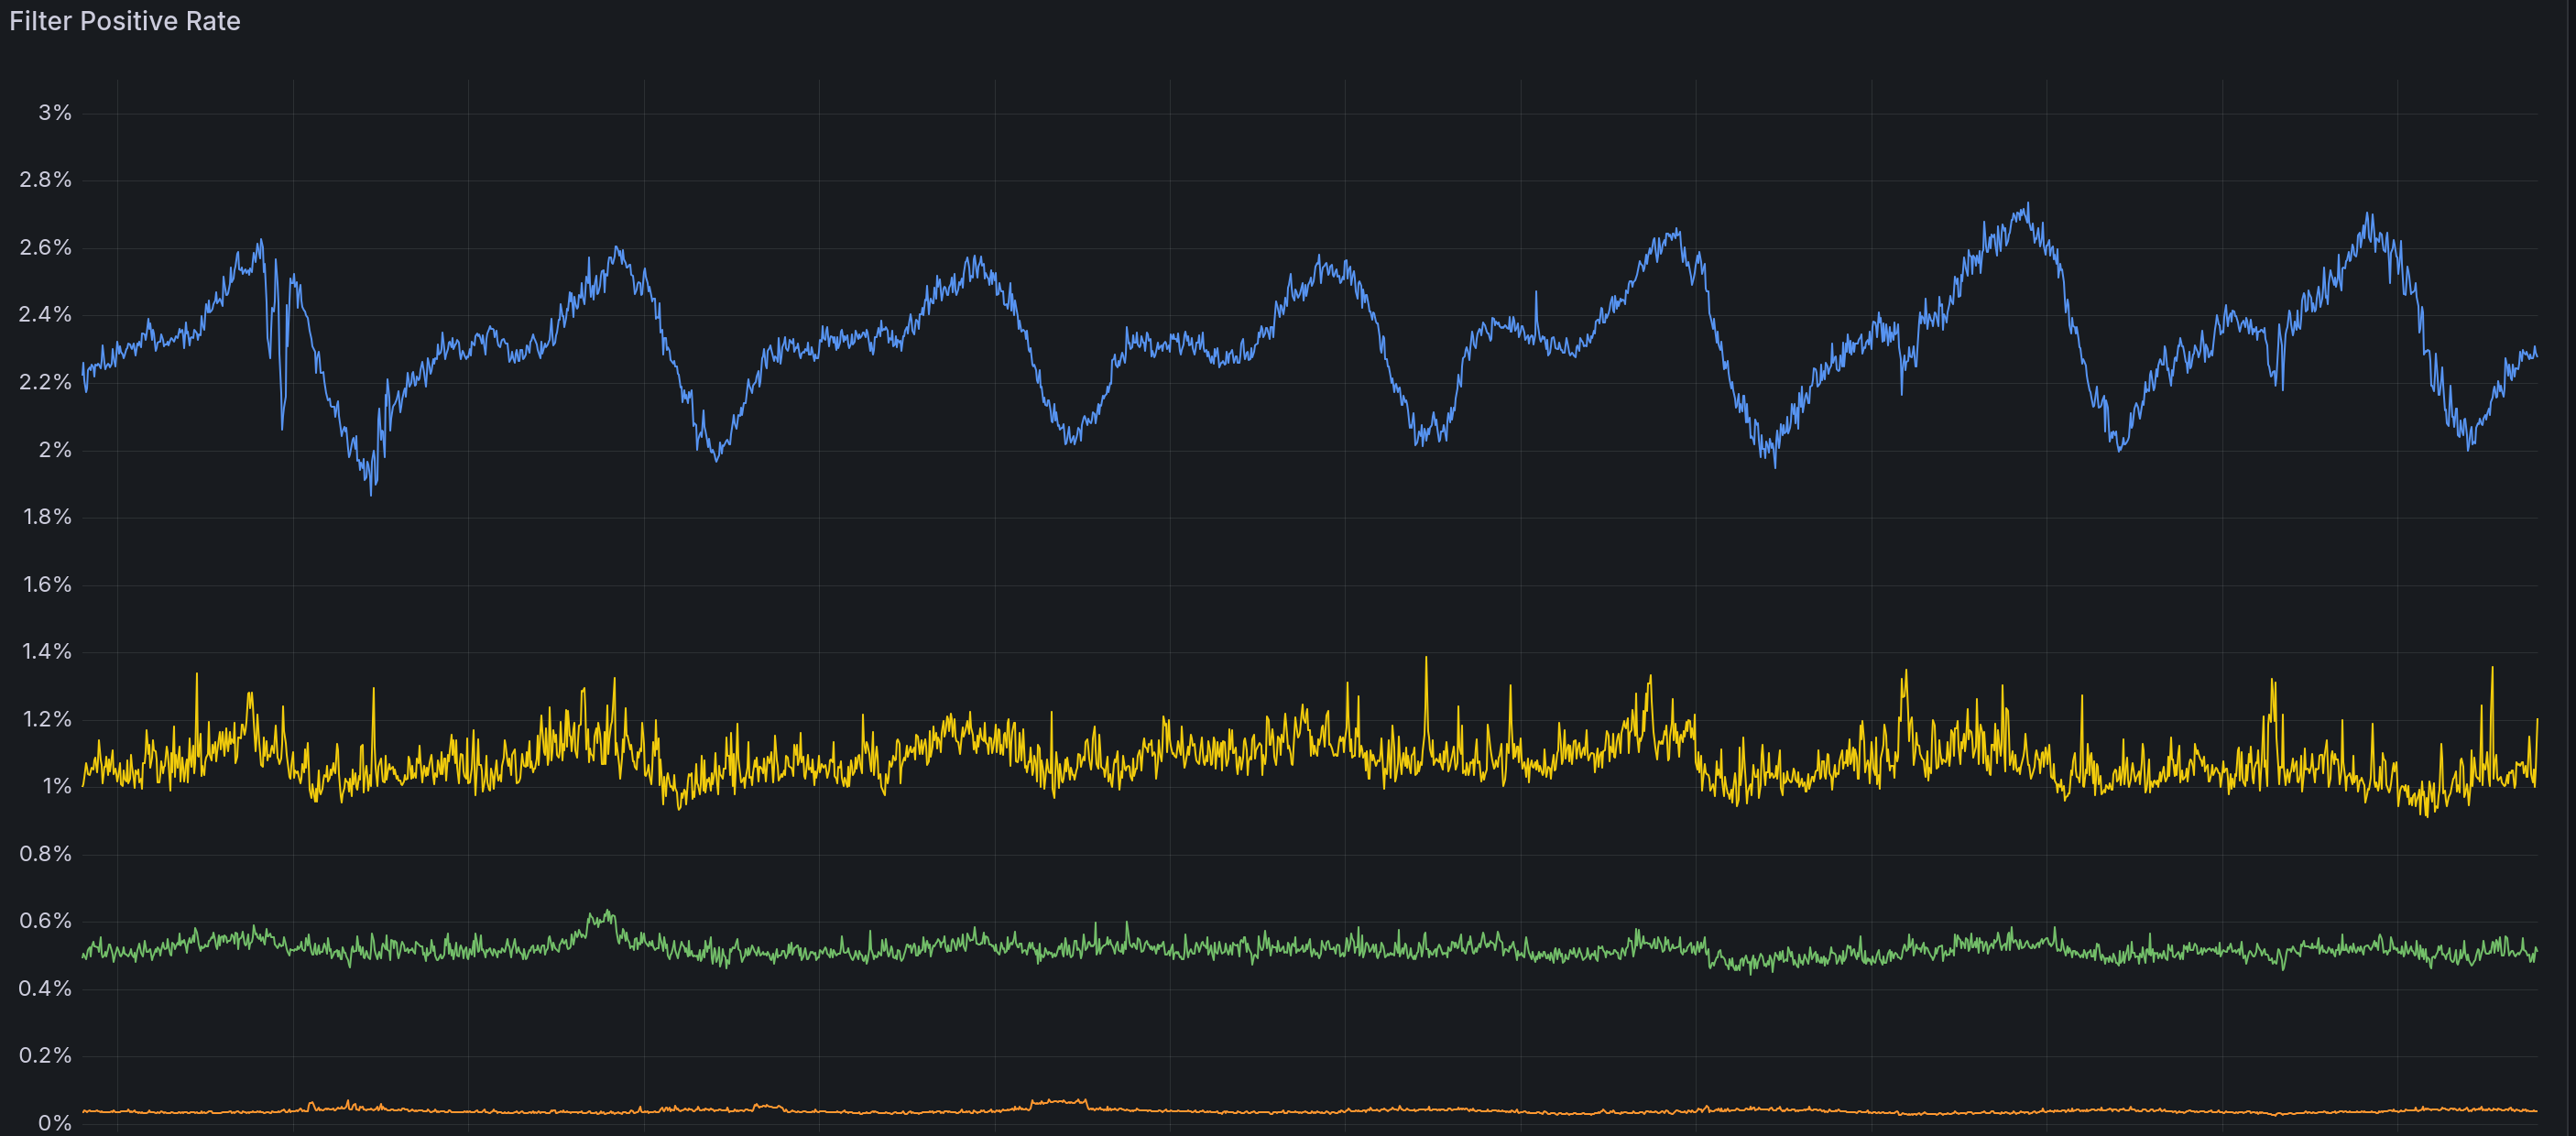
Voici les derniers jours de certains de nos taux de réussite positifs des filtres Bloom :
La ligne jaune ci-dessus montre un taux positif d'environ 1 %, ce qui signifie que 99 % du temps, nous pouvons complètement ignorer la requête de notre base de données. Cela a été crucial pour notre capacité à faire évoluer le site et à l'exploiter à faible coût.
Filtres Bloom Traditionnels
Un filtre Bloom est un tableau de bits et k fonctions de hachage. Vous choisissez la taille du tableau et k à l'avance, et vous voulez le dimensionner correctement pour votre charge de travail afin d'atteindre un taux spécifique de faux positifs. Pour ajouter une clé à l'ensemble, faites-la passer par les k fonctions de hachage et définissez les bits à chaque emplacement. Pour vérifier si une clé est dans l'ensemble, hachez-la k fois et vérifiez chaque emplacement résultant dans le tableau de bits. Si un bit est zéro, la clé n'a jamais été ajoutée. Si tous les bits sont définis à un, il pourrait être dans l'ensemble.
Double Hachage
Bien moins coûteux que d'aller sur le disque, calculer k hachages indépendants pour chaque clé est encore un peu coûteux pour les systèmes de très haute performance. En 2008, Kirsch et Mitzenmacher ont publié un article démontrant que deux hachages peuvent vous donner la même sortie. Les mathématiques sont bien au-dessus de ma tête, mais si vous dérivez l'emplacement i-ème comme (hash_1 + i*hash_2) % n, alors le taux de faux positifs est effectivement le même que celui de l'utilisation de k hachages indépendants. Phew !
bits-and-blooms/bloom maintenu par Daniel Lemire (une énorme source d'inspiration pour moi, vous devriez acheter son livre) est une excellente implémentation de filtre Bloom à double hachage écrite en Go. Il exécute murmur3 de 128 bits deux fois pour obtenir quatre valeurs de 64 bits, puis les combine pour produire tous les emplacements de bits k. Nous l'avons utilisé en production chez Bluesky pendant longtemps.
Pour le backend de Bluesky, nous effectuons essentiellement un SELECT * FROM blocks, mutes, list items, etc. chaque fois qu'un des processus démarre, et ajoutons tous les éléments au filtre Bloom. Il y a également un consommateur en temps réel du firehose atproto insérant des éléments dans les filtres Bloom (même pendant le démarrage du processus), donc il y a une condition de course si vous n'êtes pas prudent. Le problème avec la bibliothèque bits-and-blooms est qu'elle n'est pas internement thread-safe, donc nous devions envelopper tous les accès au filtre Bloom dans un mutex pour éviter les courses de données. pprof a montré que la contention du mutex était réellement le goulot d'étranglement dans le lancement du processus. Un seul déploiement pouvait prendre 90 minutes pour être entièrement déployé à cause de cela ! Donc mon collègue Jasmine a forké la bibliothèque et créé atomic-bloom, qui utilise des instructions CPU atomiques pour faire la même logique, mais de manière sûre et sans mutex. Cela a conduit à une contention nettement inférieure et était nettement plus rapide que l'approche basée sur les mutex. Nos déploiements sont passés de 90 minutes à environ 15, ce qui nous a permis de livrer plus rapidement et avec plus de confiance. Génial !
Un Seul Hash
Pourrions-nous aller plus loin ? Pour Bluesky, la réponse est non. La contention était notre problème d'origine, pas le nombre de fonctions de hachage ou d'autres facteurs, donc selon la loi d'Amdahl, nous n'avons pas obtenu d'autres bénéfices...
Source: Hacker News · Résumé par HeadlinesBriefing