
Nota: como siempre, toda mi escritura pública está escrita a mano por mí.
Resumen
Un filtro Bloom es una estructura de datos probabilística que te permite responder rápida y económicamente a la pregunta "¿la clave X está en este conjunto?" con "definitivamente no" o "probablemente". Elegyes una tasa de falsos positivos aceptable para tu carga de trabajo y hardware, agregas claves al conjunto y luego verificas su existencia más tarde. Los filtros Bloom usan poca memoria en comparación con la cardinalidad del conjunto y son computacionalmente muy económicos. Por estas razones, se usan frecuentemente en sistemas de datos de alto rendimiento. Por ejemplo, una base de datos podría mantener un filtro Bloom en memoria y verificarlo antes de ir realmente al disco al buscar filas. Esto ahorra grandes cantidades de muy lenta entrada/salida de disco. También los usamos en muchos lugares en el backend de Bluesky. Nos permiten ahorrar millones de consultas por segundo contra nuestra base de datos Scylla al buscar bloqueos, silencios, etiquetas y más. Por ejemplo, a menudo podemos responder a la pregunta "¿el usuario X bloquea al usuario Y?" sin siquiera tocar la base de datos.
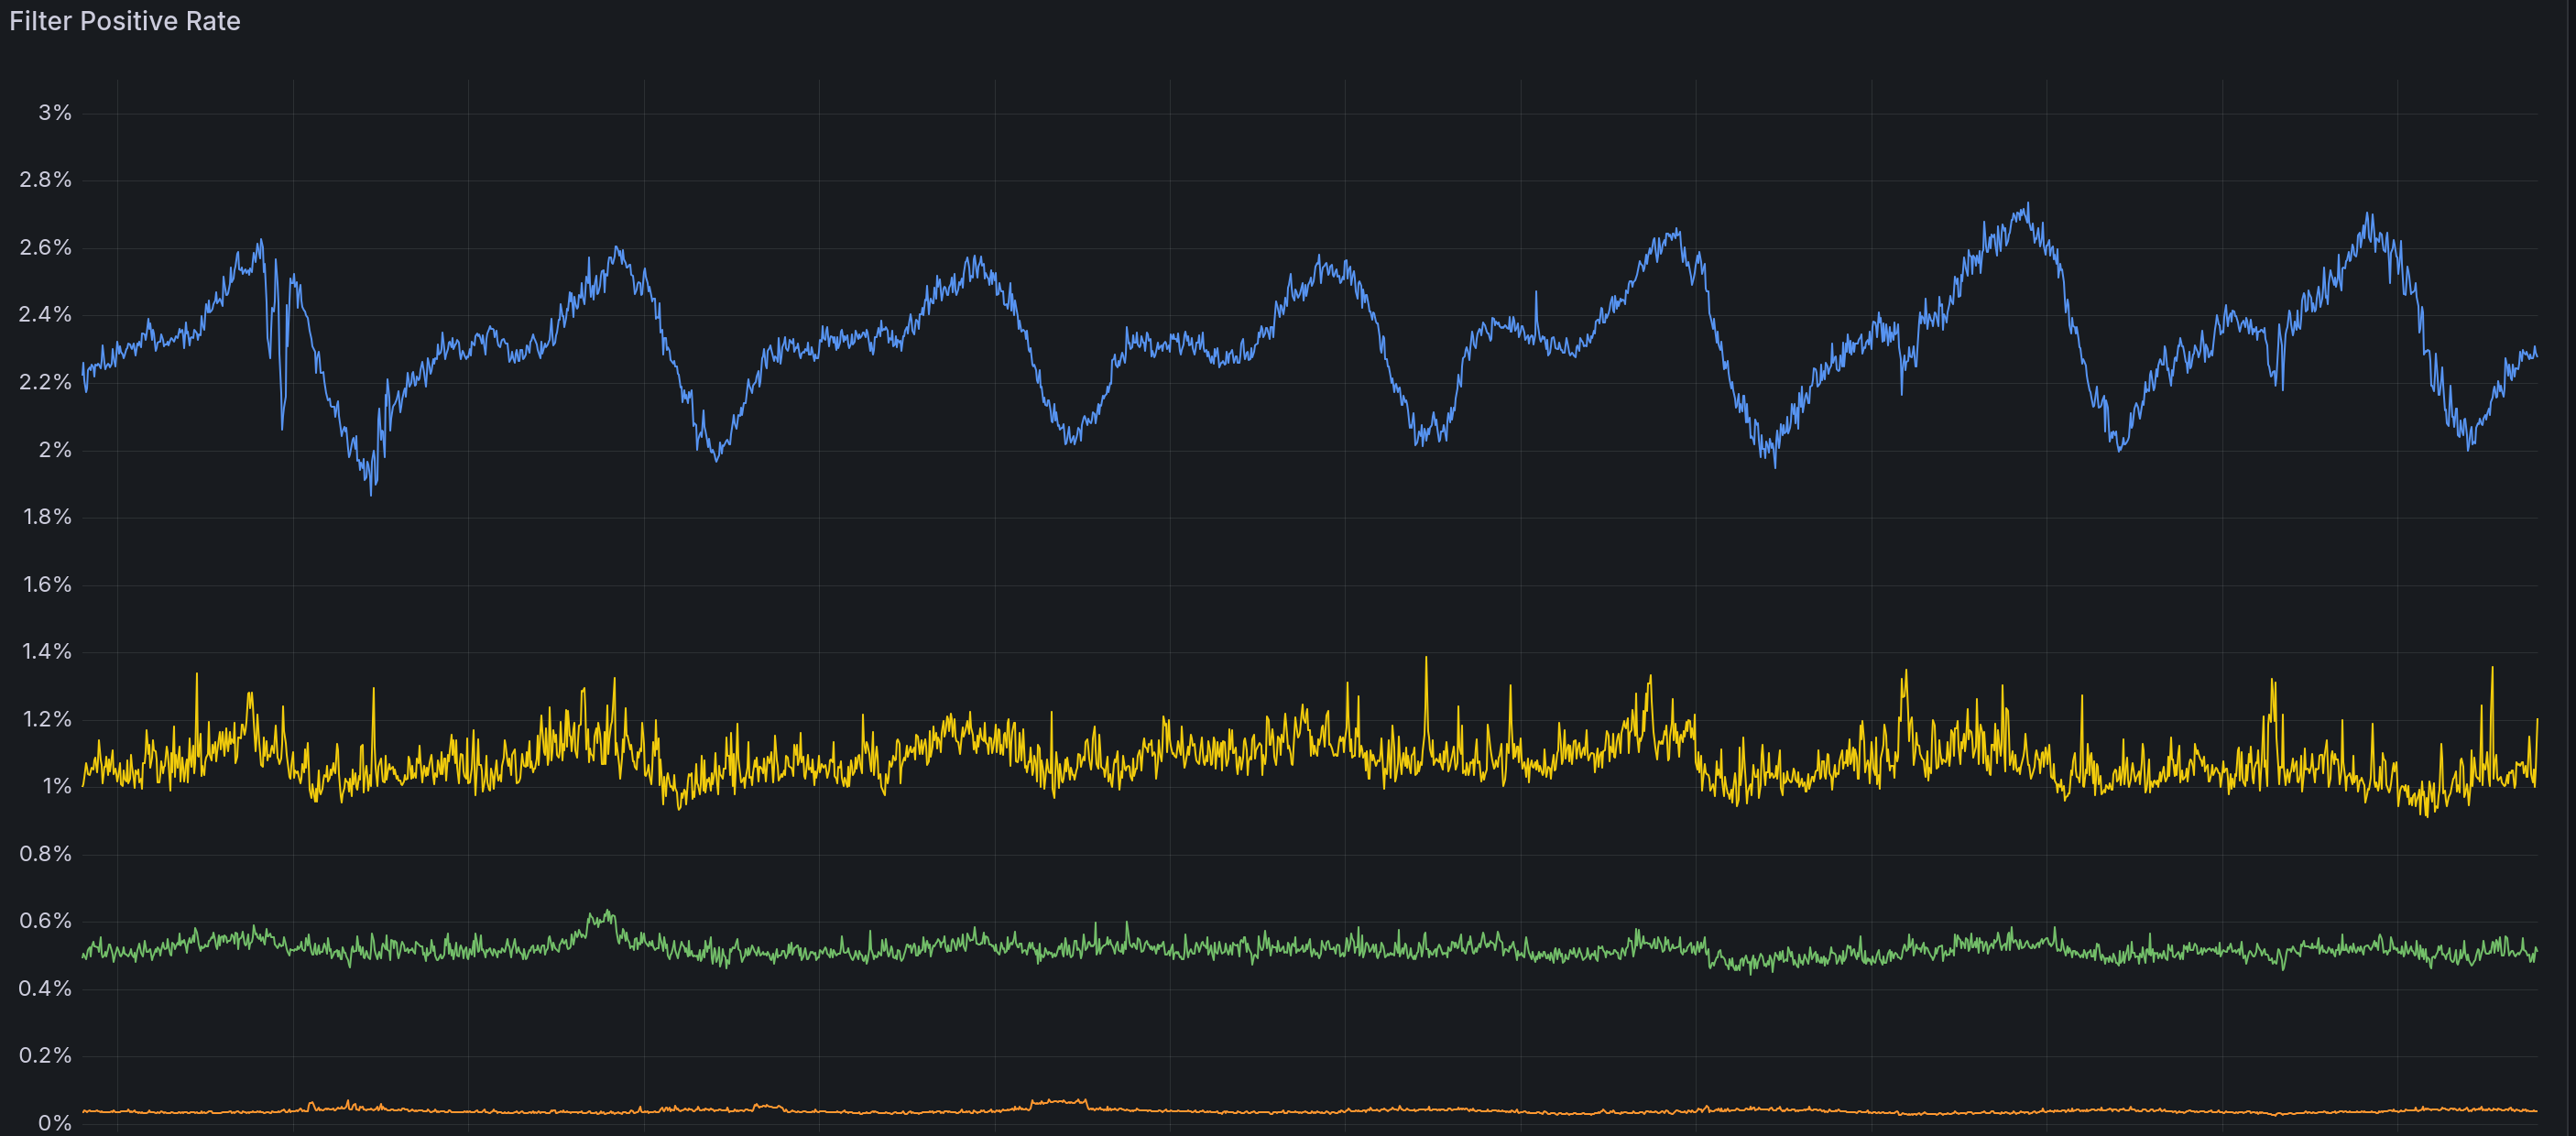
Aquí tienes los últimos días de algunas de nuestras tasas de aciertos positivos de filtros Bloom:
La línea amarilla tiene una tasa positiva de aproximadamente 1%, lo que significa que el 99% del tiempo, podemos omitir completamente la consulta a nuestra base de datos. Esto ha sido crítico para nuestra capacidad de escalar el sitio y operarlo con bajo costo.
Filtros Bloom Tradicionales
Un filtro Bloom es una matriz de bits y k funciones hash. Eliges el tamaño de la matriz y k de antemano, y quieres ajustarlo correctamente a tu carga de trabajo para lograr una tasa específica de falsos positivos. Para agregar una clave al conjunto, pásala por las k funciones hash y establece los bits en cada una de esas ubicaciones. Para verificar si una clave está en el conjunto, hashea k veces y verifica cada ubicación resultante en la matriz de bits. Si algún bit es cero, la clave nunca fue agregada. Si todos los bits están en uno, podría estar en el conjunto.
Doble Hash
Aunque es mucho más barato que ir al disco, calcular k hashes independientes por clave sigue siendo un poco costoso para sistemas de muy alto rendimiento. En 2008, Kirsch y Mitzenmacher publicaron un paper demostrando que dos hashes pueden darte la misma salida. Las matemáticas están muy por encima de mi cabeza, pero si derivas la i-ésima ubicación como (hash_1 + i*hash_2) % n, entonces la tasa de falsos positivos es efectivamente la misma que usar k hashes independientes. ¡Uf!
bits-and-blooms/bloom mantenido por Daniel Lemire (una enorme inspiración para mí, deberías comprar su libro) es una excelente implementación de filtro Bloom de doble hash escrita en Go. Ejecuta murmur3 de 128 bits dos veces para obtener cuatro valores de 64 bits, luego los combina para producir todas las k ubicaciones de bits. Lo usamos en producción en Bluesky durante mucho tiempo.
Para el backend de Bluesky, esencialmente hacemos un SELECT * FROM blocks, mutes, list items, etc. cada vez que uno de los procesos arranca, y agregamos todos los elementos al filtro Bloom. También hay un consumidor en tiempo real del firehose atproto insertando elementos en los filtros Bloom (incluso durante el arranque del proceso), por lo que hay una condición de carrera si no tienes cuidado. El problema con la biblioteca bits-and-blooms es que no es internamente segura para hilos, por lo que necesitábamos envolver todo el acceso al filtro Bloom en un mutex para evitar carreras de datos. pprof mostró que la contención del mutex realmente era el cuello de botella en el lanzamiento del proceso. ¡Un solo despliegue solía tomar 90 minutos para completarse por completo debido a esto! Así que mi colega Jasmine hizo un fork de la biblioteca y creó atomic-bloom, que usa instrucciones atómicas de CPU para hacer la misma lógica, pero de manera segura y sin mutexes. Esto condujo a una menor contención y fue significativamente más rápido que el enfoque basado en mutexes. Nuestros despliegues pasaron de 90 minutos a aproximadamente 15, lo que nos permitió lanzar más rápido y con mayor confianza. ¡Increíble!
Un Solo Hash
¿Podemos ir más allá? Para Bluesky, la respuesta es no. La contención era nuestro problema original, no el número de funciones hash u otros factores, así que según la ley de Amdahl no recibimos ningún beneficio adicional...
Fuente: Hacker News · Resumido por HeadlinesBriefing