
注意:如往常一样,我的所有公开写作都是手写的。
概述
布隆过滤器是一种概率数据结构,它可以快速、低成本地回答问题"这个集合中是否存在键X?",答案要么是"绝对不存在",要么是"可能存在"。你选择一个适合工作负载和硬件的误报率,向集合中添加键,然后稍后检查它们的存在性。布隆过滤器相比于集合的基数使用很少的内存,并且在计算上非常便宜。正因为如此,它们经常被用于高性能数据系统。例如,数据库可能会在内存中保存一个布隆过滤器,并在实际访问磁盘查找行之前检查它。这可以节省大量非常缓慢的磁盘IO。我们在Bluesky后端的许多地方也使用它们。它们允许我们在查找屏蔽、静音、标签等内容时,节省数以百万计的对Scylla数据库的查询。例如,我们经常可以在不访问数据库的情况下回答问题"用户X是否屏蔽了用户Y"。
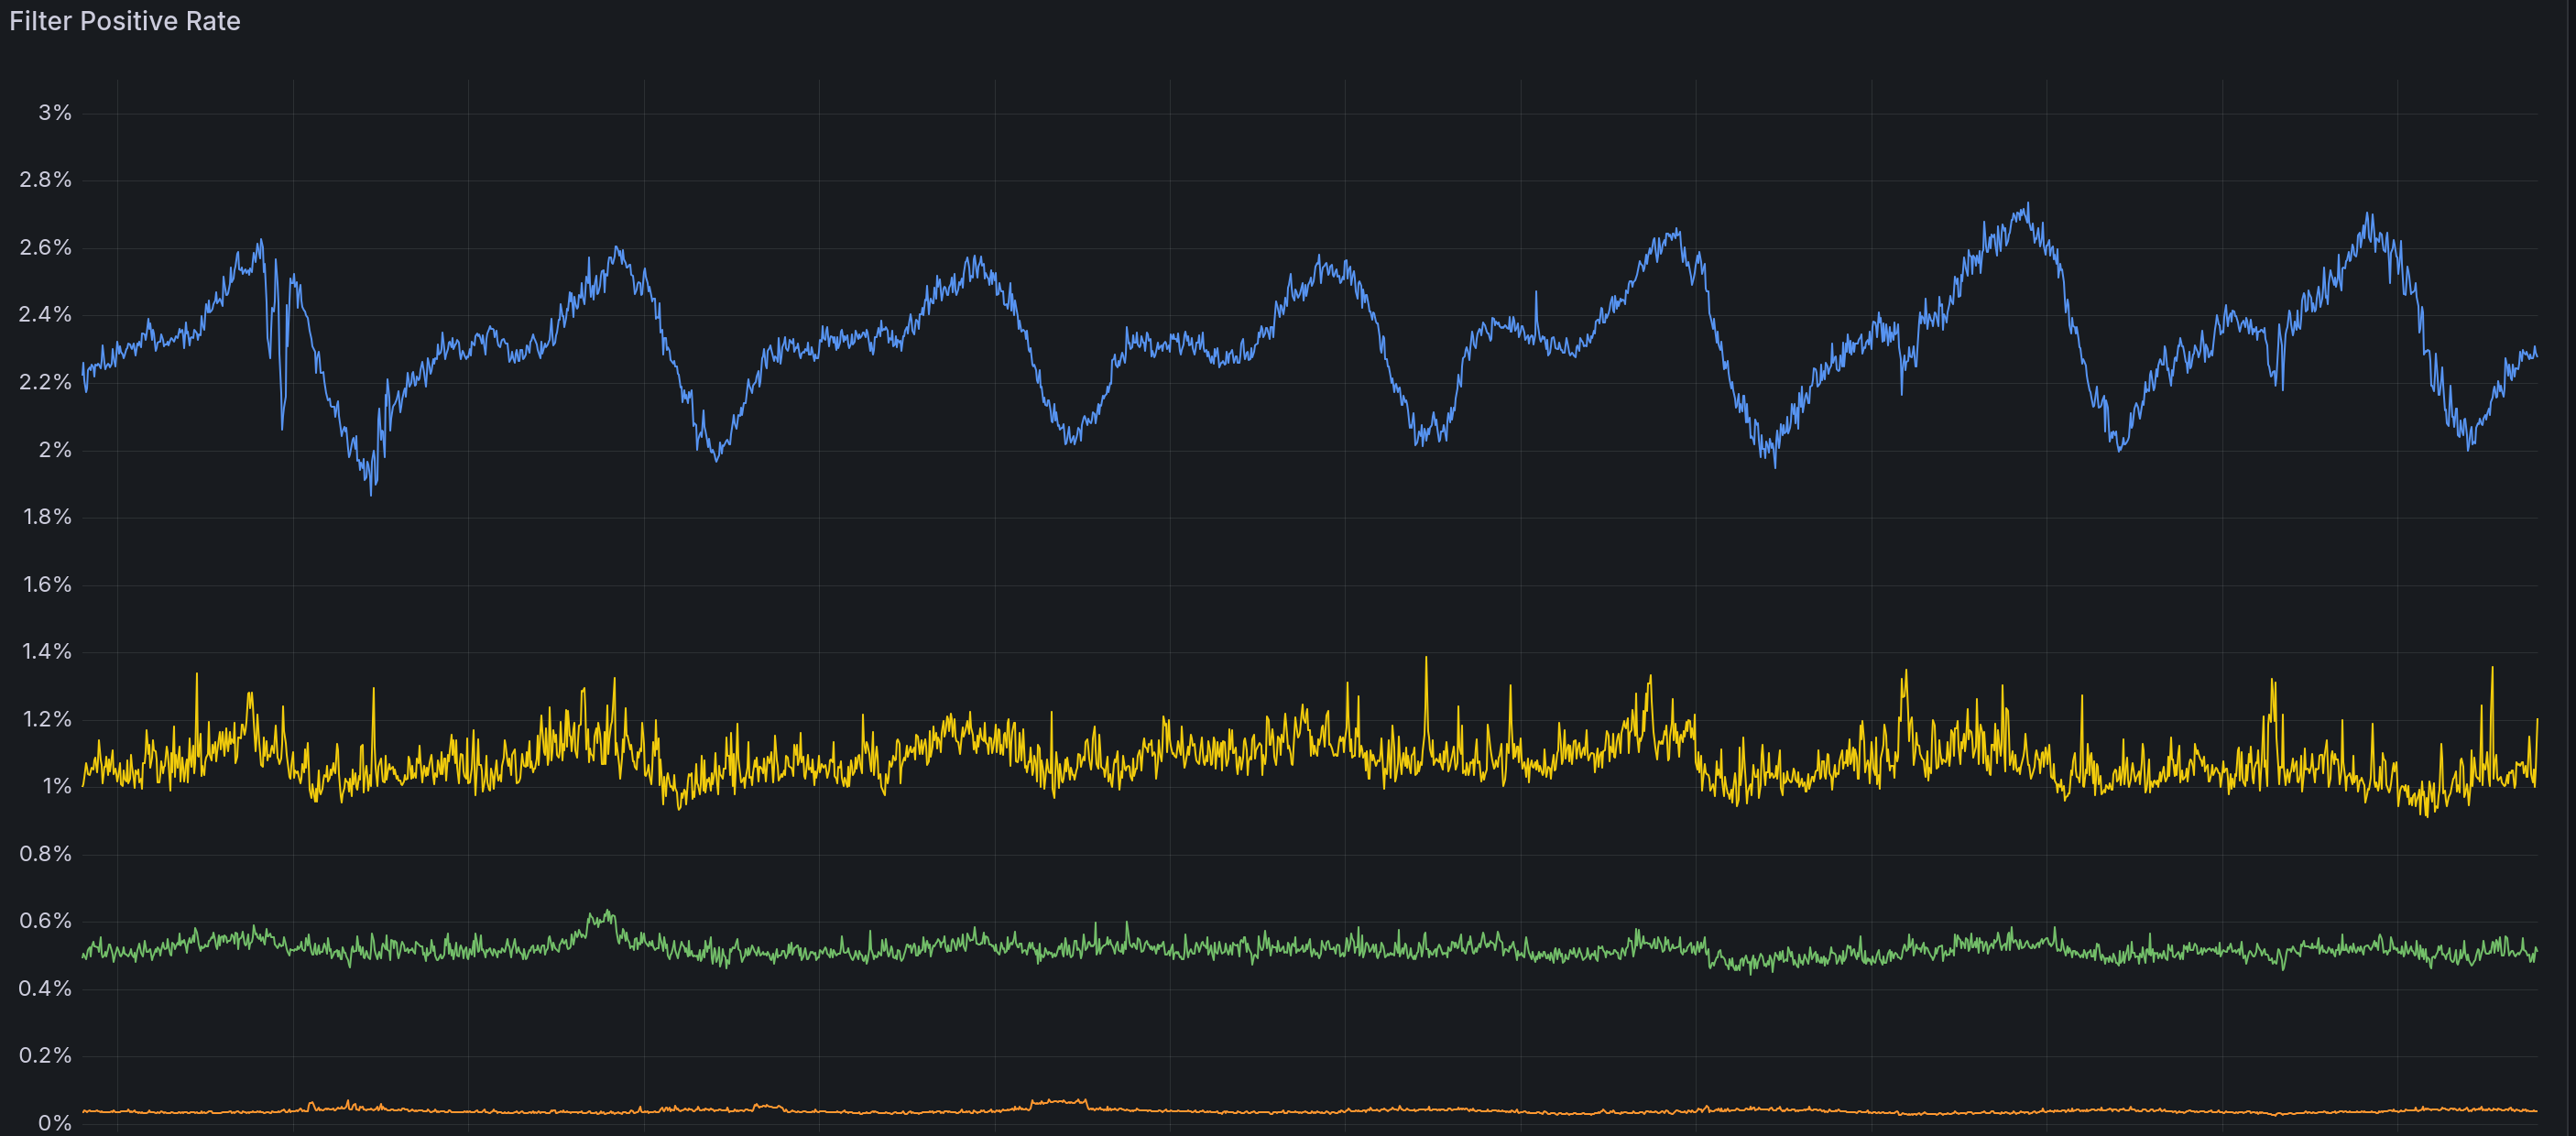
以下是我们最近几天一些布隆过滤器命中率的曲线图:
上述黄线显示大约1%的命中率,这意味着99%的时间,我们可以完全跳过查询数据库。这对我们扩展和以低成本运行网站至关重要。
传统布隆过滤器
布隆过滤器是一个位数组和k个哈希函数。你需要预先选择数组大小和k值,并根据工作负载调整大小以达到特定的误报率。要向集合中添加一个键,将其通过k个哈希函数并在每个位置设置位。要检查一个键是否在集合中,用k次哈希并检查位数组中每个结果位置。如果任何位为零,则该键从未被添加。如果所有位都设置为1,则它可能在集合中。
双哈希
虽然比访问磁盘便宜得多,但对每个键计算k个独立哈希仍然对于非常高性能的系统来说有些昂贵。2008年,Kirsch和Mitzenmacher发表了一篇论文,证明两个哈希可以给你相同的输出。数学对我来说太过复杂,但如果你将第i个位置推导为(hash_1 + i*hash_2) % n,那么误报率实际上与使用k个独立哈希相同。太棒了!
由Daniel Lemire维护的bits-and-blooms/bloom(他是我的一位巨大灵感来源,你应该买他的书)是一个用Go语言编写的优秀双哈希布隆过滤器实现。它运行128位murmur3哈希两次,得到四个64位值,然后将它们组合以产生所有k个位位置。我们在Bluesky生产环境中长期使用它。
对于Bluesky后端,我们基本上每次其中一个进程启动时都会执行SELECT * FROM blocks, mutes, list items等操作,并将所有项目添加到布隆过滤器中。还有实时atproto火山消费者在进程启动期间将项目插入布隆过滤器,因此如果不小心就会出现竞态条件。
bits-and-blooms库的问题是它不是内部线程安全的,因此我们需要用互斥锁包装所有布隆过滤器访问,否则我们会遇到数据竞争。pprof显示互斥锁争用实际上是进程启动的瓶颈。一次部署需要90分钟才能完全推出,就是因为这个!
因此我的同事Jasmine fork了该库并创建了atomic-bloom,它使用原子CPU指令来执行相同的逻辑,但安全且无需互斥锁。这导致了明显减少的争用,并且比基于互斥锁的方法快得多。我们的部署时间从90分钟缩短到大约15分钟,这使我们能够更快、更有信心地发布功能。太棒了!
一次哈希
我们能走得更远吗?对于Bluesky来说,答案是否定的。我们的原始问题是争用,而不是哈希函数的数量或其他因素,因此根据阿姆达尔定律,我们没有获得任何进一步的...
来源: Hacker News · 由HeadlinesBriefing整理摘要