
La regresión lineal es popular por su simplicidad, rapidez e interpretabilidad, pero las relaciones reales suelen curvarse, aplanarse o cambiar según la región. La distancia de frenado, la respuesta de los cultivos, la potencia de los aerogeneradores y el efecto Doppler satelital muestran una curvatura que una línea recta no puede capturar.
El artículo anterior de esta serie comparó OLS con la regresión de Huber, RANSAC, GNC-GM, GNC-TLS y ASOR para ver cómo reacciona un ajuste de línea recta cuando las observaciones contaminadas lo alejan de la relación nominal. Esta entrega mantiene el mismo problema de robustez, pero dota al modelo de mayor flexibilidad.
Dos preguntas guían el enfoque. El estimador controla qué observaciones se consideran fiables, mientras que la base controla qué formas puede representar el modelo. Las características polinómicas son un primer paso natural, pero su flexibilidad es global: cambiar un solo coeficiente remodela la curva en todas partes. Las splines introducen flexibilidad de forma local.
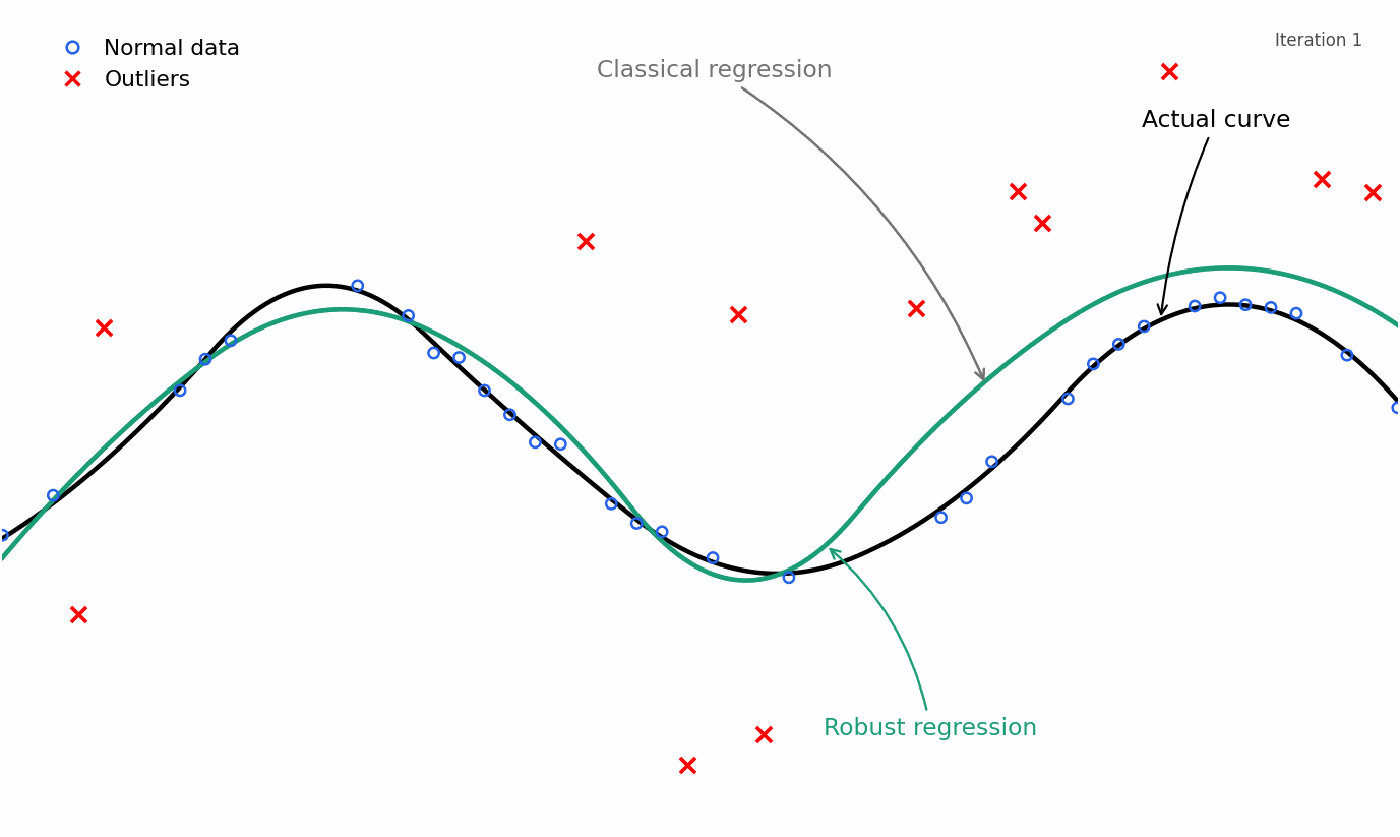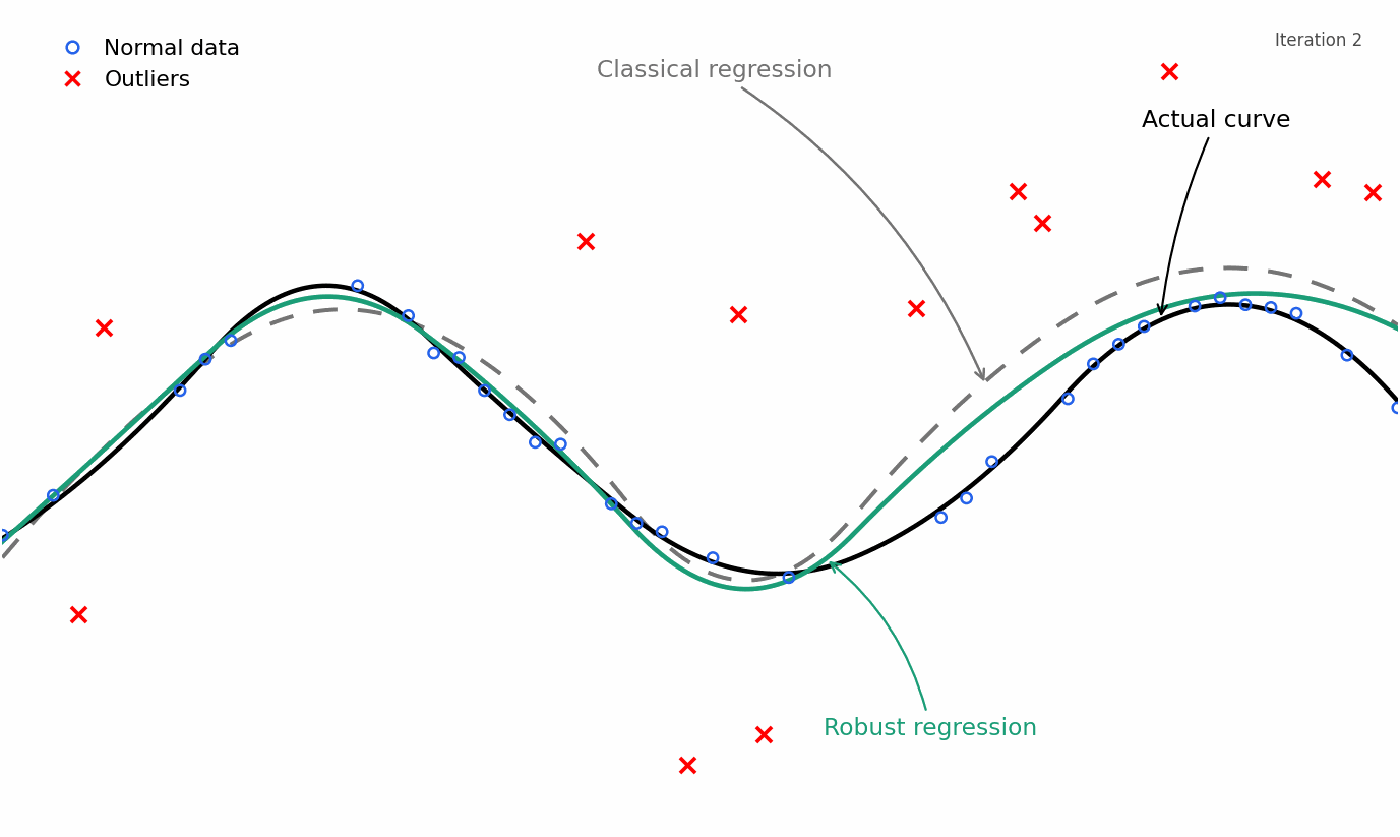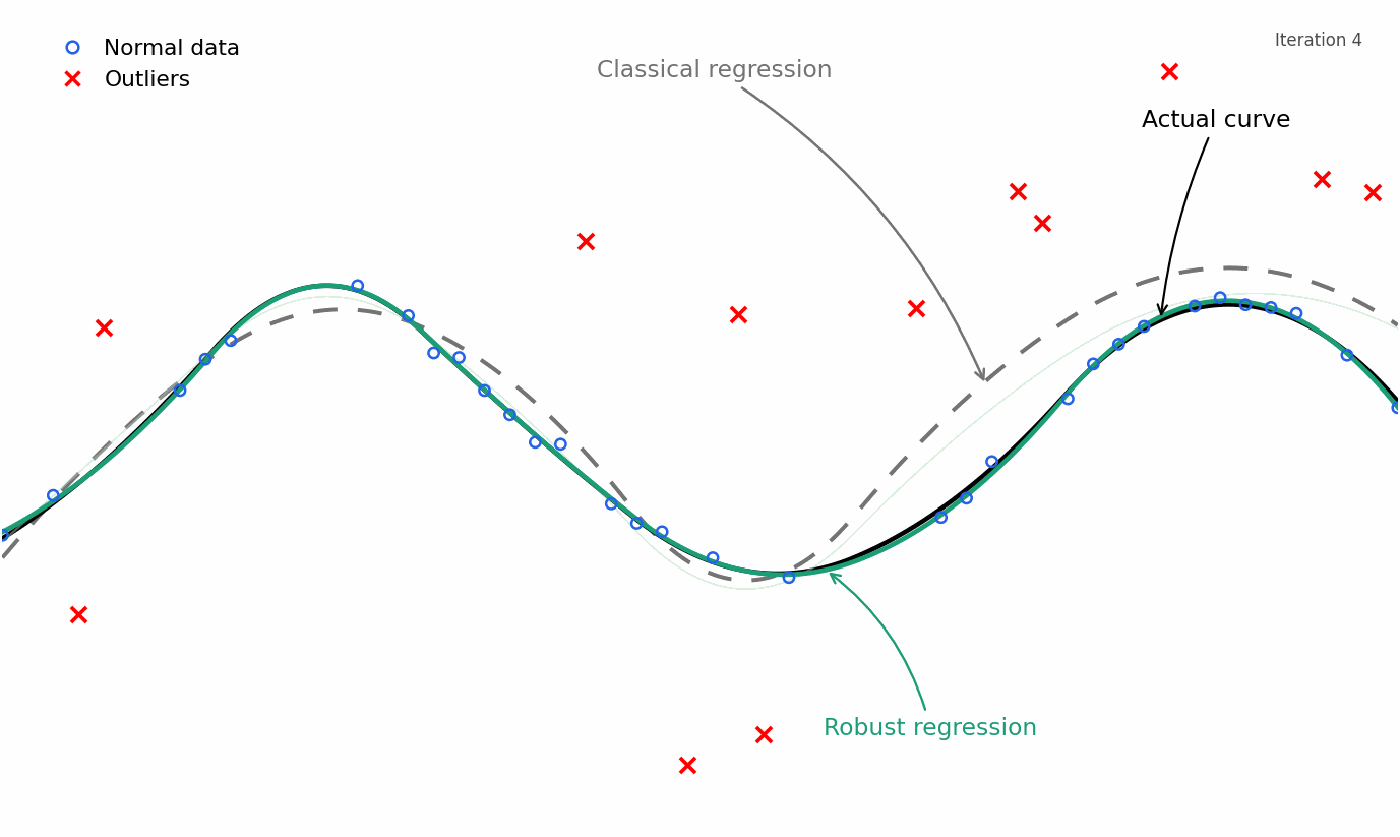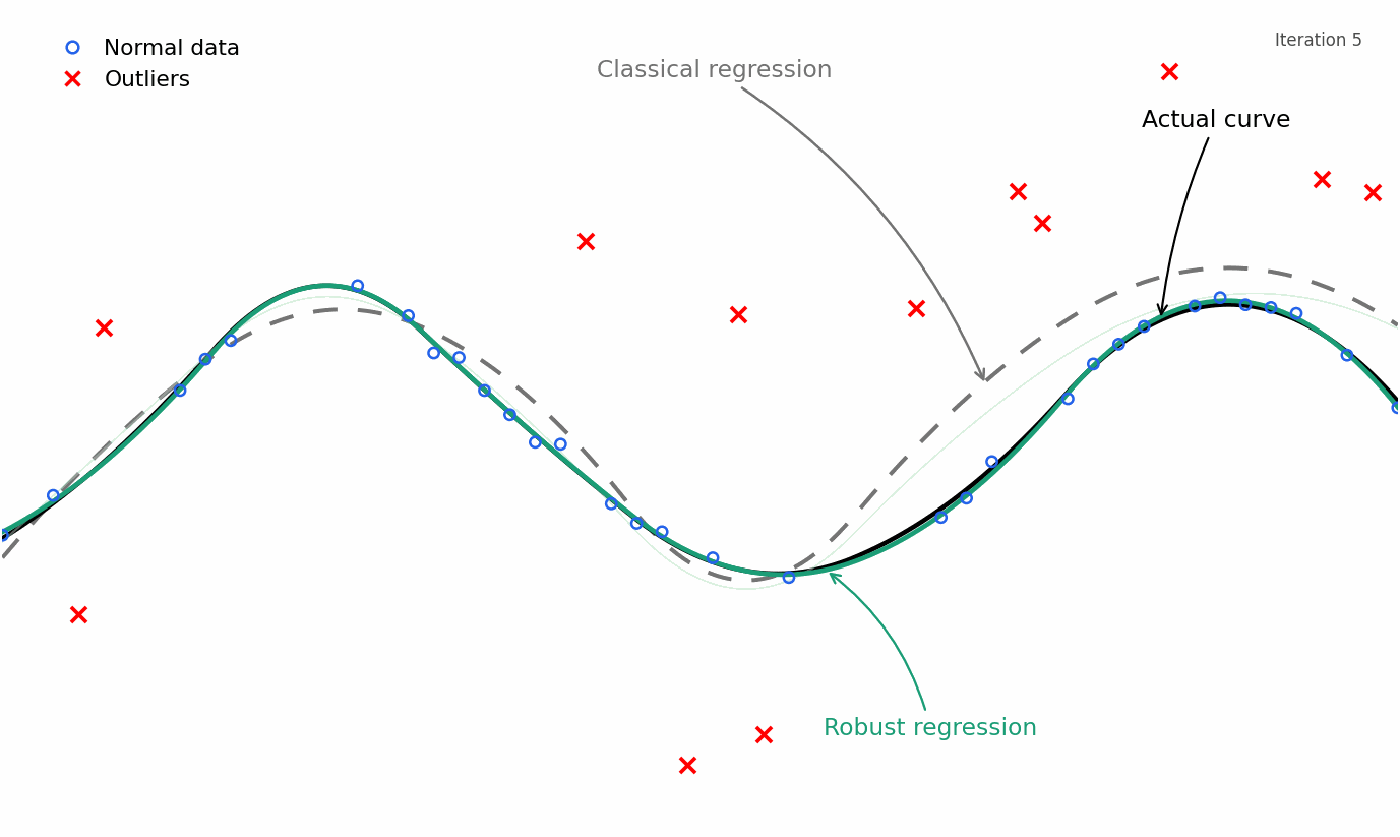
El artículo ilustra la cuestión de la confianza con un ejemplo no lineal. Con datos limpios, OLS sigue de cerca la relación subyacente. Cuando el 30% de las respuestas está contaminado, el ajuste OLS se aleja mucho de la curva verdadera, mientras que un ajuste robusto permanece mucho más cerca de ella. A continuación, la regresión polinómica se plantea como un modelo lineal en un espacio de características transformado, con coeficientes estimados por mínimos cuadrados sobre una matriz de diseño.
Fuente: Towards Data Science · Resumido por HeadlinesBriefing