
La régression linéaire est populaire pour sa simplicité, sa rapidité et son interprétabilité, mais les relations réelles se courbent, s'aplatissent ou changent d'une région à l'autre. La distance de freinage, la réponse des cultures, la puissance des éoliennes et l'effet Doppler satellitaire présentent tous une courbure qu'une droite ne peut pas capturer.
L'article précédent de cette série comparait les moindres carrés ordinaires (OLS) à la régression de Huber, RANSAC, GNC-GM, GNC-TLS et ASOR, afin d'observer comment un ajustement linéaire réagit lorsque des observations contaminées l'éloignent de la relation nominale. Cet épisode conserve le même problème de robustesse, mais donne au modèle davantage de souplesse.
Deux questions guident l'approche. L'estimateur contrôle les observations auxquelles on accorde sa confiance, tandis que la base détermine les formes que le modèle peut représenter. Les caractéristiques polynomiales constituent une première étape naturelle, mais leur souplesse est globale : modifier un seul coefficient remodèle la courbe partout. Les splines, elles, introduisent une souplesse locale.
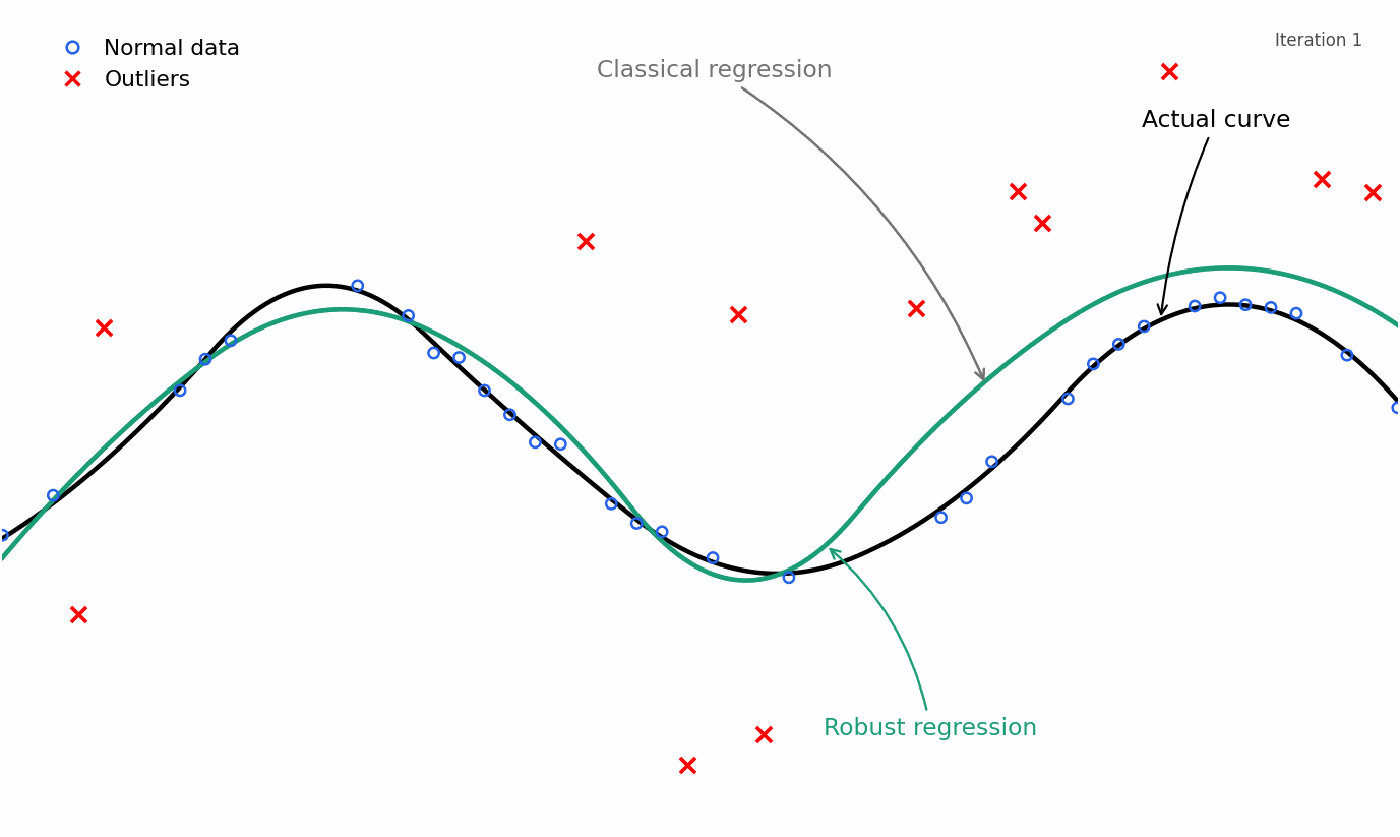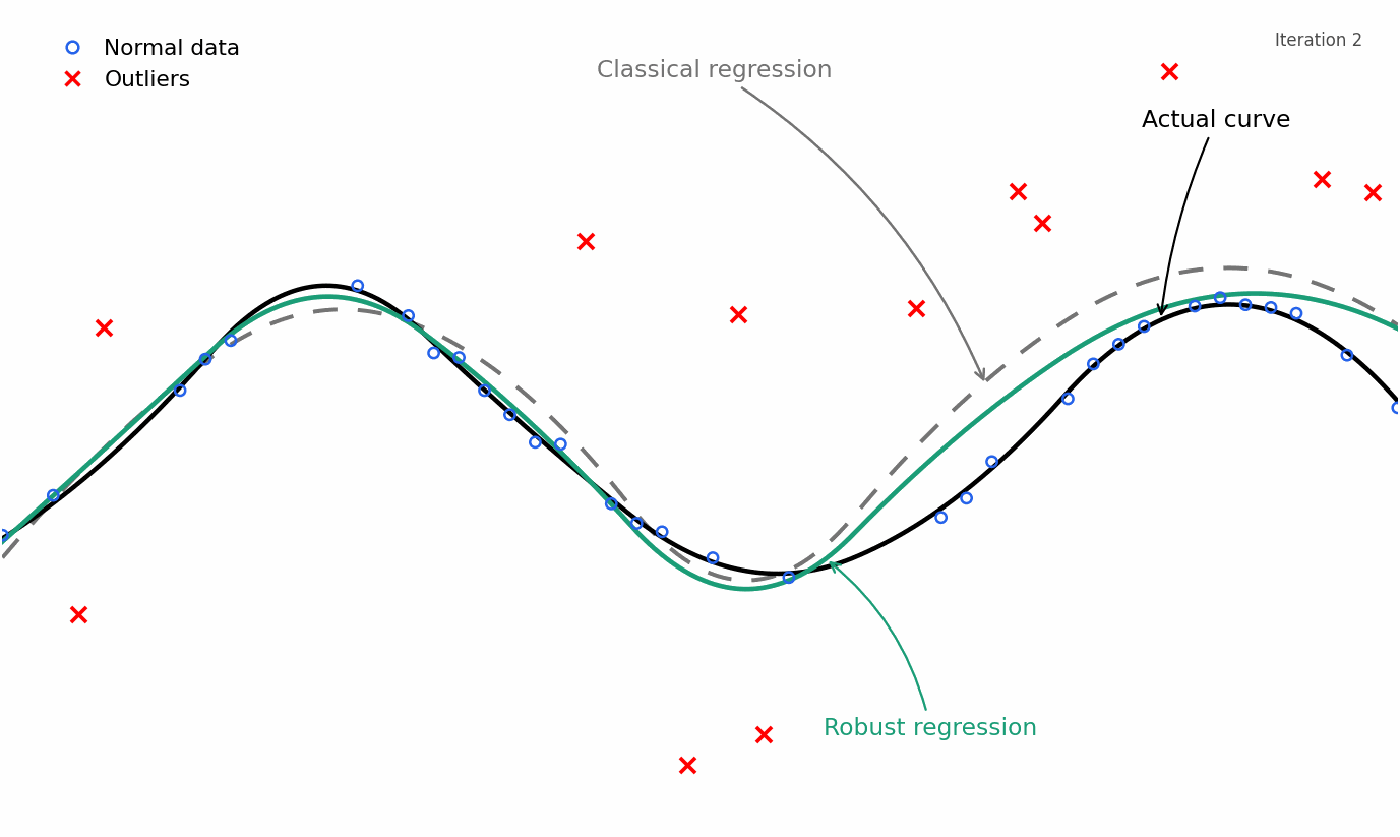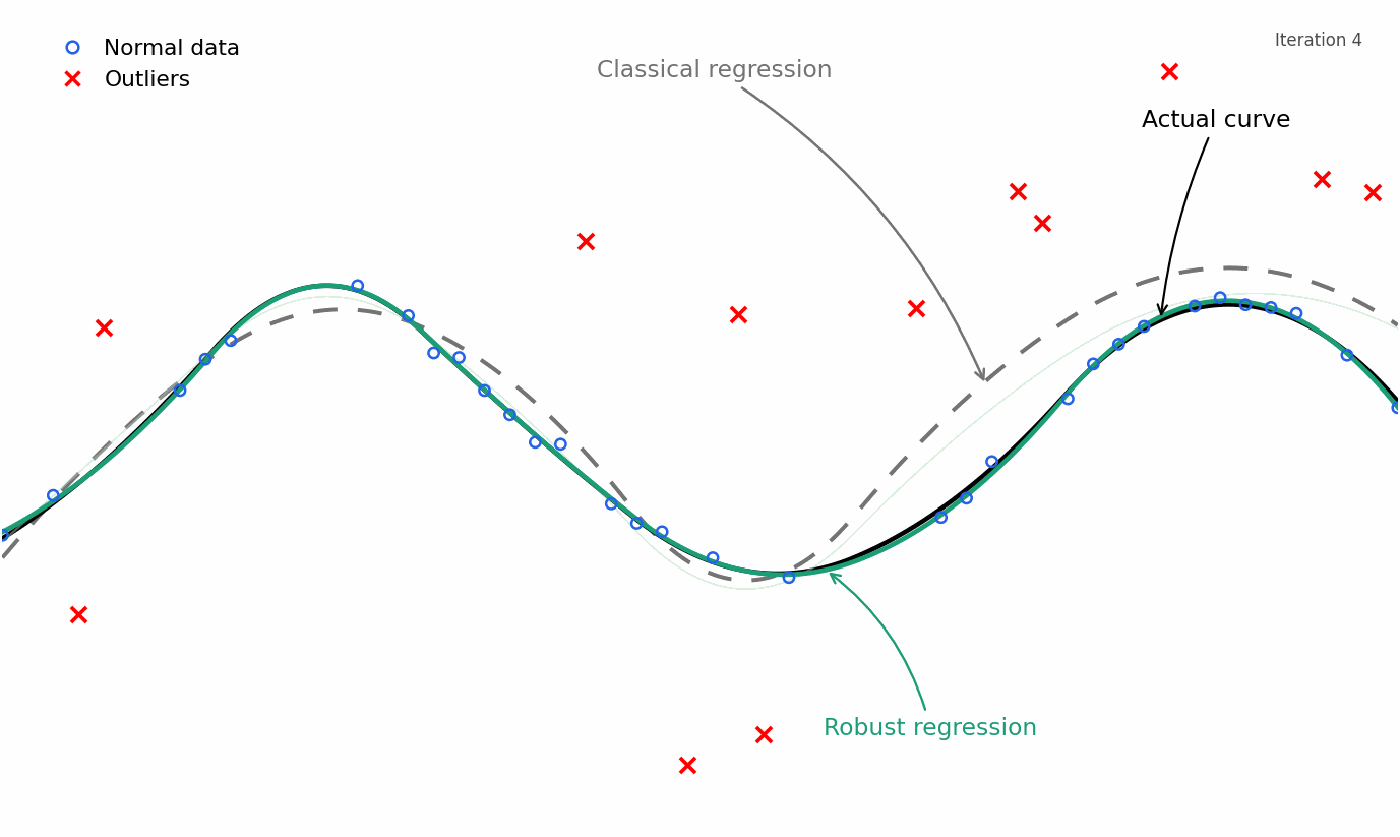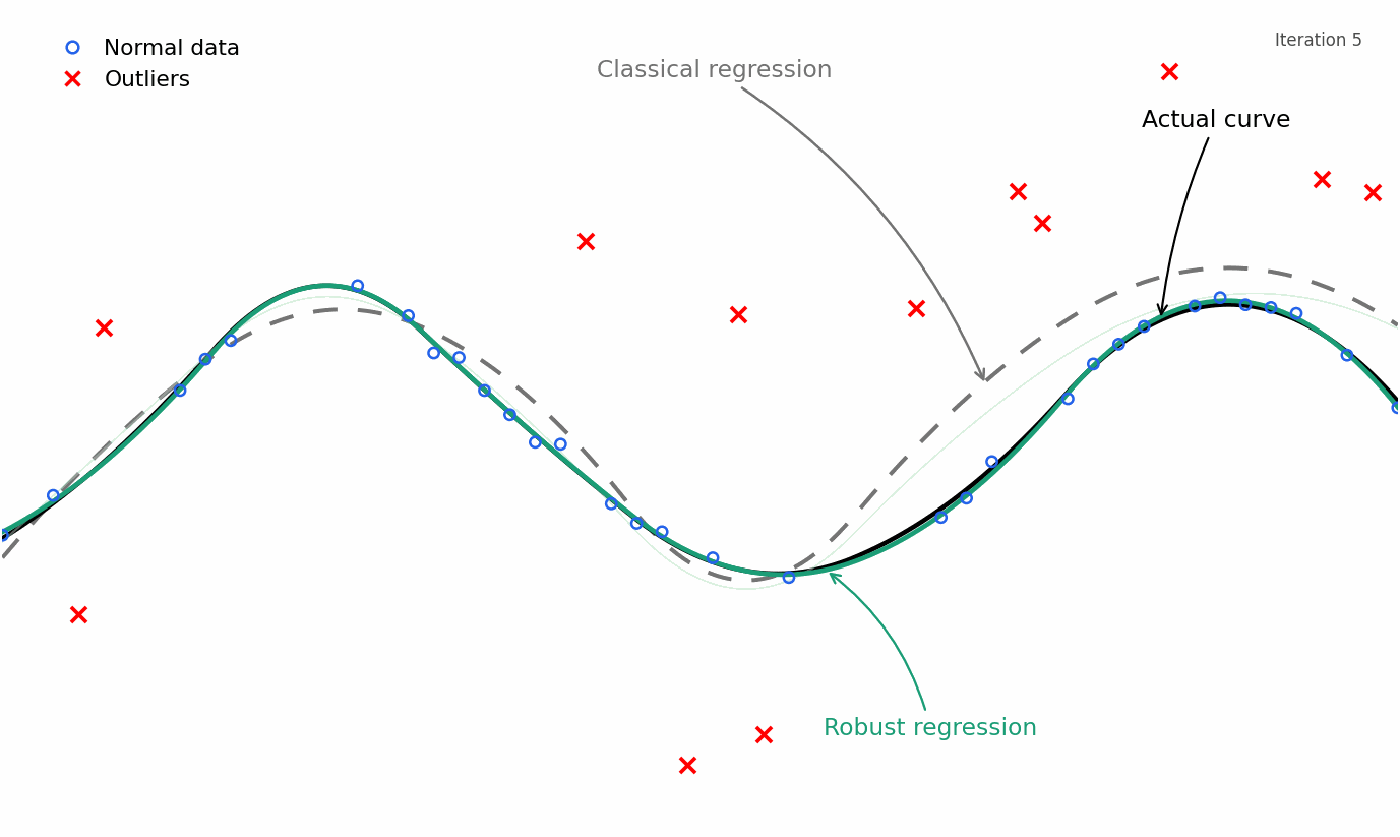
L'article illustre la question de la confiance par un exemple non linéaire. Avec des données propres, l'OLS suit de près la relation sous-jacente. Lorsque 30 % des réponses sont contaminées, l'ajustement OLS s'éloigne fortement de la courbe réelle, alors qu'un ajustement robuste reste beaucoup plus proche de celle-ci. La régression polynomiale est ensuite présentée comme un modèle linéaire dans un espace de caractéristiques transformé, dont les coefficients sont estimés par moindres carrés sur une matrice de conception.
Source: Towards Data Science · Résumé par HeadlinesBriefing