
A regressão linear é popular por sua simplicidade, rapidez e interpretabilidade, mas as relações reais costumam se curvar, achatar ou mudar de uma região para outra. A distância de frenagem, a resposta das colheitas, a potência de turbinas eólicas e o efeito Doppler de satélites mostram todos uma curvatura que uma reta não consegue capturar.
O artigo anterior desta série comparou o OLS com a regressão de Huber, RANSAC, GNC-GM, GNC-TLS e ASOR para observar como um ajuste de reta reage quando observações contaminadas o afastam da relação nominal. Este capítulo mantém o mesmo problema de robustez, mas dá ao modelo mais flexibilidade.
Duas perguntas orientam a abordagem. O estimador controla quais observações são confiáveis, enquanto a base controla quais formas o modelo pode representar. Os atributos polinomiais são um primeiro passo natural, mas sua flexibilidade é global: alterar um único coeficiente remodela a curva em todos os pontos. Já as splines introduzem flexibilidade localmente.
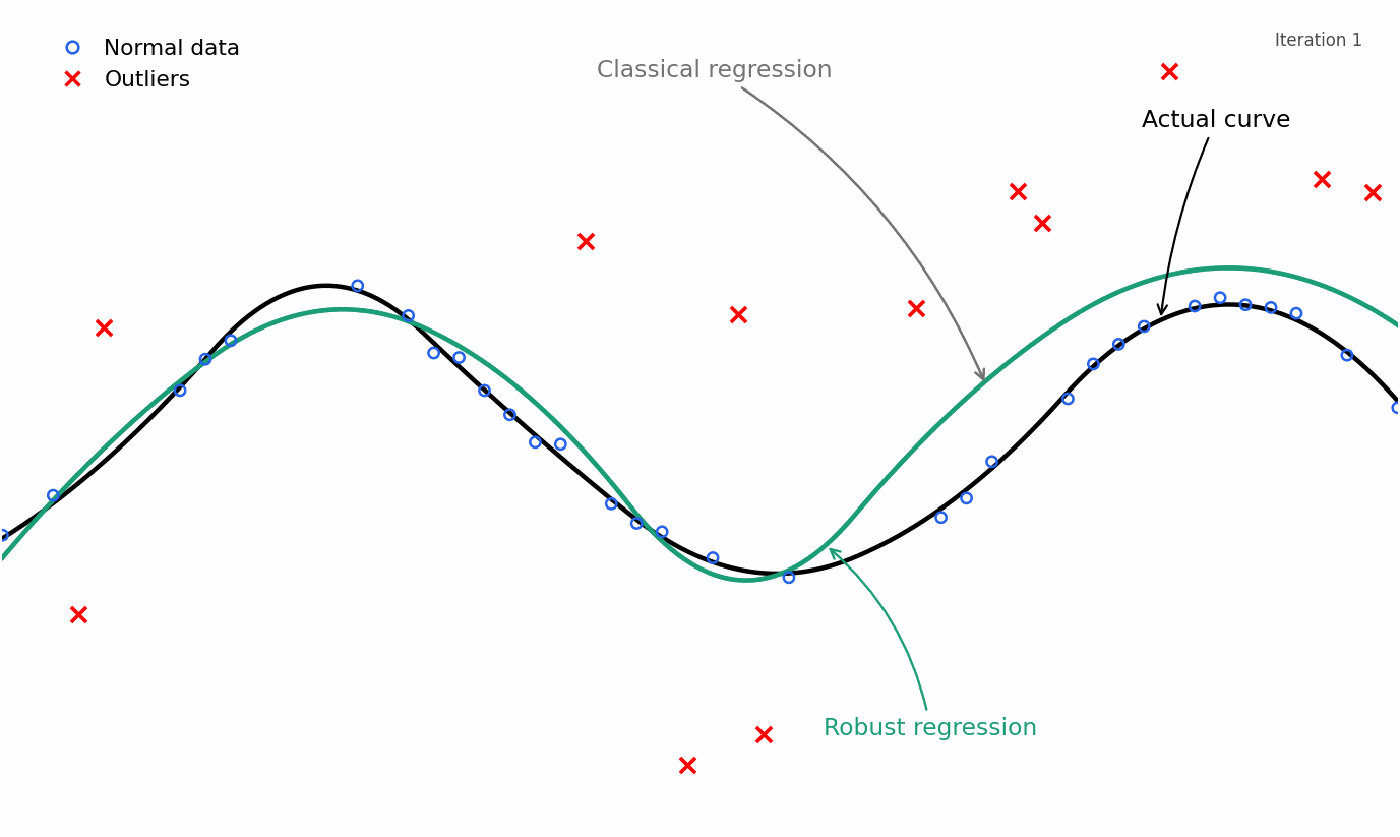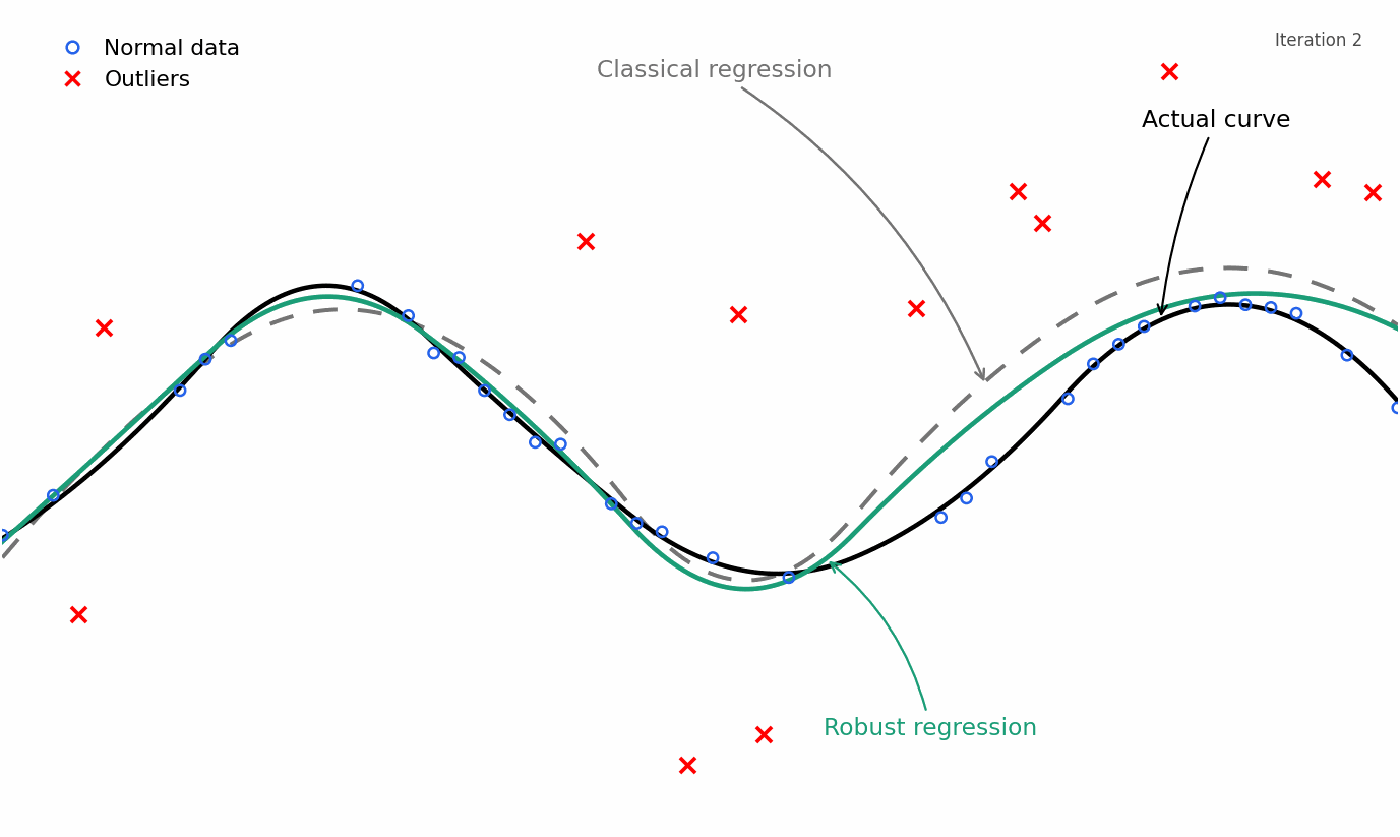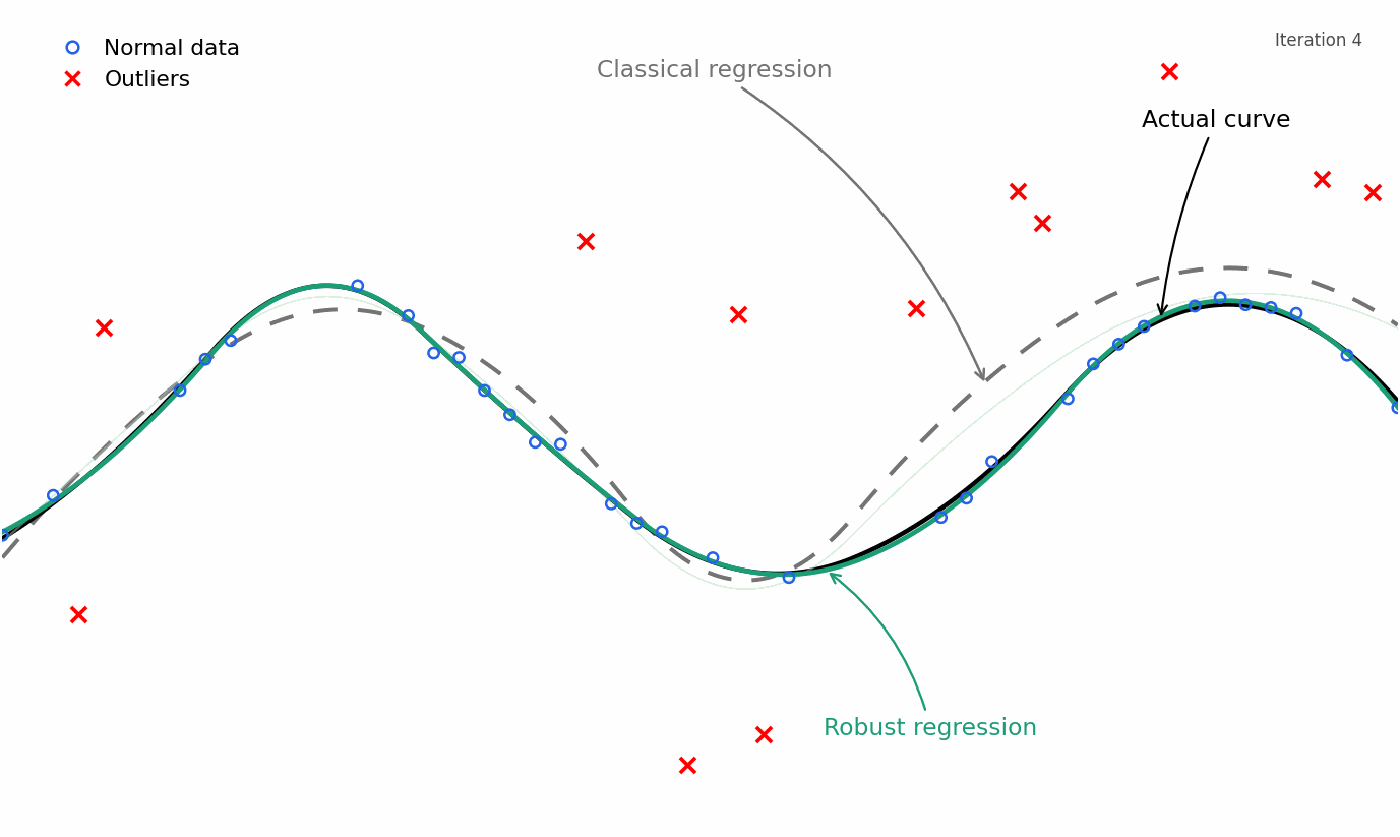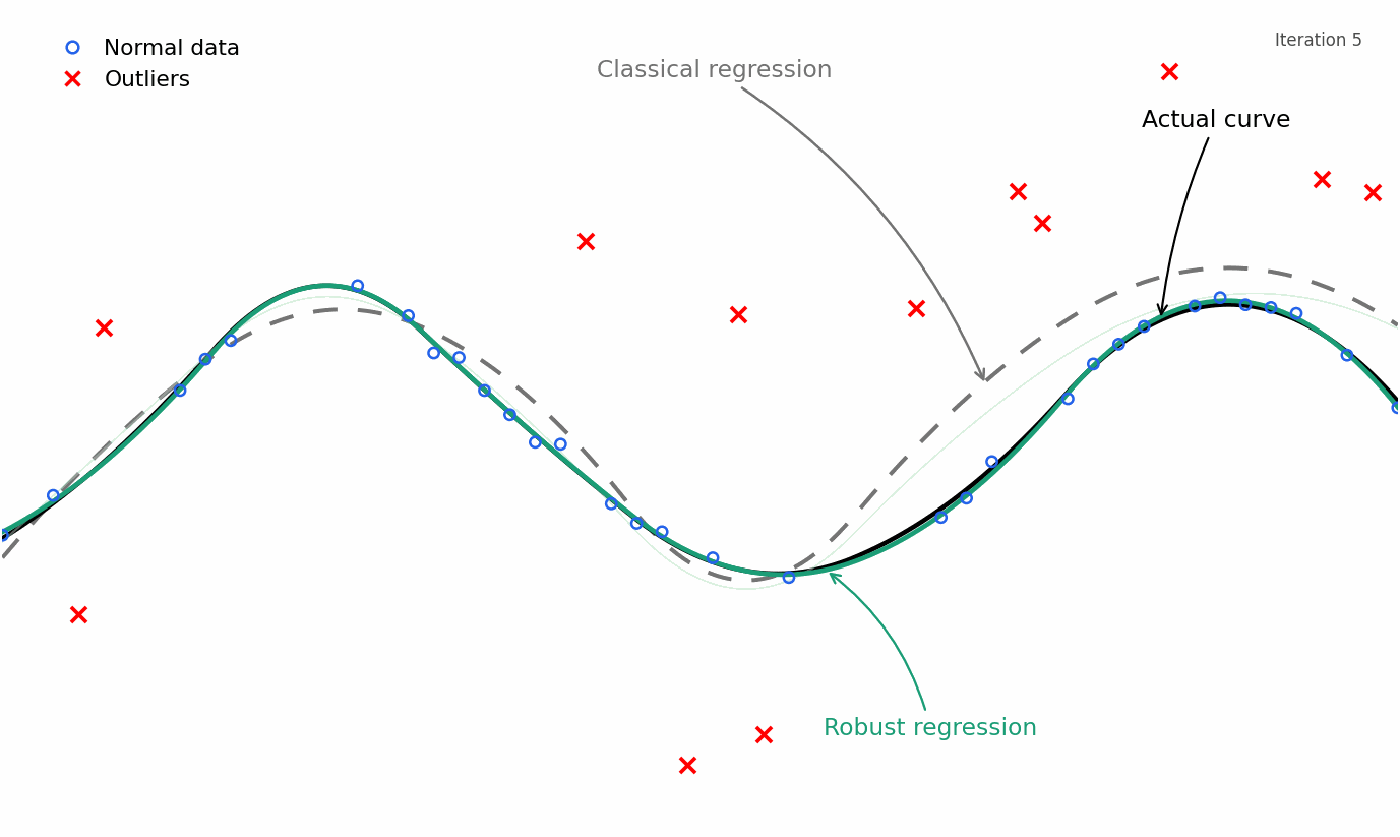
O artigo ilustra a questão da confiança com um exemplo não linear. Com dados limpos, o OLS acompanha de perto a relação subjacente. Depois que 30% das respostas são contaminadas, o ajuste do OLS se afasta muito da curva verdadeira, enquanto um ajuste robusto permanece bem mais próximo dela. A regressão polinomial é então apresentada como um modelo linear em um espaço de atributos transformado, com coeficientes estimados por mínimos quadrados sobre uma matriz de planejamento.
Fonte: Towards Data Science · Resumido por HeadlinesBriefing