
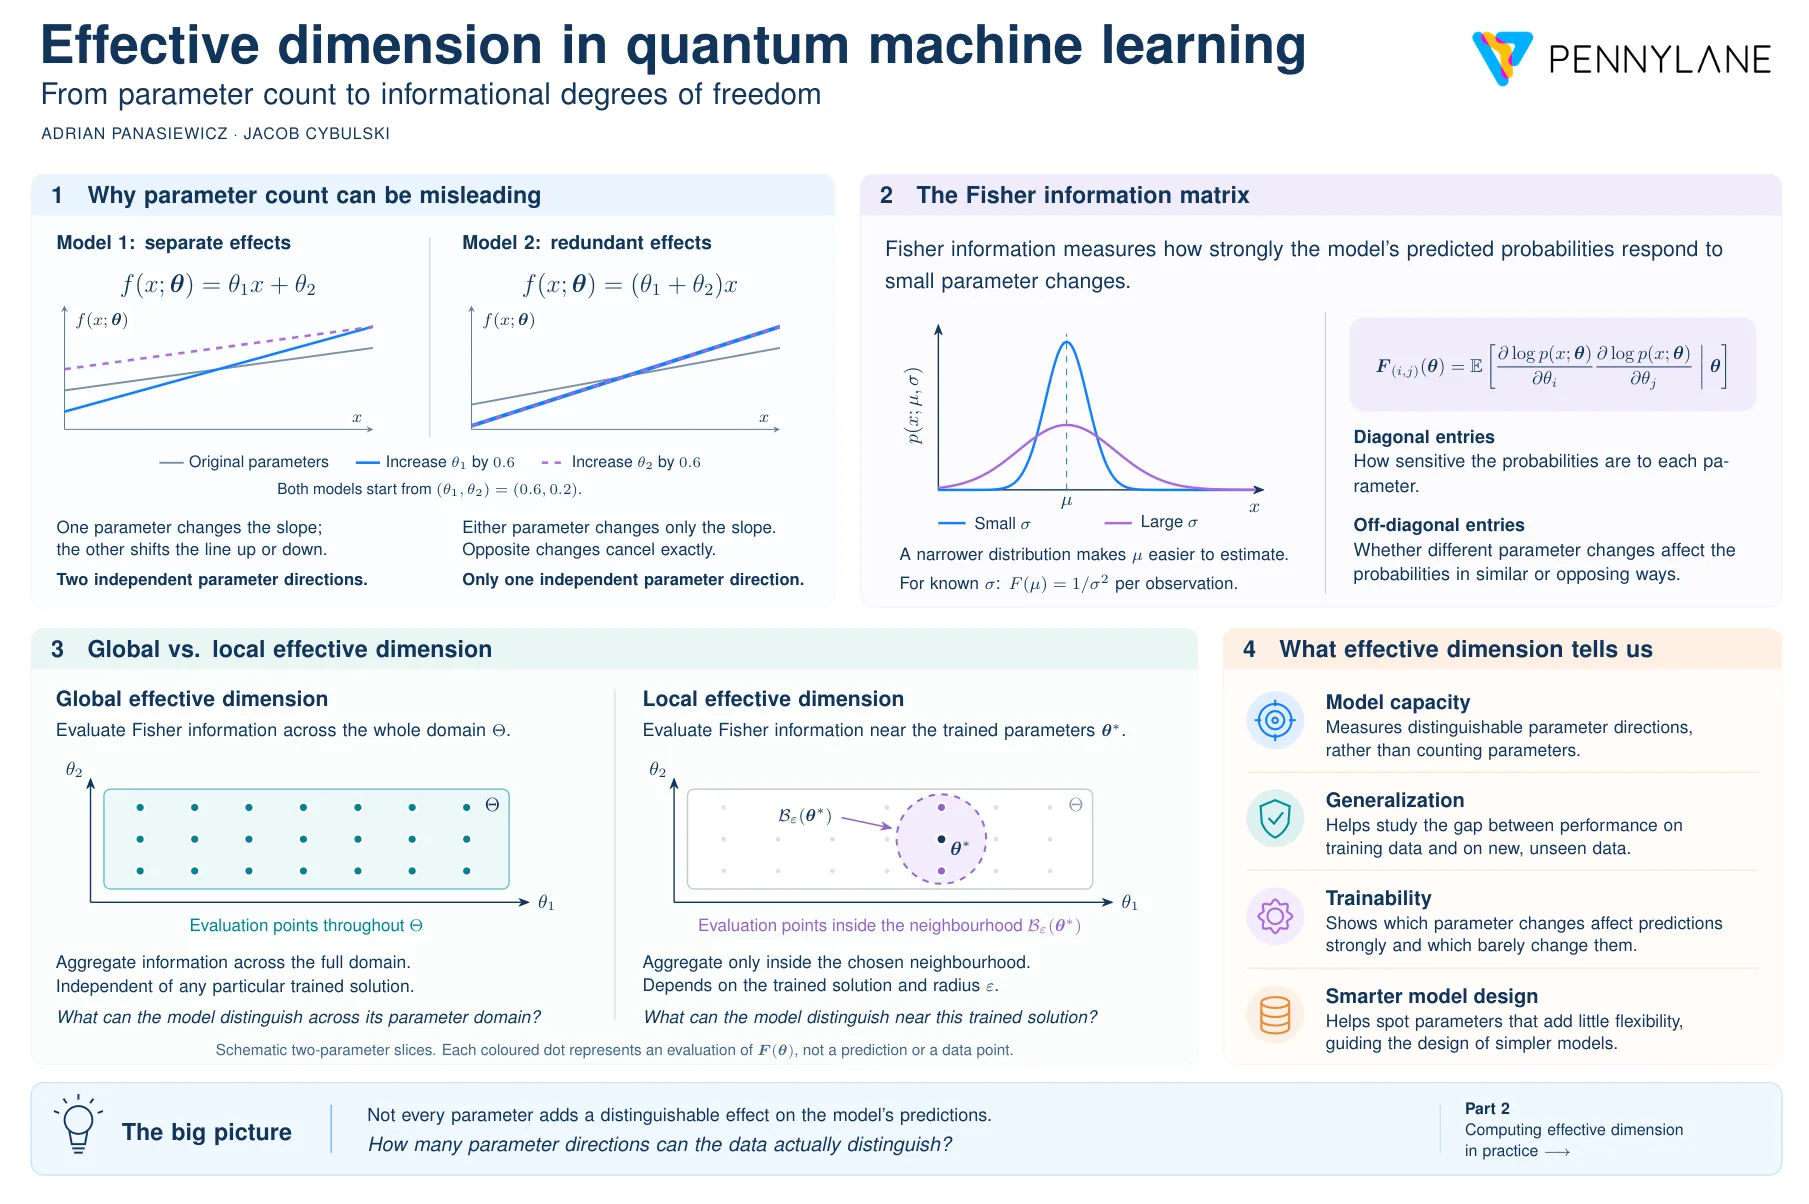
Les modèles d'apprentissage automatique sont généralement décrits par leur nombre de paramètres entraînables, mais ce chiffre peut être trompeur. Un modèle peut contenir de nombreux paramètres qui ne créent pas de véritables moyens indépendants d'influencer sa sortie, tandis qu'un modèle compact peut utiliser presque chaque paramètre de manière distincte et significative. La dimension effective est un moyen de quantifier cette différence.
Considérons deux modèles dotés des paramètres θ1 et θ2. Dans le premier, les paramètres agissent indépendamment sur la sortie, de sorte que le modèle peut varier selon deux directions indépendantes. Dans le second, la sortie ne dépend que de leur somme, si bien que de nombreuses paires de paramètres produisent exactement la même fonction. Bien que le modèle comporte formellement deux paramètres, il ne possède qu'un seul degré de liberté. Cela illustre l'idée centrale : le nombre de paramètres ne représente pas nécessairement la complexité fonctionnelle.
La dimension effective est une mesure de complexité informationnelle dépendante de l'échelle, initialement développée dans la théorie statistique de l'information pour dénombrer les paramètres réellement actifs d'un modèle en fonction de la taille des données disponibles. Elle a depuis été adoptée en apprentissage automatique classique et quantique pour évaluer l'expressivité d'un modèle, sa capacité d'entraînement et sa capacité de généralisation. Contrairement à la précision, à la perte ou au nombre brut de paramètres, elle demande combien de directions de paramètres distinctes un modèle possède dans une région de paramètres et une distribution de données données.
Fait important, la dimension effective est liée à la généralisation. Sous les hypothèses de ce cadre, elle peut fournir une borne de performance de généralisation dépendant de la complexité. Il s'agit de la première partie d'une série en deux volets ; la seconde partie montrera comment mettre en œuvre les calculs de dimension effective dans les expériences d'apprentissage automatique.
Source: Towards Data Science · Résumé par HeadlinesBriefing