
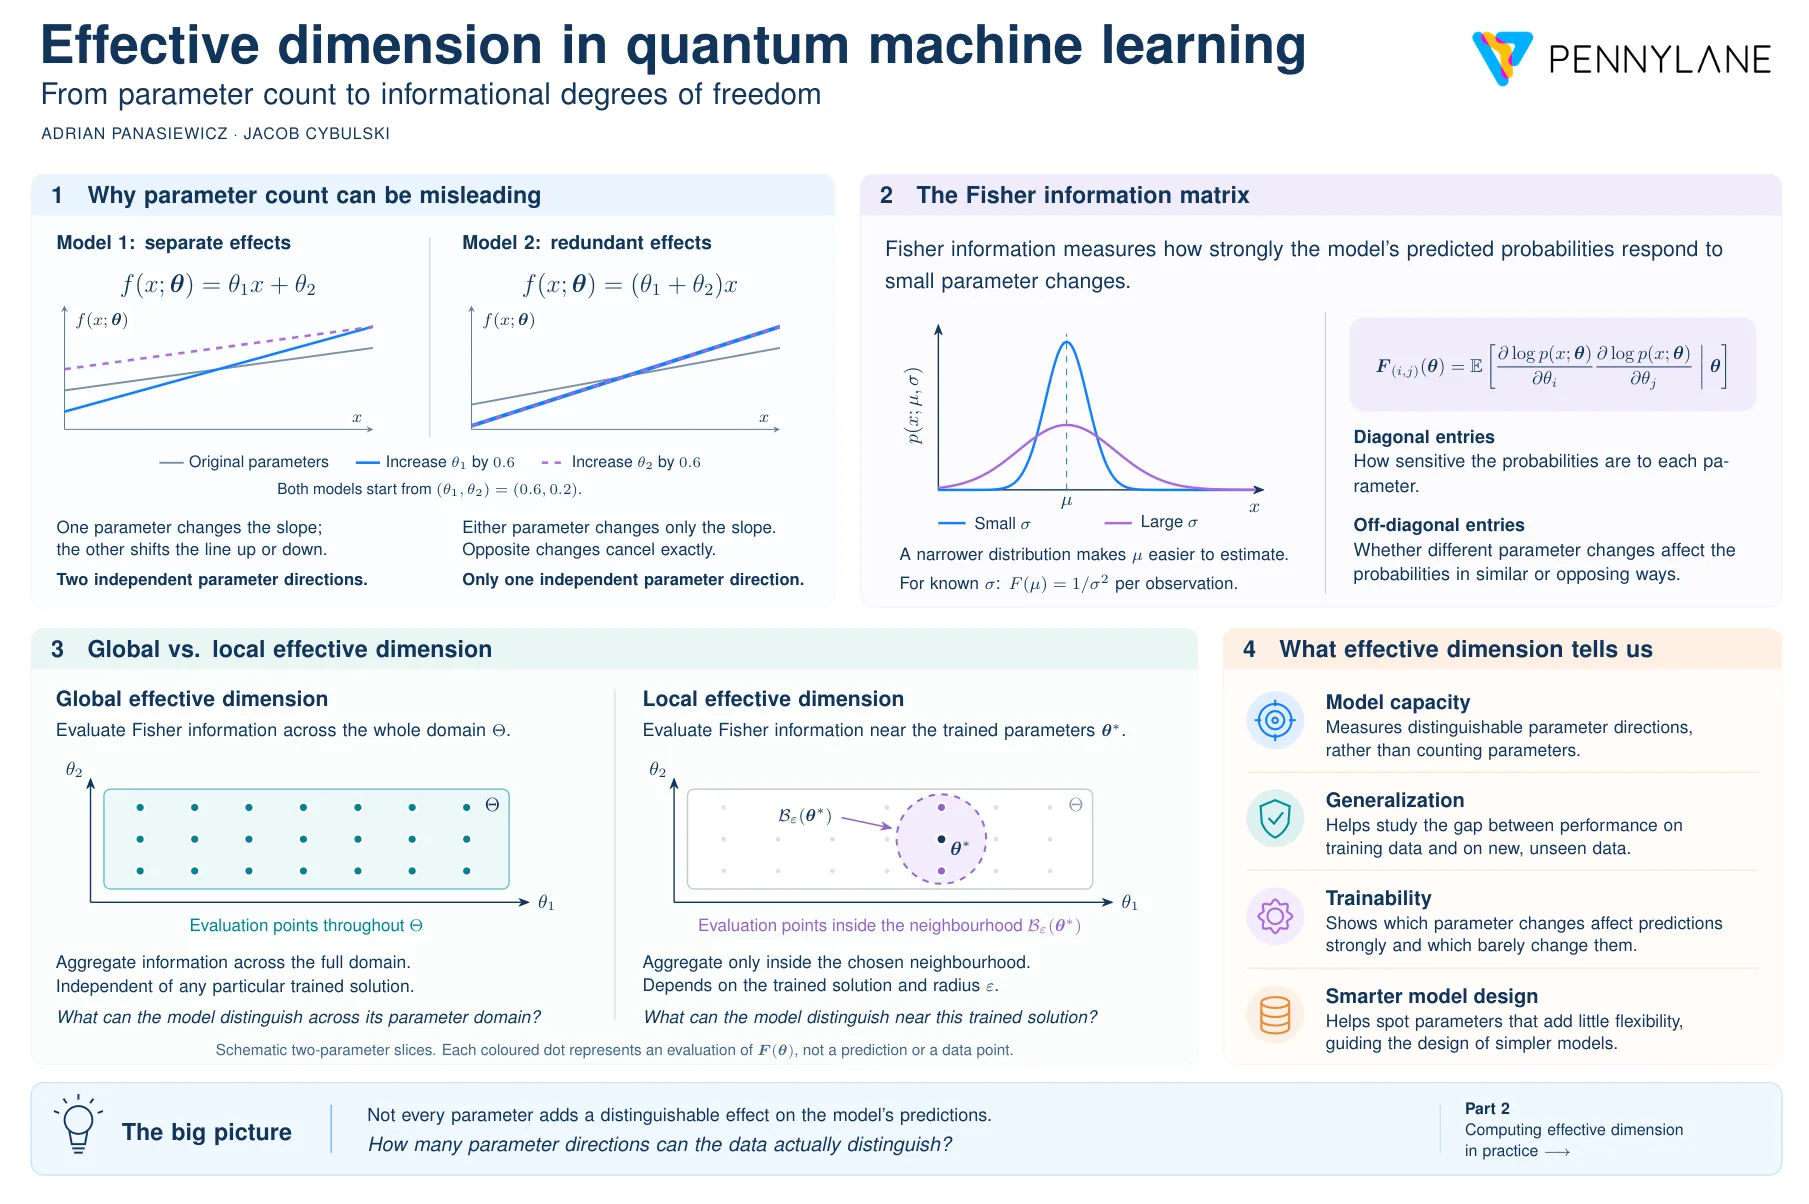
Los modelos de aprendizaje automático suelen describirse por su número de parámetros entrenables, pero esa cifra puede resultar engañosa. Un modelo puede contener muchos parámetros que no crean formas genuinamente independientes de influir en su salida, mientras que un modelo compacto puede utilizar casi todos sus parámetros de manera distinta y significativa. La dimensión efectiva es una forma de cuantificar esa diferencia.
Consideremos dos modelos con parámetros θ1 y θ2. En el primero, los parámetros afectan la salida de forma independiente, por lo que el modelo puede variar en dos direcciones independientes. En el segundo, la salida depende únicamente de su suma, por lo que muchos pares de parámetros producen exactamente la misma función. Aunque el modelo tiene formalmente dos parámetros, solo tiene un grado de libertad. Esto ilustra la idea central: el número de parámetros no representa necesariamente la complejidad funcional.
La dimensión efectiva es una medida de complejidad informacional dependiente de la escala, desarrollada originalmente en la teoría estadística de la información para contar los parámetros realmente activos de un modelo según el tamaño de los datos disponibles. Desde entonces se ha adoptado en el aprendizaje automático clásico y cuántico para evaluar la expresividad, la entrenabilidad y la capacidad de generalización de un modelo. A diferencia de la precisión, la pérdida o el número bruto de parámetros, pregunta cuántas direcciones de parámetros distinguibles tiene un modelo dentro de una región de parámetros y una distribución de datos elegidas.
De forma importante, la dimensión efectiva está relacionada con la generalización. Bajo los supuestos del marco, puede proporcionar una cota de rendimiento de generalización que depende de la complejidad. Esta es la primera parte de una serie de dos partes; la segunda mostrará cómo implementar los cálculos de dimensión efectiva en experimentos de aprendizaje automático.
Fuente: Towards Data Science · Resumido por HeadlinesBriefing