
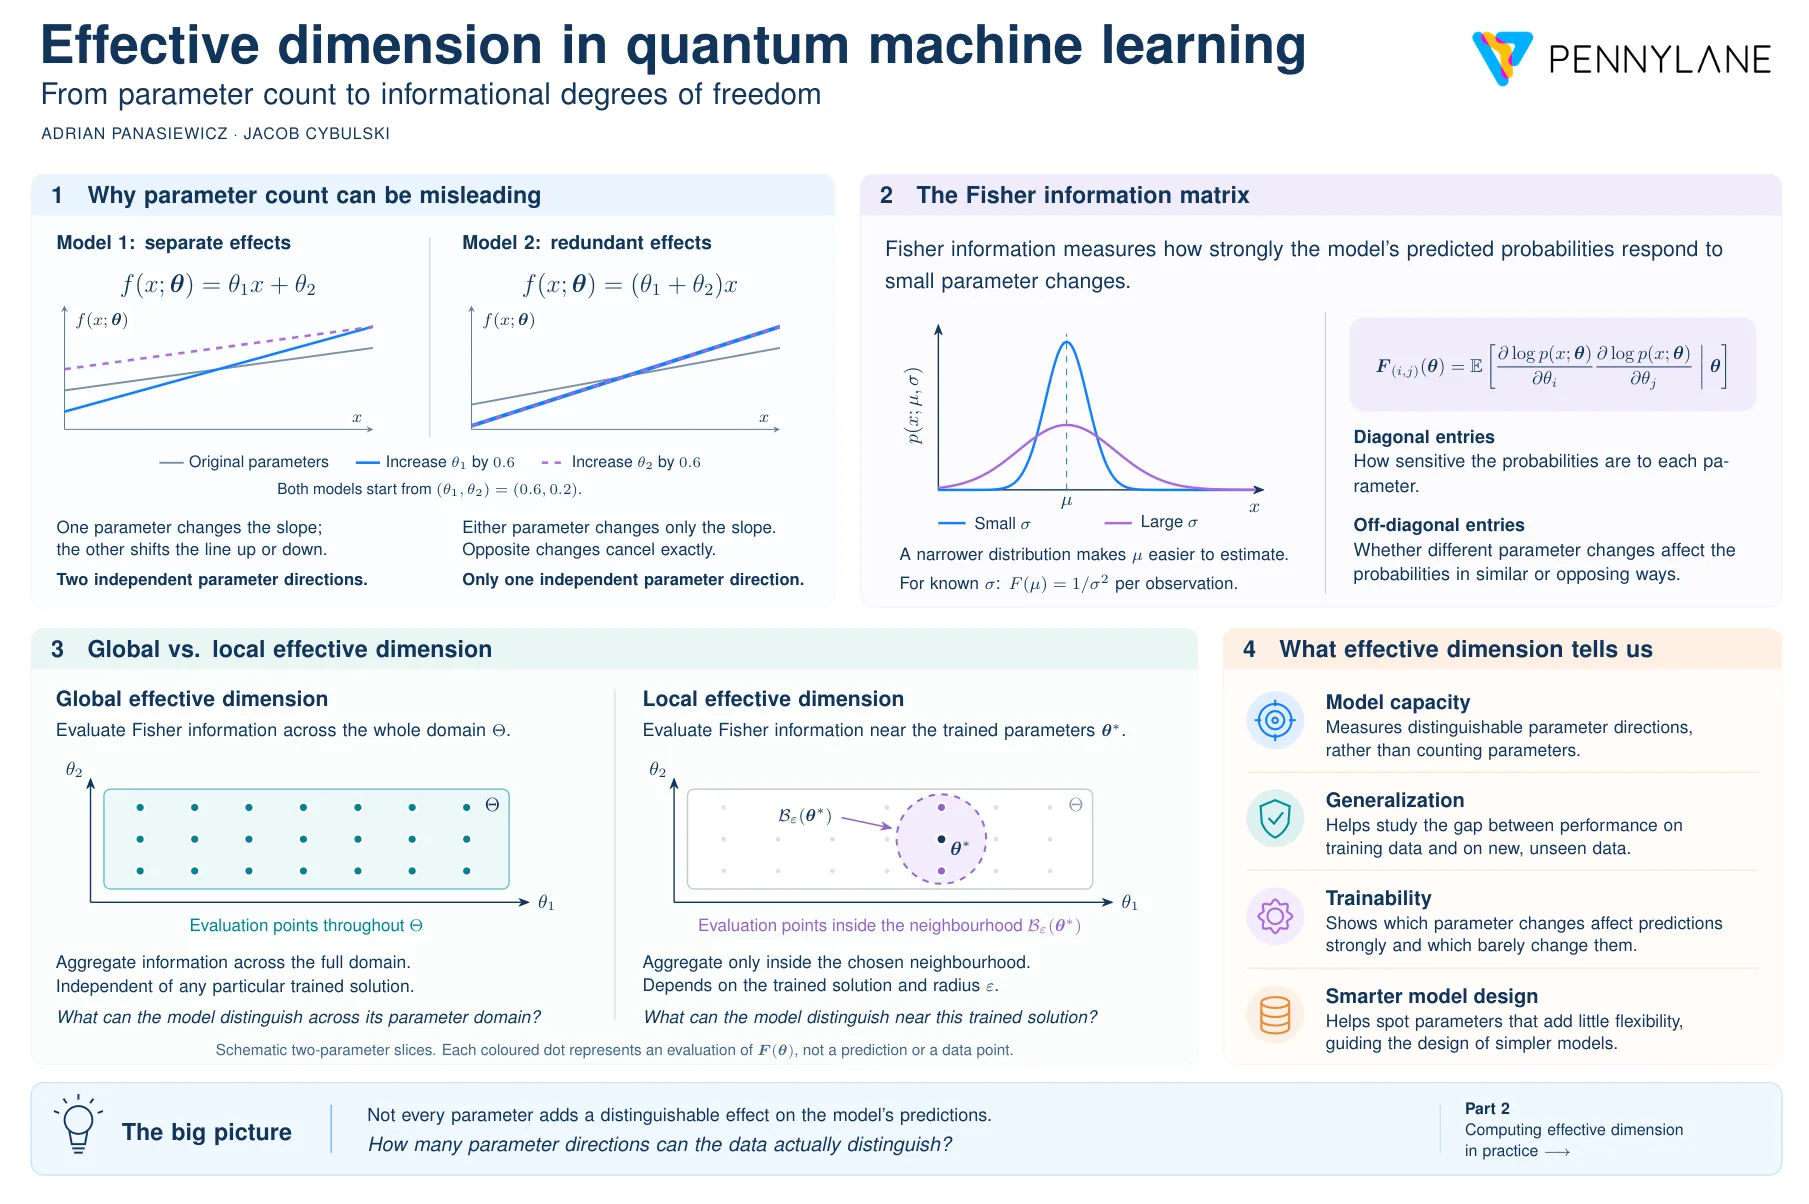
機械学習モデルは一般に学習可能なパラメータの数で説明されますが、その数字は誤解を招くことがあります。出力に独立して影響を与える真の方法を生み出さないパラメータを多く含むモデルがある一方で、コンパクトなモデルはほぼすべてのパラメータを明確で意味のある方法で使っている場合があります。実効次元は、その違いを定量化する方法です。
パラメータθ1とθ2を持つ2つのモデルを考えてみましょう。1つ目のモデルでは、パラメータは出力に独立して影響するため、モデルは2つの独立した方向に変化できます。2つ目のモデルでは、出力は両者の和のみに依存するため、多くのパラメータの組み合わせが全く同じ関数を生み出します。形式上このモデルはパラメータを2つ持ちますが、自由度は1つしかありません。これは中心的な考え方を示しています。パラメータ数は必ずしも関数的な複雑さを表すわけではないということです。
実効次元は、スケールに依存する情報複雑性の尺度であり、もともと統計的情報理論において、利用可能なデータの大きさに基づいて、モデルの中で実際に機能しているパラメータを数えるために開発されました。その後、古典的な機械学習と量子機械学習の両方で採用され、モデルの表現力、学習可能性、汎化能力を評価するために用いられています。精度、損失、あるいは単純なパラメータ数とは異なり、選ばれたパラメータ領域とデータ分布の中で、モデルがいくつの区別可能なパラメータ方向を持つかを問います。
重要なのは、実効次元が汎化と関係していることです。この枠組みの仮定のもとで、実効次元は汎化性能に関する複雑さ依存の上界を与えることができます。これは2部構成のシリーズの第1部であり、第2部では機械学習の実験において実効次元の計算を実装する方法を示します。
出典: Towards Data Science · 要約:HeadlinesBriefing