
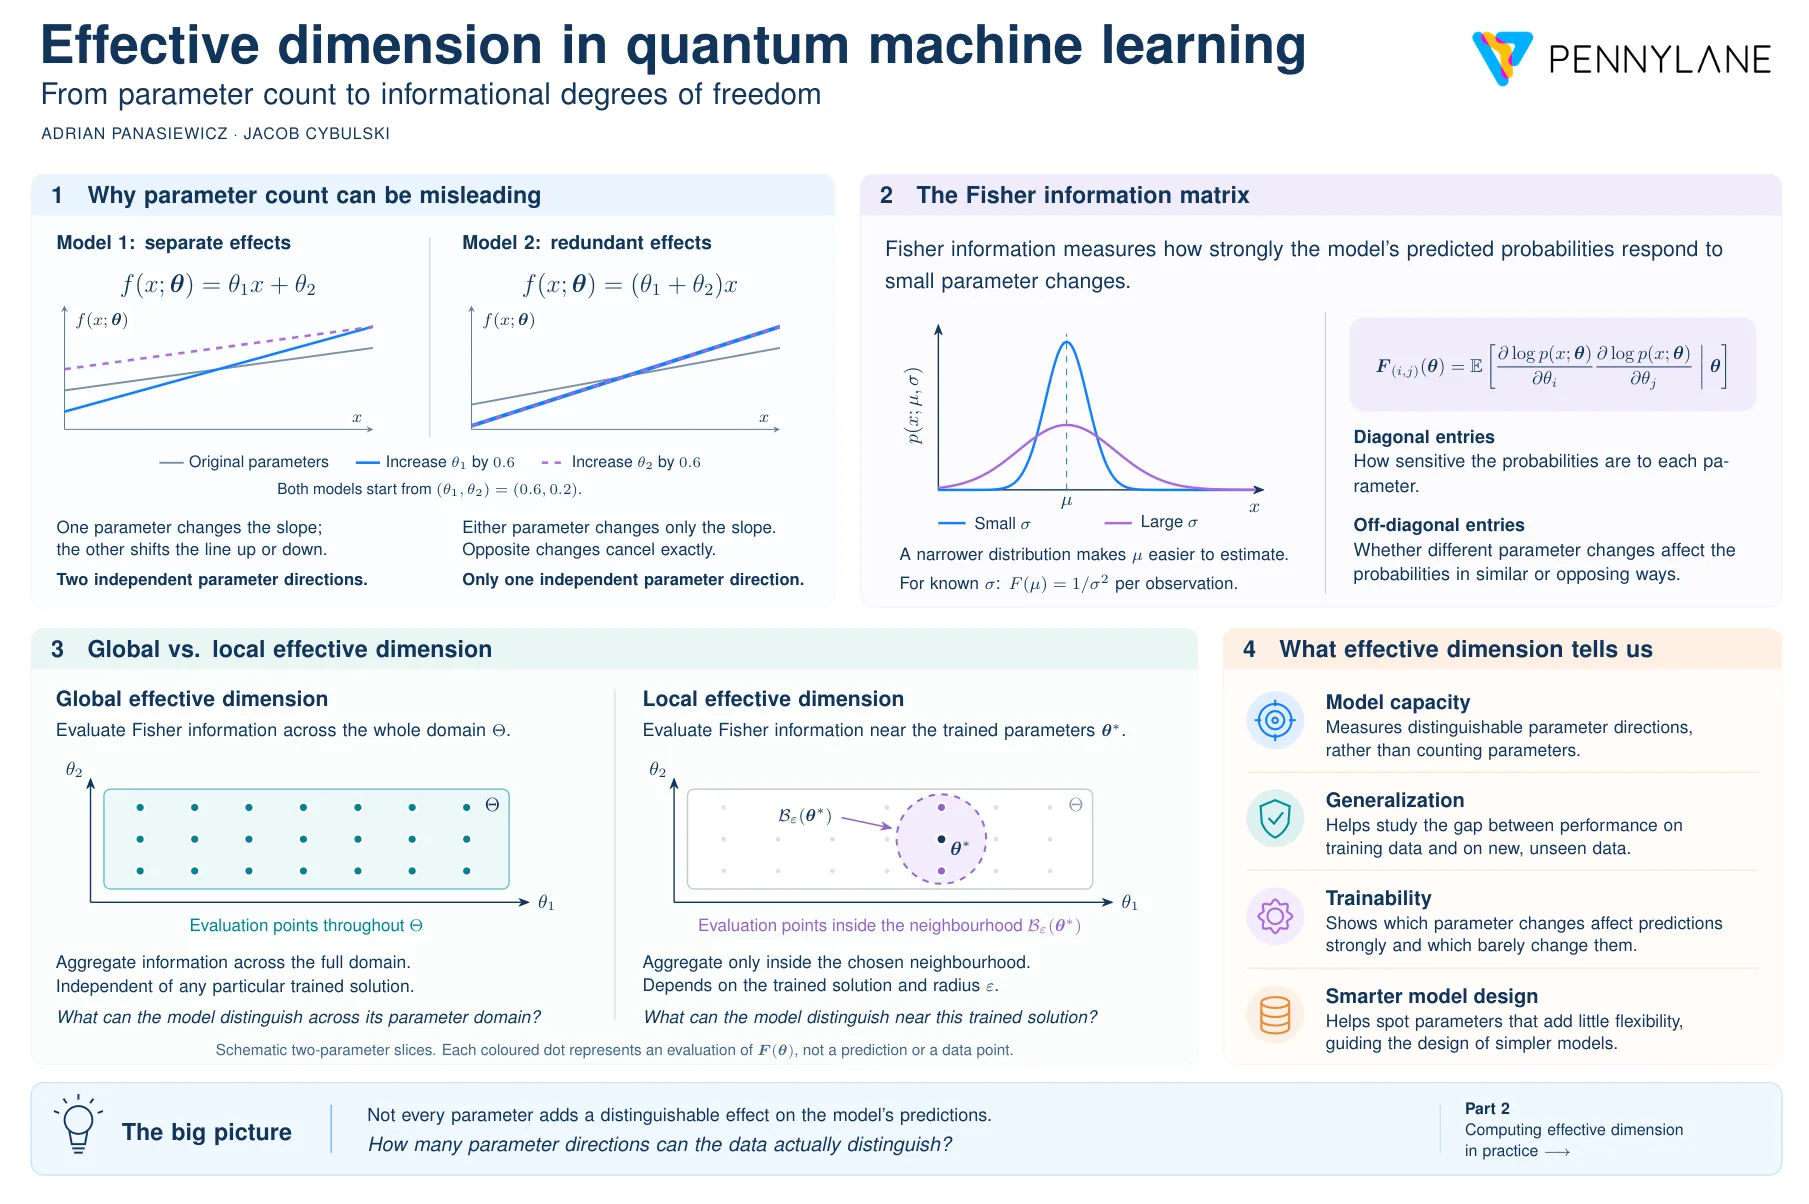
机器学习模型通常以其可训练参数的数量来描述,但这一数字可能具有误导性。某些模型包含许多参数,但这些参数并未形成真正独立的影响输出的方式;而一个紧凑的模型则可能以独特且有意义的方式利用几乎每一个参数。有效维度是量化这种差异的一种方法。
以参数θ1和θ2为例的两个模型。在第一个模型中,参数对输出的影响是相互独立的,因此模型可以在两个独立的方向上变化。在第二个模型中,输出仅取决于二者之和,因此许多参数组合会产生完全相同的函数。尽管该模型形式上有两个参数,但它实际上只有一个自由度。这说明了核心观点:参数数量不一定代表功能复杂度。
有效维度是一种与尺度相关的信息复杂度度量,最初在统计信息论中提出,用于根据可用数据的规模计算模型中真正起作用的参数数量。此后,它被引入经典机器学习和量子机器学习领域,用于评估模型的表达能力、可训练性以及泛化能力。与准确率、损失值或原始参数数量不同,它关注的是在选定的参数区域和数据分布下,模型具有多少个可区分的参数方向。
重要的是,有效维度与泛化能力密切相关。在该框架的假设条件下,它可以给出一个与复杂度相关的泛化性能界限。这是两部分系列文章的第一部分;第二部分将展示如何在机器学习实验中实现有效维度的计算。
来源: Towards Data Science · 由HeadlinesBriefing整理摘要