
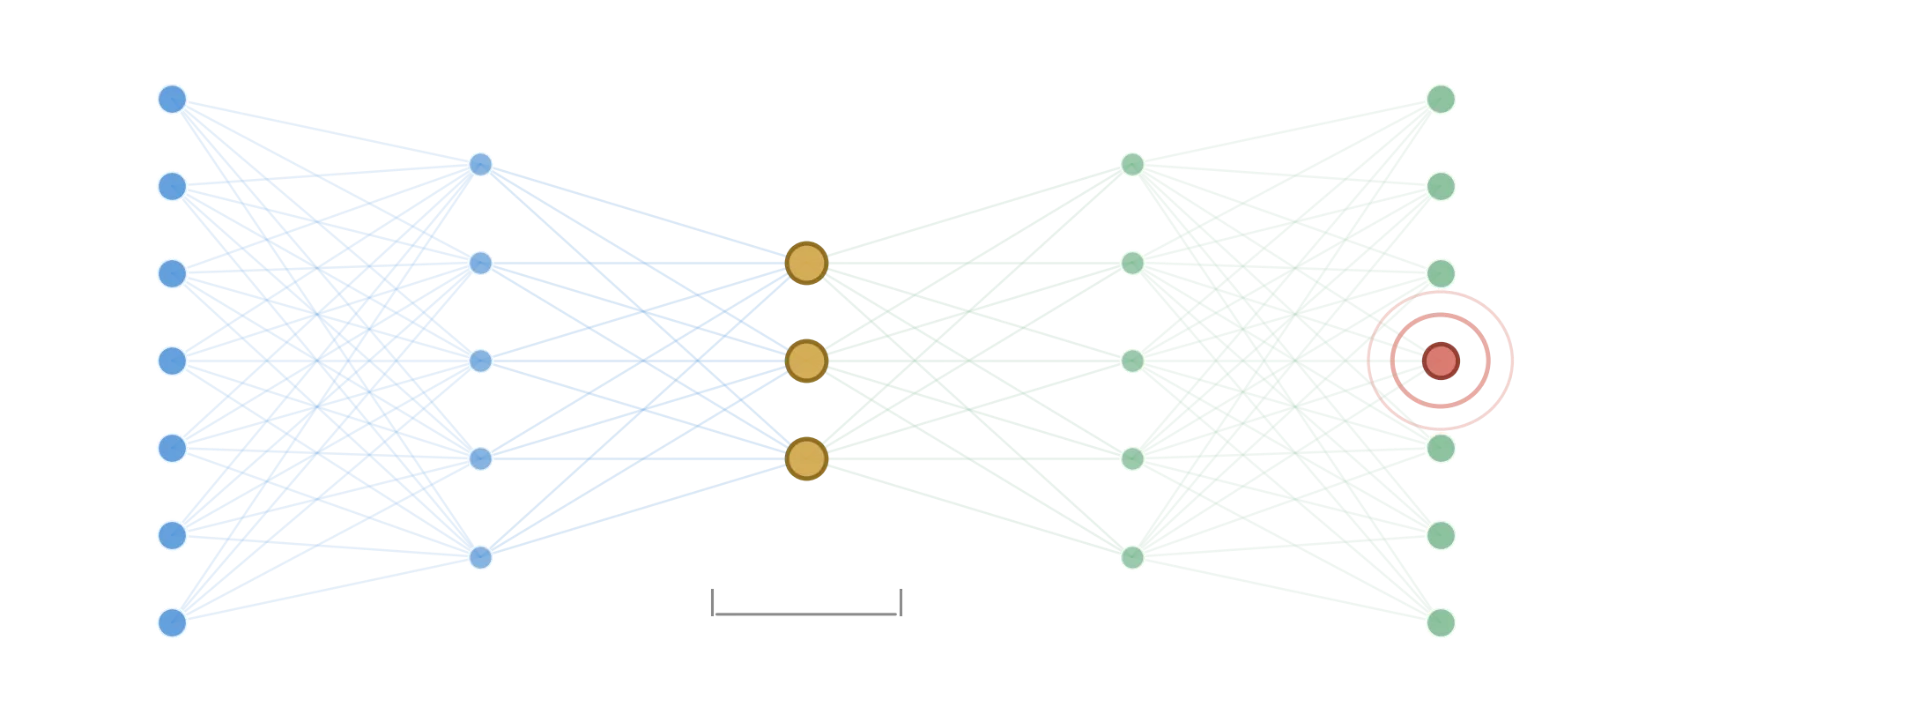
一个理论优势未能在实际基准测试中存活。自编码器的理论论证很清晰:仅用正常数据训练网络,它能很好地重构正常模式。与只能捕捉线性关系的PCA不同,自编码器可以学习非线性关系——因此它应该能捕捉违反非线性结构的异常。我构建了两个实验——一个简单案例,另一个故意设计成对自编码器最有利的情况——并测量了理论优势是否真正显现。
设置:合成数据,仅用正常样本训练,在保留的正常和异常混合样本上评估。比较三种方法:自编码器(MLPRegressor,具有3维瓶颈)、PCA重构误差(也缩减到3个分量)和孤立森林。实验1:来自高斯簇的正常数据,具有偏移均值和更高方差的异常。PCA匹配或击败了自编码器——两者均为0.885 F1,捕捉到所有异常(召回率=1.0)。孤立森林得分为0.870。
实验2:操纵测试以利于自编码器。我构建了专门对线性方法不可见的异常:两个特征遵循非线性关系(y = sin(3x) + 噪声)的正常数据,以及保持相同个体范围但违反它们之间关系的异常。这接近自编码器的最佳情况。
关键实体:公司:Towards Data Science
FAQ Q:为什么PCA即使在非线性异常检测测试中也匹配了自编码器?
FAQ A:因为在实验1中,均值偏移异常是线性现象,所以PCA没有结构劣势。在实验2中,尽管自编码器在理论上对非线性关系有利,但重构误差分离仍然足够大,使得线性方法的精度影响不大。
来源: Towards Data Science · 由HeadlinesBriefing整理摘要