
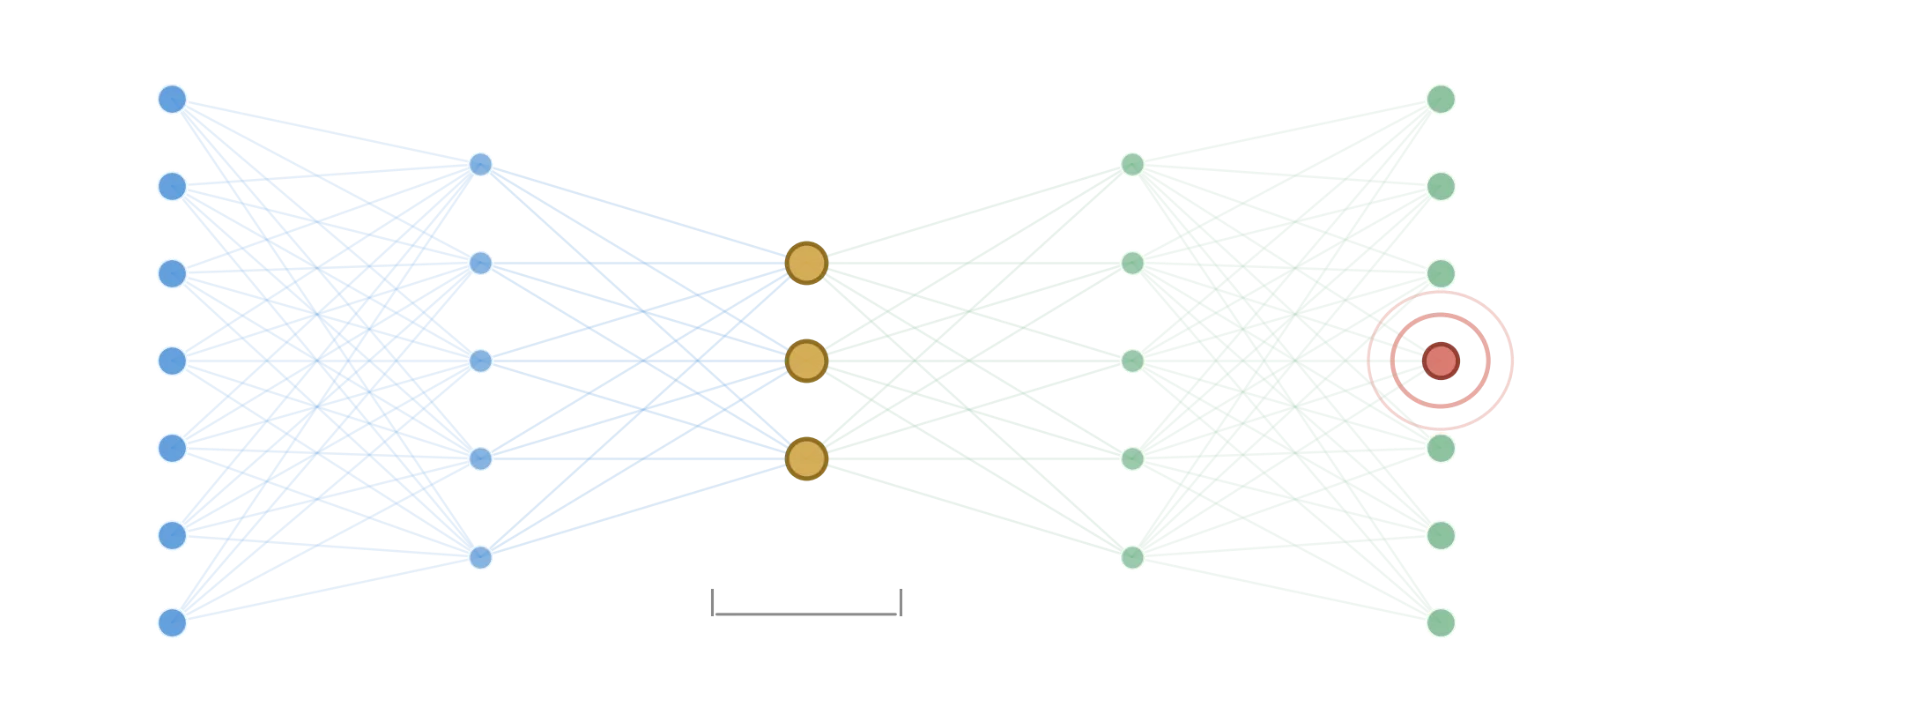
Uma vantagem teórica que não sobreviveu ao contato com um benchmark real. O caso teórico para autoencoders é claro: treinar a rede apenas com dados normais, e ela aprende a reconstruir padrões normais bem. Ao contrário do PCA, que só pode capturar relações lineares, um autoencoder pode aprender relações não lineares — então deve detectar anomalias que violem uma estrutura não linear. Construí dois experimentos — um caso fácil, e outro deliberadamente projetado para ser a melhor chance do autoencoder — e medi se a vantagem teórica realmente aparece.
Configuração: dados sintéticos, treinados apenas em amostras normais, avaliados em uma mistura reservada de amostras normais e anômalas. Três métodos comparados: um autoencoder (MLPRegressor com um gargalo de 3 dimensões), erro de reconstrução PCA (também reduzido a 3 componentes) e Isolation Forest. Experimento 1: dados normais de clusters gaussianos, anomalias com média deslocada e variância maior. PCA igualou ou superou o autoencoder — 0.885 F1 para ambos, capturando todas as anomalias (recall = 1.0). Isolation Forest veio com 0.870.
Experimento 2: manipulando o teste a favor do autoencoder. Construí anomalias especificamente invisíveis para um método linear: dados normais onde duas características seguem uma relação não linear (y = sin(3x) + ruído), e anomalias que mantêm a mesma faixa individual, mas violam a relação entre elas. Isso está próximo de um cenário ideal para o autoencoder.
Entidades-chave: Empresas: Towards Data Science
FAQ P: Por que o PCA igualou o autoencoder mesmo no teste de detecção de anomalias não lineares?
FAQ R: Porque no Experimento 1, a anomalia de deslocamento de média é um fenômeno linear, então o PCA não tinha desvantagem estrutural. No Experimento 2, embora o autoencoder fosse teoricamente favorecido para relações não lineares, a separação do erro de reconstrução ainda era grande o suficiente para que a precisão do método linear não importasse muito.
Fonte: Towards Data Science · Resumido por HeadlinesBriefing