
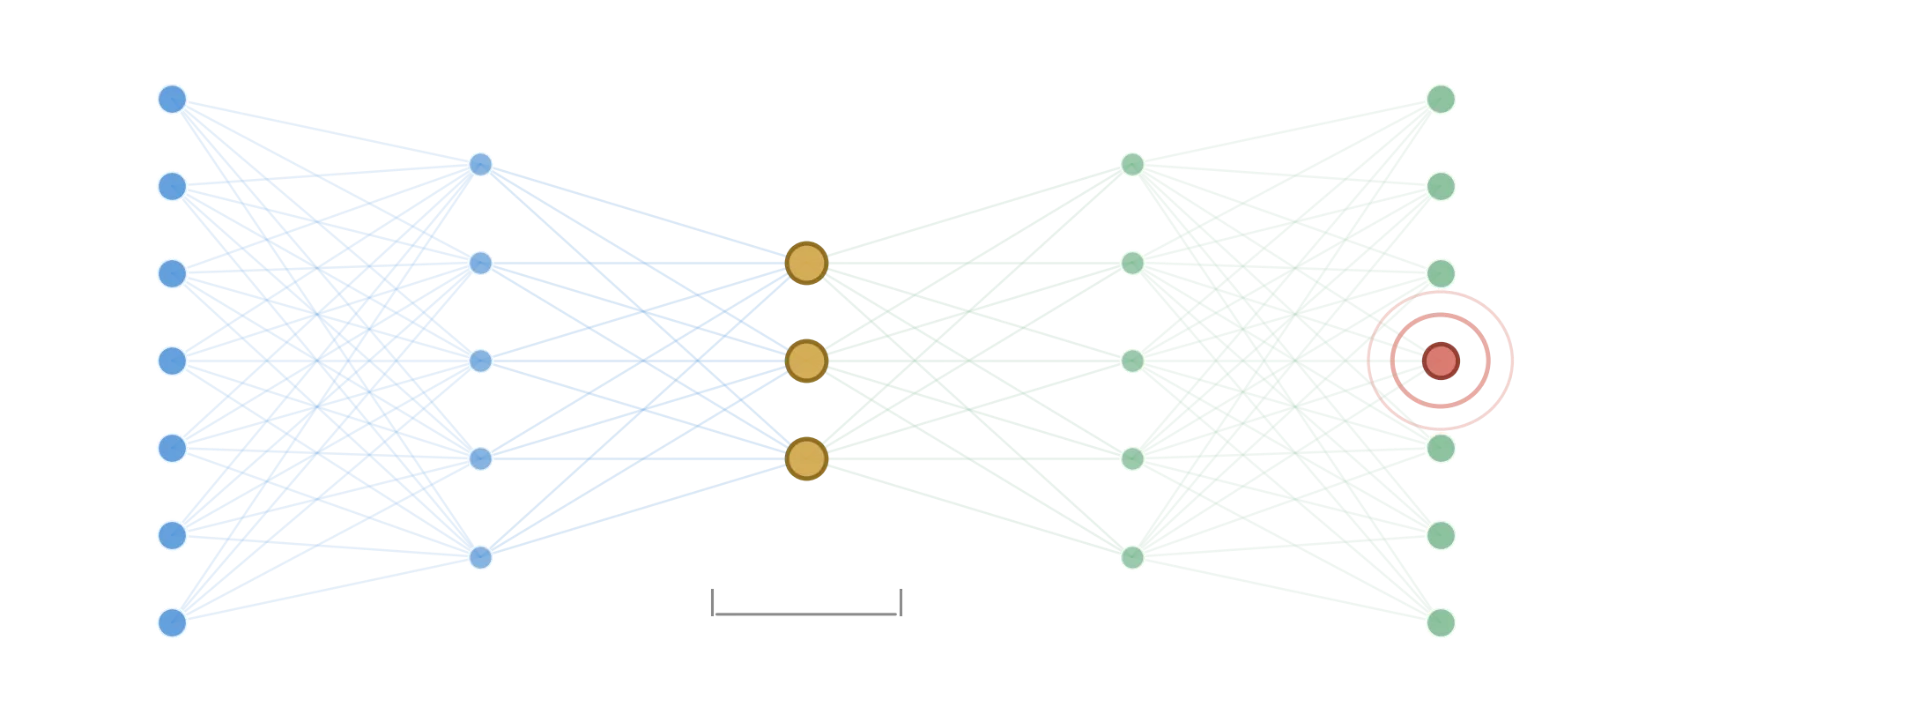
Ein theoretischer Vorteil, der den Kontakt mit einem echten Benchmark nicht überlebte. Der theoretische Fall für Autoencoder ist klar: Trainieren Sie das Netzwerk nur mit normalen Daten, und es lernt, normale Muster gut zu rekonstruieren. Im Gegensatz zu PCA, das nur lineare Beziehungen erfassen kann, kann ein Autoencoder nichtlineare lernen — daher sollte es Anomalien erkennen, die eine nichtlineare Struktur verletzen. Ich habe zwei Experimente gebaut — einen einfachen Fall und einen, der absichtlich als beste Chance des Autoencoders konzipiert wurde — und gemessen, ob der theoretische Vorteil tatsächlich auftritt.
Aufbau: synthetische Daten, nur mit normalen Stichproben trainiert, auf einer zurückgehaltenen Mischung aus normalen und anomalen Stichproben bewertet. Drei Methoden verglichen: ein Autoencoder (MLPRegressor mit einem 3-dimensionalen Engpass), PCA-Rekonstruktionsfehler (ebenfalls auf 3 Komponenten reduziert) und Isolation Forest. Experiment 1: normale Daten aus Gauß-Clustern, Anomalien mit verschobenem Mittelwert und höherer Varianz. PCA glich den Autoencoder aus oder schlug ihn — 0.885 F1 für beide, jede Anomalie erfassend (Recall = 1.0). Isolation Forest kam bei 0.870.
Experiment 2: Manipulation des Tests zugunsten des Autoencoders. Ich baute Anomalien, die für eine lineare Methode speziell unsichtbar sind: normale Daten, bei denen zwei Merkmale einer nichtlinearen Beziehung folgen (y = sin(3x) + Rauschen), und Anomalien, die denselben individuellen Bereich beibehalten, aber die Beziehung zwischen ihnen verletzen. Dies kommt einem Best-Case-Szenario für den Autoencoder nahe.
Schlüsselentitäten: Unternehmen: Towards Data Science
FAQ F: Warum glich PCA den Autoencoder sogar im nichtlinearen Anomalieerkennungstest aus?
FAQ A: Weil in Experiment 1 die Mittelwertverschiebungsanomalie ein lineares Phänomen ist, hatte PCA keinen strukturellen Nachteil. In Experiment 2, obwohl der Autoencoder theoretisch für nichtlineare Beziehungen bevorzugt war, war die Trennung des Rekonstruktionsfehlers immer noch groß genug, dass die Präzision der linearen Methode nicht viel ausmachte.
Quelle: Towards Data Science · Zusammengefasst von HeadlinesBriefing