
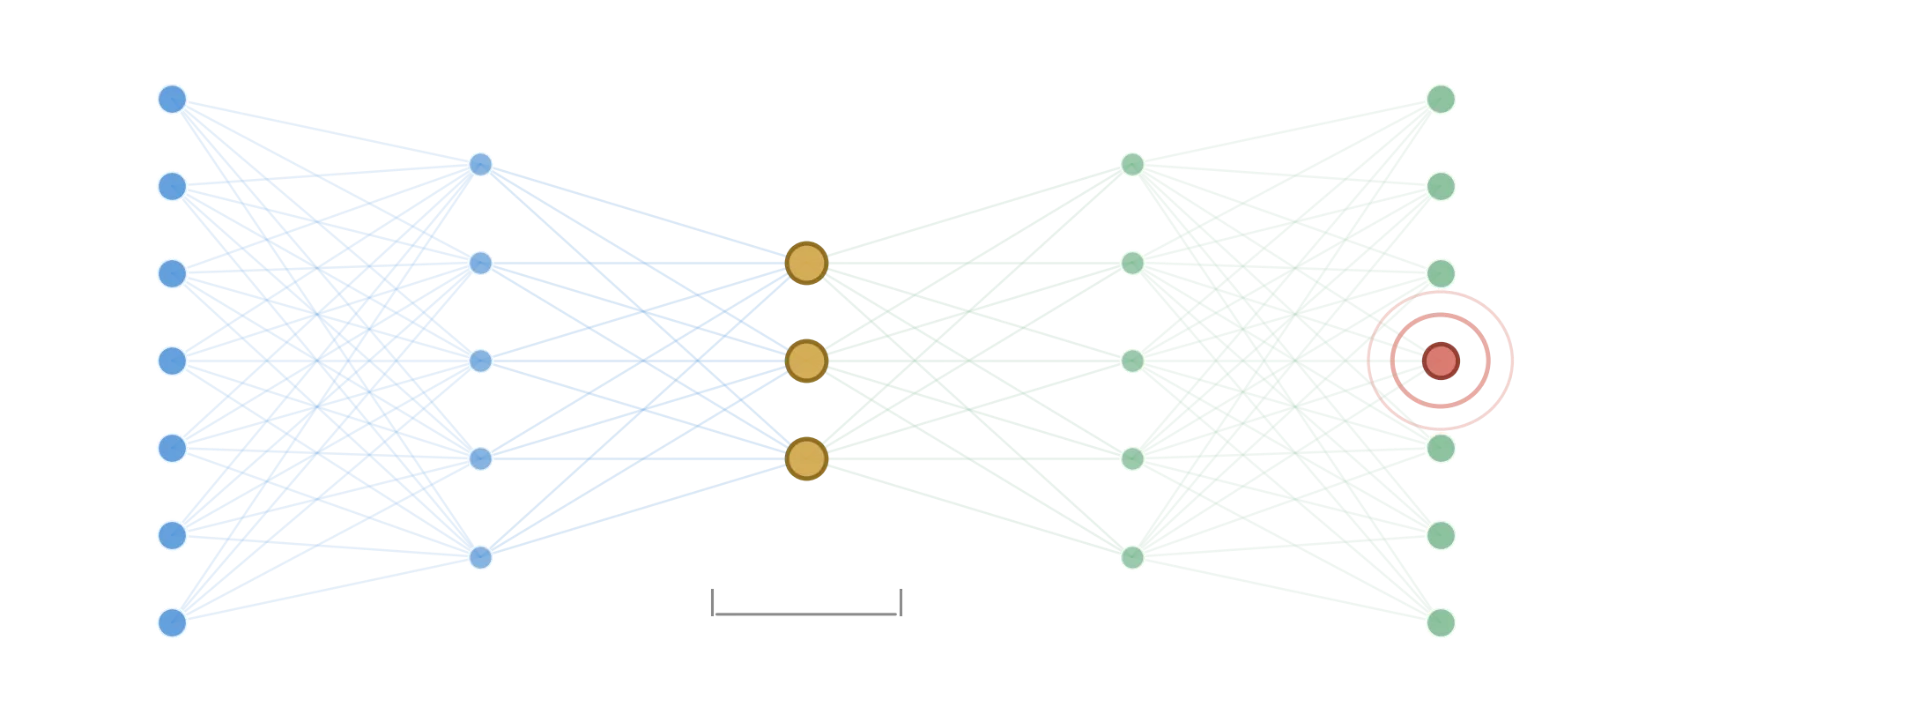
Una ventaja teórica que no sobrevivió al contacto con un benchmark real. El caso teórico para los autoencoders es claro: entrenar la red solo con datos normales, y aprende a reconstruir patrones normales bien. A diferencia de PCA, que solo puede capturar relaciones lineales, un autoencoder puede aprender relaciones no lineales — por lo que debería detectar anomalías que violen una estructura no lineal. Construí dos experimentos — un caso fácil, y otro deliberadamente diseñado para ser el mejor escenario del autoencoder — y medí si la ventaja teórica realmente se manifiesta.
Configuración: datos sintéticos, entrenados solo con muestras normales, evaluados en una mezcla reservada de muestras normales y anómalas. Se compararon tres métodos: un autoencoder (MLPRegressor con un cuello de botella de 3 dimensiones), error de reconstrucción de PCA (también reducido a 3 componentes), y Isolation Forest. Experimento 1: datos normales de grupos gaussianos, anomalías con media desplazada y mayor varianza. PCA igualó o superó al autoencoder — 0.885 F1 para ambos, detectando todas las anomalías (recall = 1.0). Isolation Forest obtuvo 0.870.
Experimento 2: amañando la prueba a favor del autoencoder. Construí anomalías específicamente invisibles para un método lineal: datos normales donde dos características siguen una relación no lineal (y = sin(3x) + ruido), y anomalías que mantienen el mismo rango individual pero violan la relación entre ellas. Esto se acerca al mejor escenario para el autoencoder.
Entidades clave: Empresas: Towards Data Science
FAQ Q: ¿Por qué PCA igualó al autoencoder incluso en la prueba de detección de anomalías no lineales?
FAQ A: Porque en el Experimento 1, la anomalía de desplazamiento de media es un fenómeno lineal, por lo que PCA no tenía desventaja estructural. En el Experimento 2, aunque el autoencoder era teóricamente favorecido para relaciones no lineales, la separación del error de reconstrucción seguía siendo lo suficientemente grande como para que la precisión del método lineal no importara mucho.
Fuente: Towards Data Science · Resumido por HeadlinesBriefing