
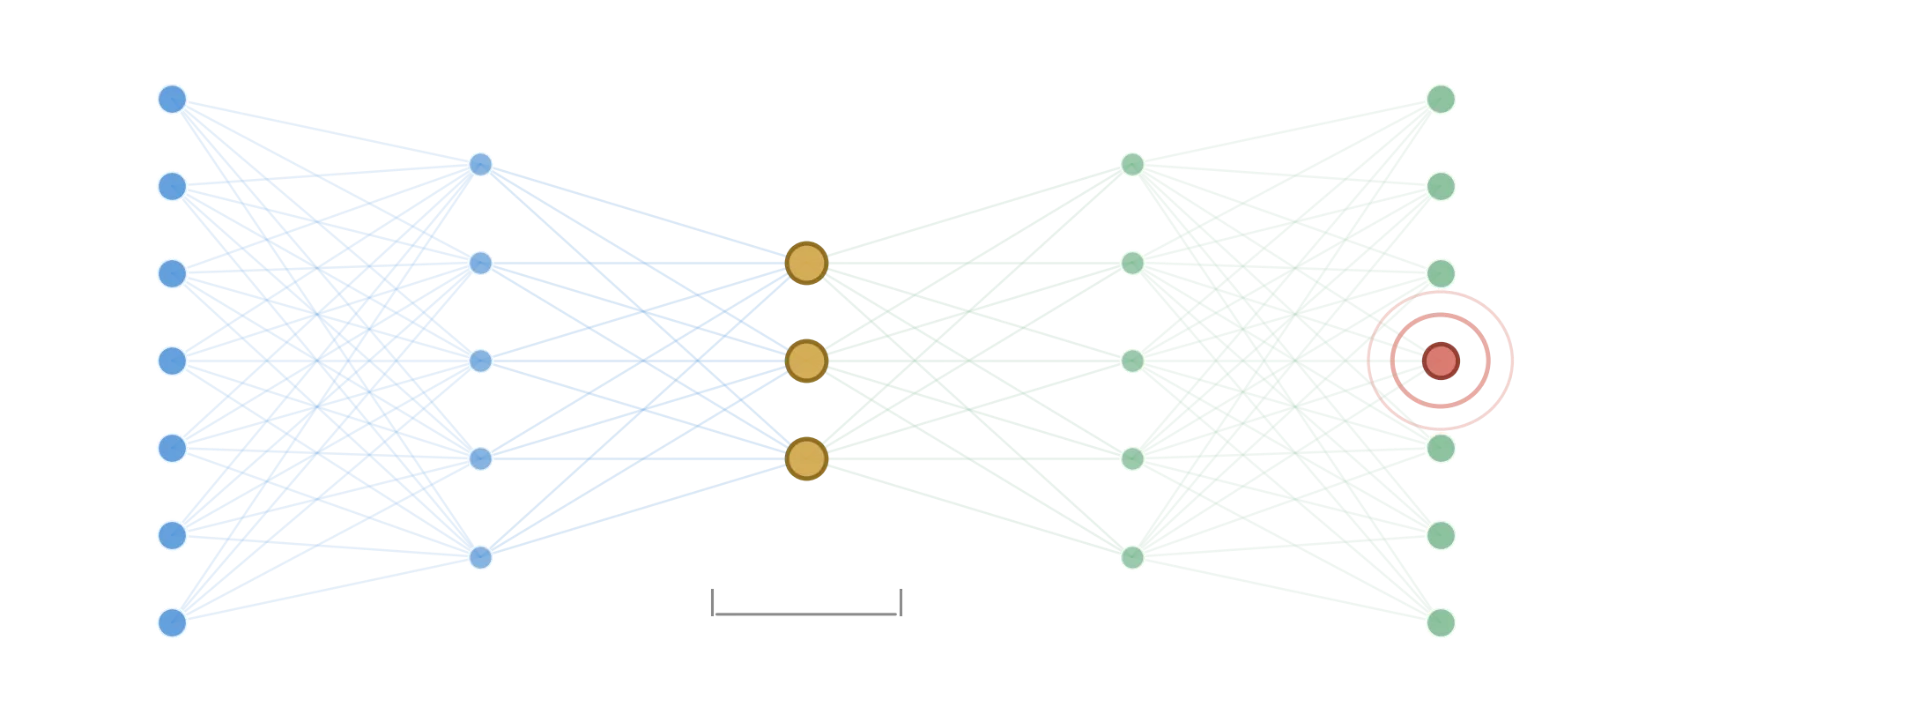
একটি তাত্ত্বিক সুবিধা যা বাস্তব বেঞ্চমার্কের সংস্পর্শে টিকেনি। অটোএনকোডারের জন্য তাত্ত্বিক যুক্তি পরিষ্কার: শুধুমাত্র স্বাভাবিক ডেটাতে নেটওয়ার্ককে প্রশিক্ষণ দিন, এবং এটি স্বাভাবিক প্যাটার্নগুলি ভালভাবে পুনর্গঠন করতে শেখে। PCA-এর বিপরীতে, যা শুধুমাত্র রৈখিক সম্পর্ক ধারণ করতে পারে, একটি অটোএনকোডার অরৈখিক সম্পর্ক শিখতে পারে — তাই এটি এমন অসঙ্গতি ধরা উচিত যা একটি অরৈখিক কাঠামো লঙ্ঘন করে। আমি দুটি পরীক্ষা তৈরি করেছি — একটি সহজ কেস, এবং একটি ইচ্ছাকৃতভাবে অটোএনকোডারের সেরা শট হিসাবে ডিজাইন করা — এবং পরিমাপ করেছি যে তাত্ত্বিক সুবিধাটি আসলে দেখা যায় কিনা।
সেটআপ: সিন্থেটিক ডেটা, শুধুমাত্র স্বাভাবিক নমুনায় প্রশিক্ষিত, স্বাভাবিক এবং অস্বাভাবিক নমুনার সংরক্ষিত মিশ্রণে মূল্যায়ন করা হয়েছে। তিনটি পদ্ধতি তুলনা করা হয়েছে: একটি অটোএনকোডার (MLPRegressor যার একটি 3-মাত্রিক বাধা রয়েছে), PCA পুনর্গঠন ত্রুটি (3 উপাদানে হ্রাস করা), এবং আইসোলেশন ফরেস্ট। পরীক্ষা 1: গাউসিয়ান ক্লাস্টার থেকে স্বাভাবিক ডেটা, স্থানান্তরিত গড় এবং উচ্চতর প্রকরণ সহ অসঙ্গতি। PCA অটোএনকোডারকে মিলিয়ে বা পরাজিত করেছে — উভয়ের জন্য 0.885 F1, প্রতিটি অসঙ্গতি ধরা (রিকল = 1.0)। আইসোলেশন ফরেস্ট 0.870 এ এসেছে।
পরীক্ষা 2: অটোএনকোডারের পক্ষে পরীক্ষাটি রিগ করা। আমি বিশেষভাবে একটি রৈখিক পদ্ধতির জন্য অদৃশ্য অসঙ্গতি তৈরি করেছি: স্বাভাবিক ডেটা যেখানে দুটি বৈশিষ্ট্য একটি অরৈখিক সম্পর্ক (y = sin(3x) + শব্দ) অনুসরণ করে, এবং অসঙ্গতি যা একই পৃথক পরিসীমা রাখে কিন্তু তাদের মধ্যে সম্পর্ক লঙ্ঘন করে। এটি অটোএনকোডারের জন্য একটি সর্বোত্তম-পরিস্থিতির কাছাকাছি।
মূল সত্তা: কোম্পানি: Towards Data Science
FAQ Q: কেন PCA অরৈখিক অসঙ্গতি সনাক্তকরণ পরীক্ষায়ও অটোএনকোডারকে মিলিয়েছে?
FAQ A: কারণ পরীক্ষা 1-এ, গড় স্থানান্তর অসঙ্গতি একটি রৈখিক ঘটনা, তাই PCA-র কোনও কাঠামোগত অসুবিধা ছিল না। পরীক্ষা 2-এ, যদিও অটোএনকোডার তাত্ত্বিকভাবে অরৈখিক সম্পর্কের জন্য পছন্দনীয় ছিল, পুনর্গঠন ত্রুটি বিচ্ছেদ এখনও যথেষ্ট বড় ছিল যে রৈখিক পদ্ধতির নির্ভুলতা খুব বেশি গুরুত্বপূর্ণ ছিল না।
উৎস: Towards Data Science · সারাংশ: HeadlinesBriefing