
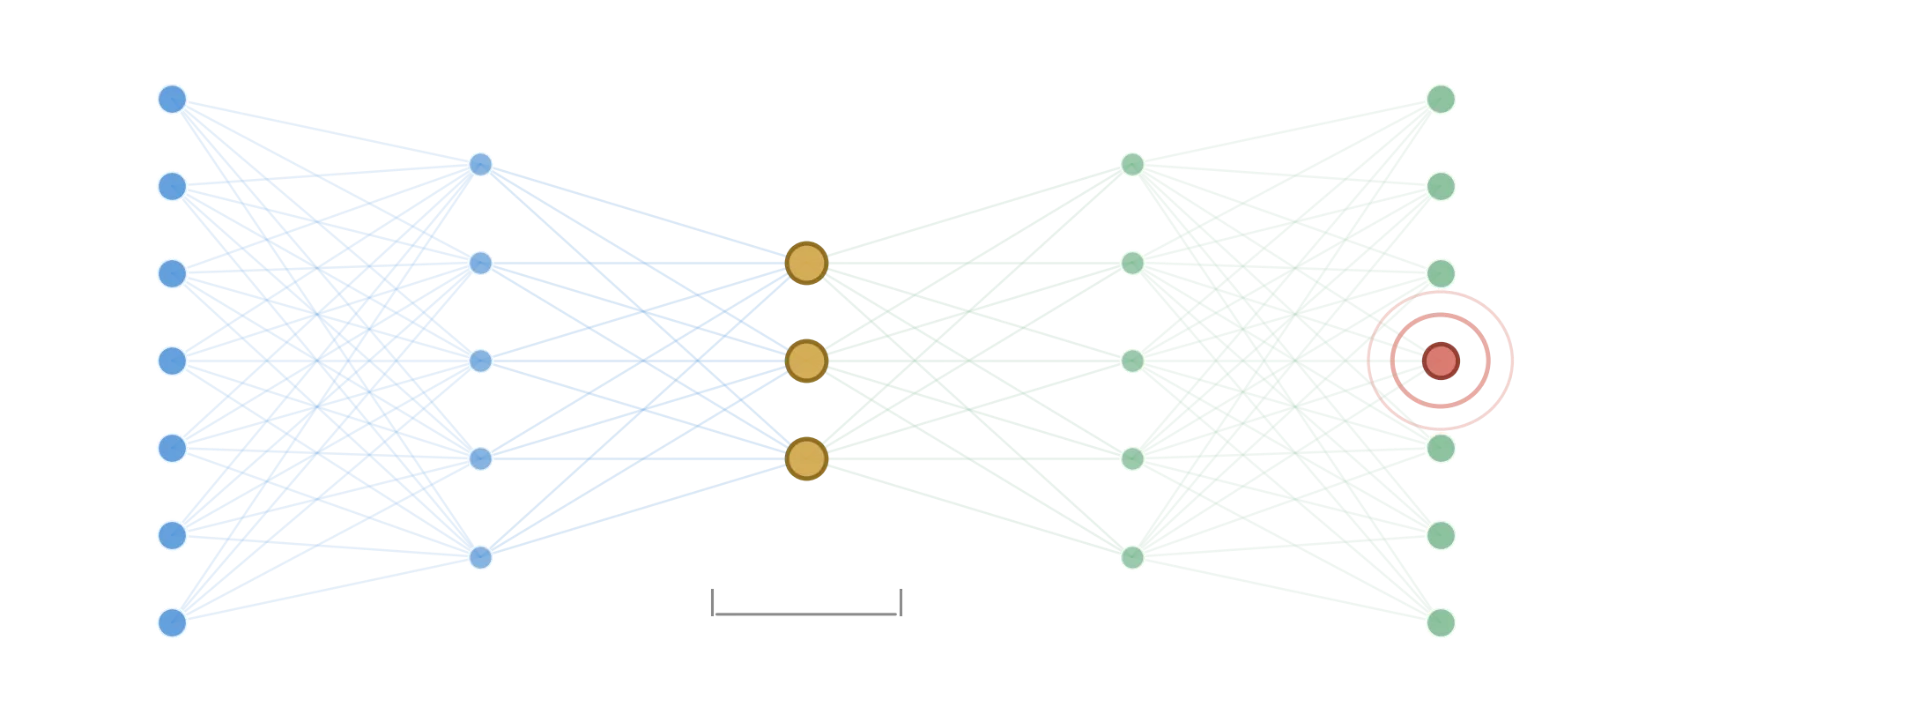
एक सैद्धांतिक लाभ जो वास्तविक बेंचमार्क के संपर्क में नहीं टिका। ऑटोएन्कोडर के लिए सैद्धांतिक मामला स्पष्ट है: केवल सामान्य डेटा पर नेटवर्क को प्रशिक्षित करें, और यह सामान्य पैटर्न को अच्छी तरह से पुनर्निर्माण करना सीखता है। PCA के विपरीत, जो केवल रैखिक संबंधों को पकड़ सकता है, एक ऑटोएन्कोडर अरैखिक संबंध सीख सकता है — इसलिए इसे उन विसंगतियों को पकड़ना चाहिए जो अरैखिक संरचना का उल्लंघन करती हैं। मैंने दो प्रयोग बनाए — एक आसान मामला, और एक जानबूझकर ऑटोएन्कोडर के सर्वोत्तम शॉट के रूप में डिज़ाइन किया गया — और मापा कि क्या सैद्धांतिक लाभ वास्तव में दिखाई देता है।
सेटअप: सिंथेटिक डेटा, केवल सामान्य नमूनों पर प्रशिक्षित, सामान्य और विसंगत नमूनों के आरक्षित मिश्रण पर मूल्यांकन किया गया। तीन विधियों की तुलना: एक ऑटोएन्कोडर (MLPRegressor जिसमें 3-आयामी अड़चन है), PCA पुनर्निर्माण त्रुटि (3 घटकों तक कम), और आइसोलेशन फ़ॉरेस्ट। प्रयोग 1: गाऊसी क्लस्टर से सामान्य डेटा, स्थानांतरित माध्य और उच्च विचरण वाली विसंगतियाँ। PCA ने ऑटोएन्कोडर को मात दी या बराबरी की — दोनों के लिए 0.885 F1, सभी विसंगतियों को पकड़ते हुए (रिकॉल = 1.0)। आइसोलेशन फ़ॉरेस्ट 0.870 पर आया।
प्रयोग 2: ऑटोएन्कोडर के पक्ष में परीक्षण को रिग करना। मैंने विशेष रूप से रैखिक विधि के लिए अदृश्य विसंगतियाँ बनाईं: सामान्य डेटा जहाँ दो विशेषताएँ अरैखिक संबंध (y = sin(3x) + शोर) का पालन करती हैं, और विसंगतियाँ जो समान व्यक्तिगत सीमा रखती हैं लेकिन उनके बीच संबंध का उल्लंघन करती हैं। यह ऑटोएन्कोडर के लिए सर्वोत्तम-स्थिति के करीब है।
मुख्य संस्थाएँ: कंपनियाँ: Towards Data Science
FAQ Q: PCA ने अरैखिक विसंगति परीक्षण में भी ऑटोएन्कोडर को क्यों मात दी?
FAQ A: क्योंकि प्रयोग 1 में, माध्य स्थानांतरण विसंगति एक रैखिक घटना है, इसलिए PCA की कोई संरचनात्मक हानि नहीं थी। प्रयोग 2 में, हालाँकि ऑटोएन्कोडर सैद्धांतिक रूप से अरैखिक संबंधों के लिए पसंदीदा था, पुनर्निर्माण त्रुटि पृथक्करण अभी भी इतना बड़ा था कि रैखिक विधि की सटीकता ज्यादा मायने नहीं रखती थी।
स्रोत: Towards Data Science · HeadlinesBriefing द्वारा सारांशित