
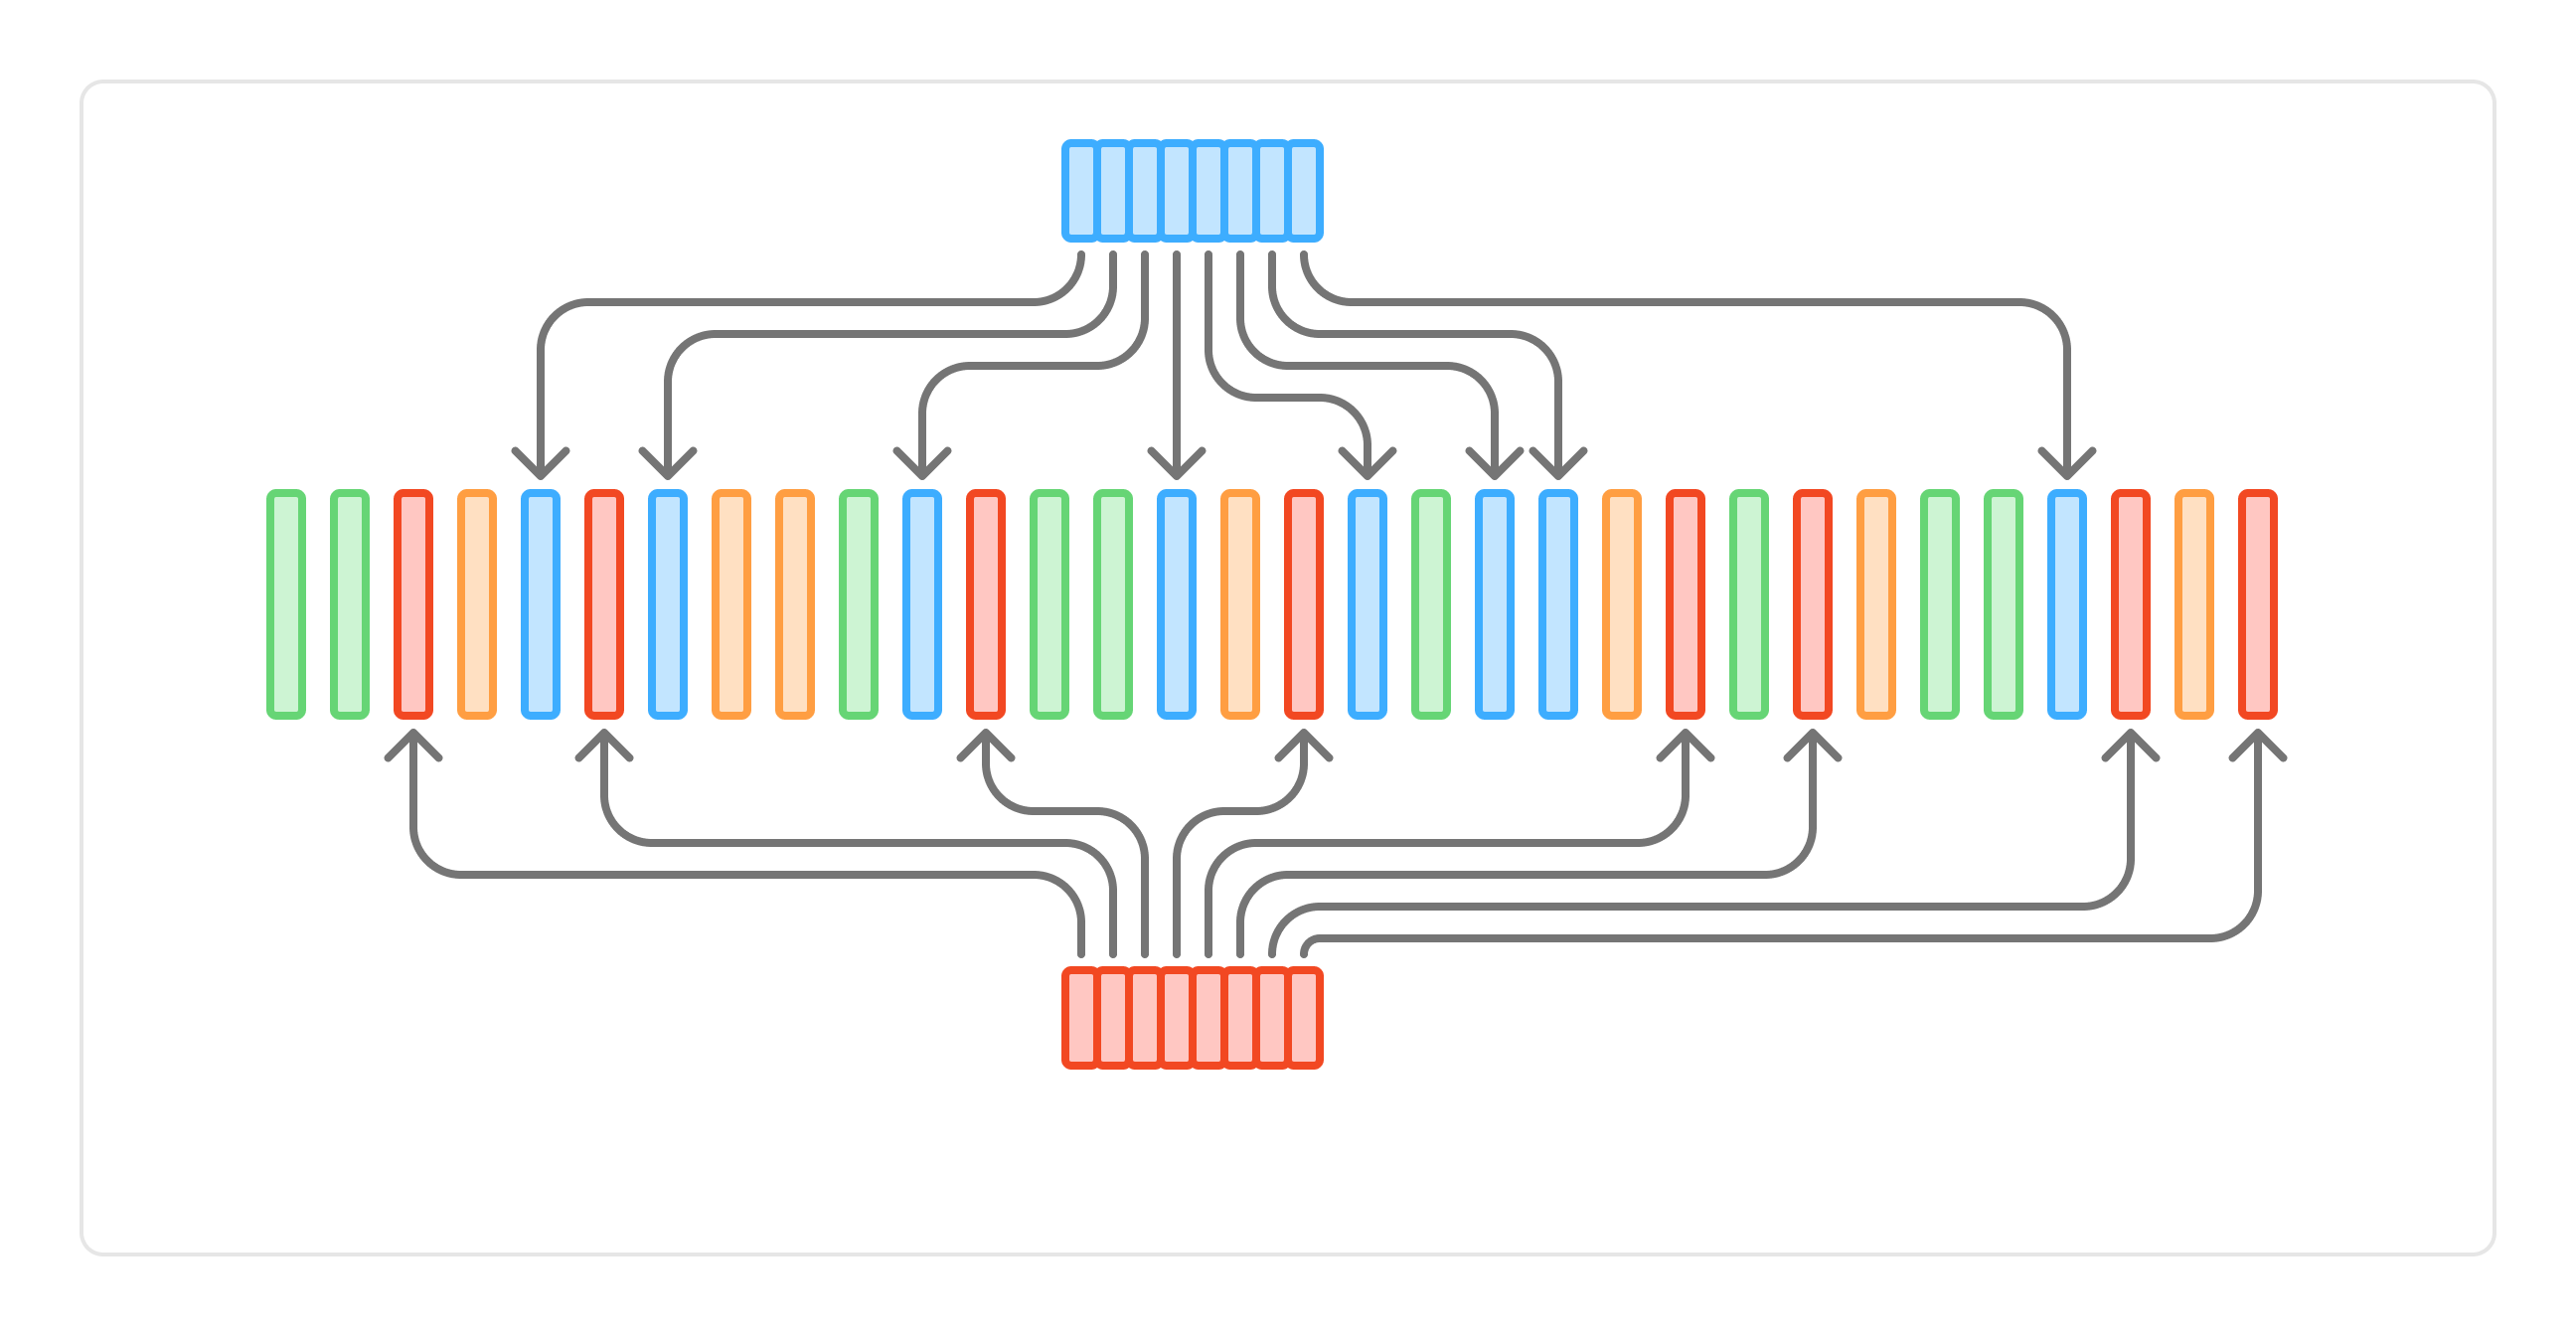
Aria 是公司的内部消息传递框架和托管系统,每天处理数TB的数据。客户端订阅 Aria 以接收实时消息流。随着使用量迅速增长,Aria 团队不得不重新架构该系统,以跟上不断增长的数据量和吞吐量。今年夏天,实习生 Theodor Totev 专注于一个具体用例:让客户端更经济地只读取消息的一个子集。他利用索引和树分割的工作,使生产工作负载上的 CPU 使用率降低了 30%,同时保持了此类关键系统所需的高标准正确性。
当 Aria 通过 TCP 投递消息时,它会将最近的消息(称为流尾部)保存在内存中的环形缓冲区里。落后的客户端可以从该缓冲区请求最近的消息以赶上进度,这一过程称为尾部恢复。挑战在于,Aria 存储的是完整的消息流,而客户端通常只需要其中很小的一部分。Aria 按主题过滤消息流,客户端可以订阅单个主题,也可以订阅整个主题子树。最初的方法是对消息流进行简单的线性遍历。它在算法上效率低下,但得益于 CPU 缓存友好性,速度较快。随着进行尾部恢复的客户端数量增加,一些服务器的 CPU 利用率达到了 100%,导致客户端脱离尾部,无法追赶上进度。
为每个主题建立索引的方案被否决了,因为 Aria 实例可能拥有近百万个主题。取而代之,Theodor 为每个主题分区建立了索引,主题分区将共享相同两段前缀的所有主题归为一组。每个分区的索引记录其消息在消息流中的位置。当客户端请求消息时,Aria 使用最小堆对相关索引执行 n 路归并,仅为所请求的分区按顺序重建消息流。
基准测试是这项工作的核心。Theodor 构建了一个性能分析工具,用于测试主题分区数量、交错程度和读取者数量等变量。对初始实现进行性能分析后发现,最小堆是最大的瓶颈。
来源: Hacker News · 由HeadlinesBriefing整理摘要