
A Aria é o framework interno de mensagens da empresa e um sistema hospedado que processa vários terabytes de dados por dia. Os clientes assinam a Aria para receber um fluxo ao vivo de mensagens. Como o uso cresceu rapidamente, a equipe da Aria precisou reestruturar o sistema para acompanhar o aumento no volume de dados e na taxa de transferência. Neste verão, o estagiário Theodor Totev concentrou-se em um caso de uso específico: tornar mais barato para os clientes ler apenas um subconjunto de mensagens. Seu trabalho com indexação e divisão de árvores reduziu o uso de CPU em cargas de trabalho de produção em 30%, mantendo o alto padrão de precisão exigido por um sistema tão crítico.
Quando a Aria entrega mensagens via TCP, ela mantém as mensagens recentes, conhecidas como a ponta do fluxo, em um buffer circular na memória. Clientes que ficam para trás podem solicitar mensagens recentes desse buffer para se atualizar, processo chamado de recuperação da ponta. O desafio é que a Aria armazena todo o fluxo de mensagens, enquanto os clientes frequentemente precisam de apenas uma pequena parte. A Aria filtra o fluxo por tópico, e os clientes podem assinar tópicos individuais ou subárvores inteiras de tópicos. A abordagem original era uma varredura linear simples do fluxo. Era algoritmicamente ineficiente, mas rápida graças à afinidade com o cache da CPU. À medida que o número de clientes em recuperação da ponta aumentou, alguns servidores atingiram 100% de utilização de CPU, fazendo com que os clientes saíssem da ponta e não conseguissem se atualizar.
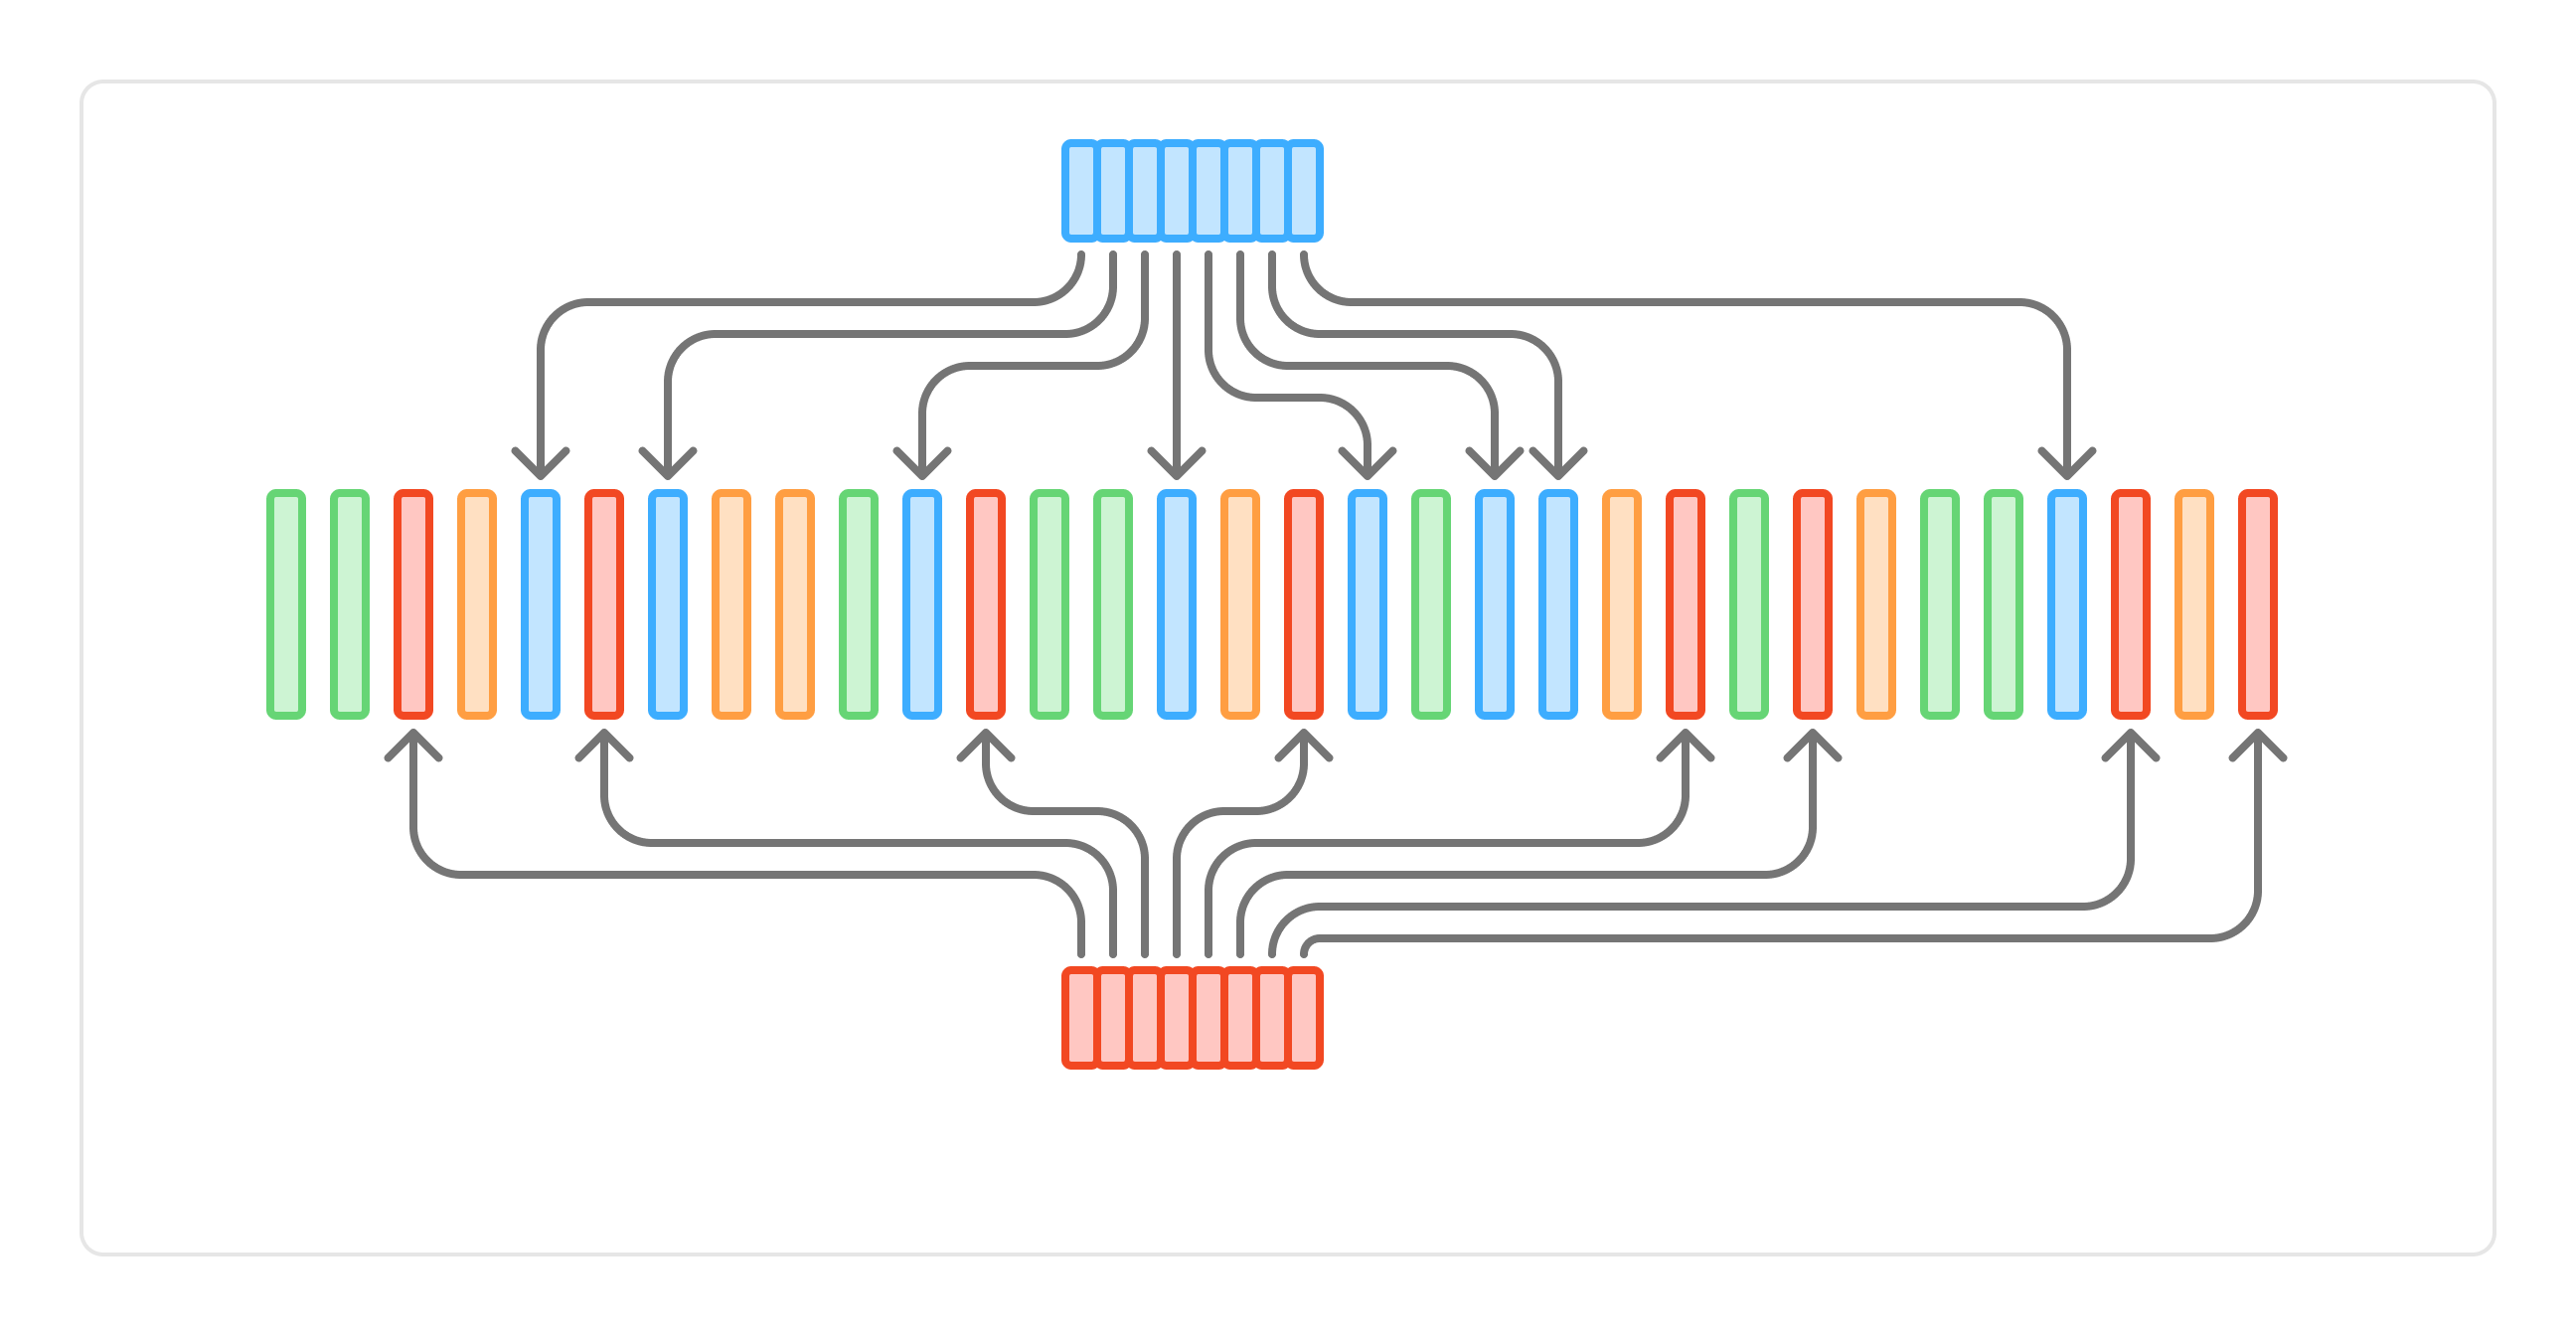
Um índice para cada tópico foi descartado, pois instâncias da Aria podem ter quase um milhão de tópicos. Em vez disso, Theodor criou um índice para cada partição de tópicos, que agrupa todos os tópicos com o mesmo prefixo de dois segmentos. O índice de cada partição registra a localização de suas mensagens no fluxo. Quando um cliente solicita mensagens, a Aria realiza uma intercalação de n vias dos índices relevantes usando um min-heap, reconstruindo o fluxo em ordem apenas para as partições solicitadas.
O benchmarking foi central para o trabalho. Theodor desenvolveu uma ferramenta de perfilamento para testar variáveis como o número de partições de tópicos, o grau de intercalação e o número de leitores. O perfilamento da implementação inicial revelou que o min-heap era o maior gargalo.
Fonte: Hacker News · Resumido por HeadlinesBriefing