
Aria es el marco de mensajería interno de la empresa y un sistema alojado que procesa múltiples terabytes de datos al día. Los clientes se suscriben a Aria para recibir un flujo en vivo de mensajes. Como el uso ha crecido rápidamente, el equipo de Aria ha tenido que rediseñar el sistema para seguir el ritmo del aumento en el volumen de datos y el rendimiento. Este verano, la pasante Theodor Totev se centró en un caso de uso específico: hacer que sea más económico para los clientes leer solo un subconjunto de mensajes. Su trabajo con indexación y división de árboles redujo el uso de CPU en cargas de trabajo de producción en un 30%, manteniendo el alto nivel de exactitud que exige un sistema tan crítico.
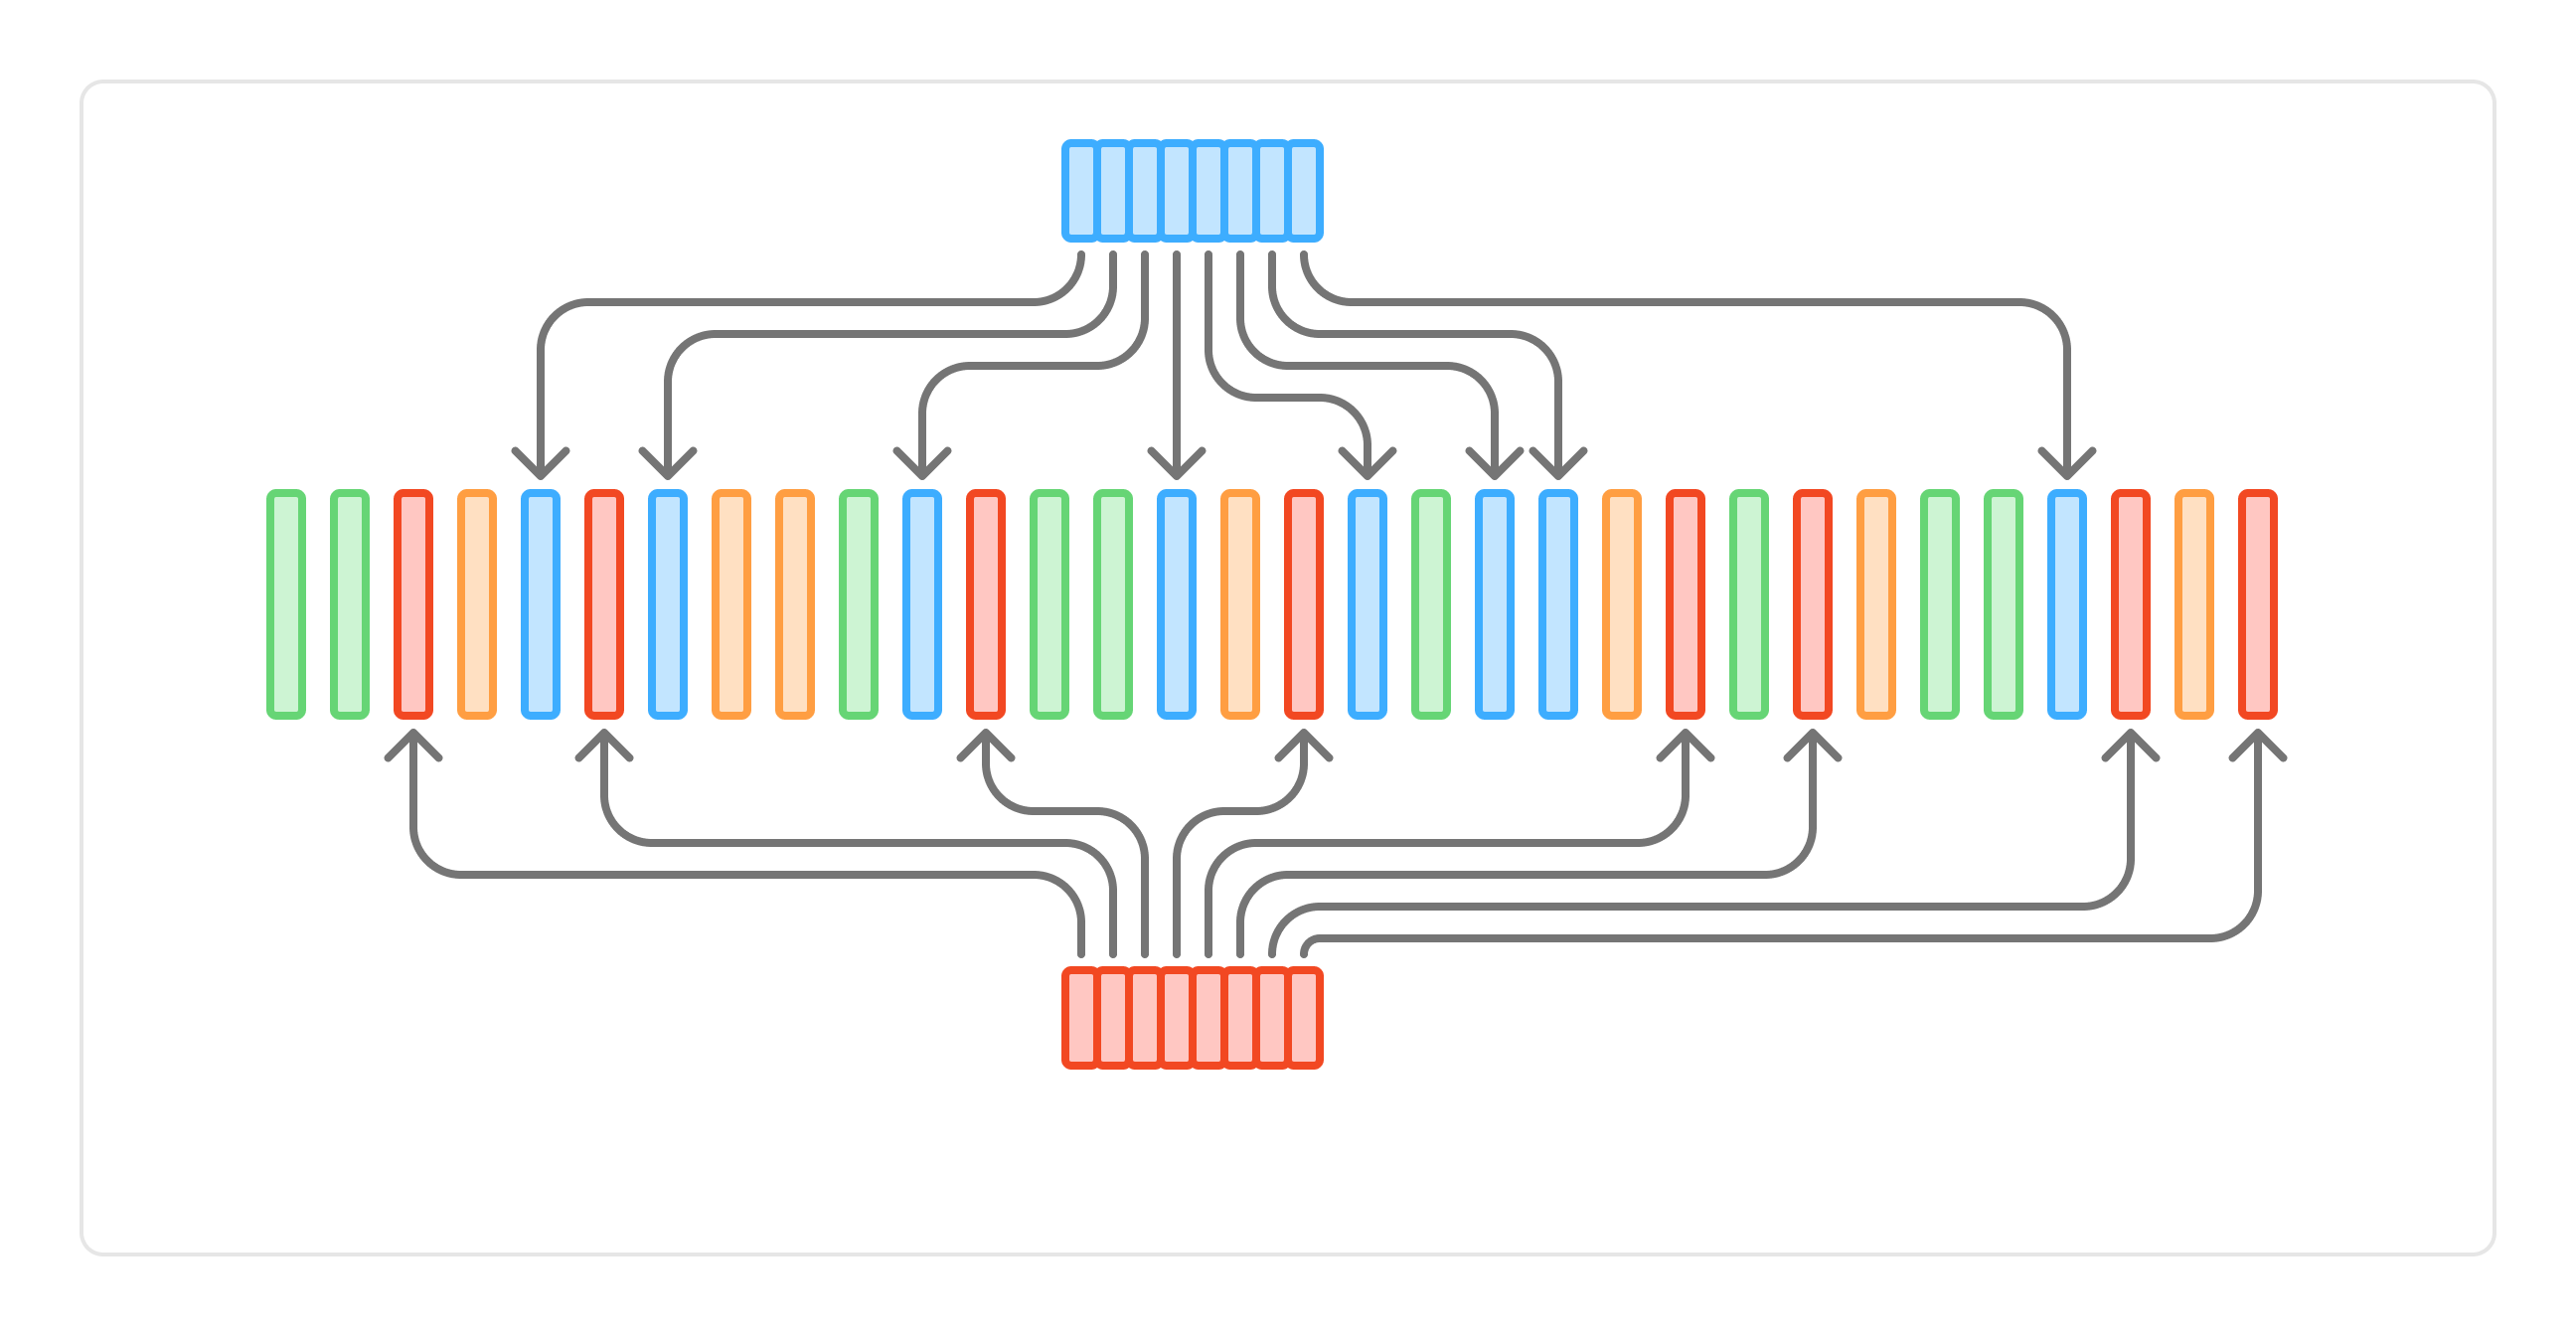
Cuando Aria entrega mensajes por TCP, mantiene los mensajes recientes, llamados la punta del flujo, en un búfer circular en memoria. Los clientes que se retrasan pueden solicitar mensajes recientes de este búfer para ponerse al día, un proceso llamado recuperación de la punta. El desafío es que Aria almacena el flujo completo de mensajes, mientras que los clientes a menudo solo necesitan una pequeña parte. Aria filtra el flujo por tema, y los clientes pueden suscribirse a temas individuales o a subárboles completos de temas. El enfoque original era un recorrido lineal simple del flujo. Era algorítmicamente ineficiente, pero rápido gracias a su buena afinidad con la caché de CPU. A medida que crecía el número de clientes que realizaban la recuperación de la punta, algunos servidores alcanzaron un 100% de utilización de CPU, lo que hacía que los clientes se salieran de la punta y no pudieran ponerse al día.
Se descartó crear un índice por cada tema, ya que las instancias de Aria pueden tener casi un millón de temas. En su lugar, Theodor creó un índice por cada partición de temas, que agrupa todos los temas con el mismo prefijo de dos segmentos. El índice de cada partición registra la ubicación de sus mensajes en el flujo. Cuando un cliente solicita mensajes, Aria realiza una fusión de n vías de los índices relevantes usando un montículo mínimo, reconstruyendo el flujo ordenado solo para las particiones solicitadas.
La evaluación comparativa fue central en el trabajo. Theodor creó una herramienta de perfilado para probar variables como el número de particiones de temas, el grado de intercalado y el número de lectores. Al perfilar la implementación inicial, se descubrió que el montículo mínimo era el mayor cuello de botella.
Fuente: Hacker News · Resumido por HeadlinesBriefing