
Aria — это внутренняя система обмена сообщениями компании и размещённая платформа, которая обрабатывает несколько терабайт данных в день. Клиенты подписываются на Aria, чтобы получать живой поток сообщений. По мере стремительного роста использования команде Aria пришлось перестроить систему, чтобы успевать за ростом объёма данных и пропускной способности. Этим летом стажёр Theodor Totev занимался конкретным сценарием: сделать так, чтобы клиентам было дешевле читать лишь подмножество сообщений. Его работа с индексацией и разбиением деревьев снизила загрузку CPU на рабочих нагрузках в продакшене на 30% при сохранении высокого уровня корректности, необходимого для такой критически важной системы.
Когда Aria доставляет сообщения по TCP, она хранит недавние сообщения, так называемый хвост потока, в кольцевом буфере в оперативной памяти. Клиенты, которые отстали, могут запросить недавние сообщения из этого буфера, чтобы нагнать поток, — этот процесс называется восстановлением хвоста. Сложность в том, что Aria хранит весь поток сообщений, тогда как клиентам часто нужна лишь небольшая его часть. Aria фильтрует поток по темам, а клиенты могут подписываться как на отдельные темы, так и на целые поддеревья тем. Исходный подход представлял собой простой линейный проход по потоку. Он был алгоритмически неэффективен, но быстр благодаря дружелюбности к кэшу процессора. По мере роста числа клиентов, восстанавливающих хвост, некоторые серверы достигали загрузки CPU в 100%, из-за чего клиенты выпадали из хвоста и не могли нагнать поток.
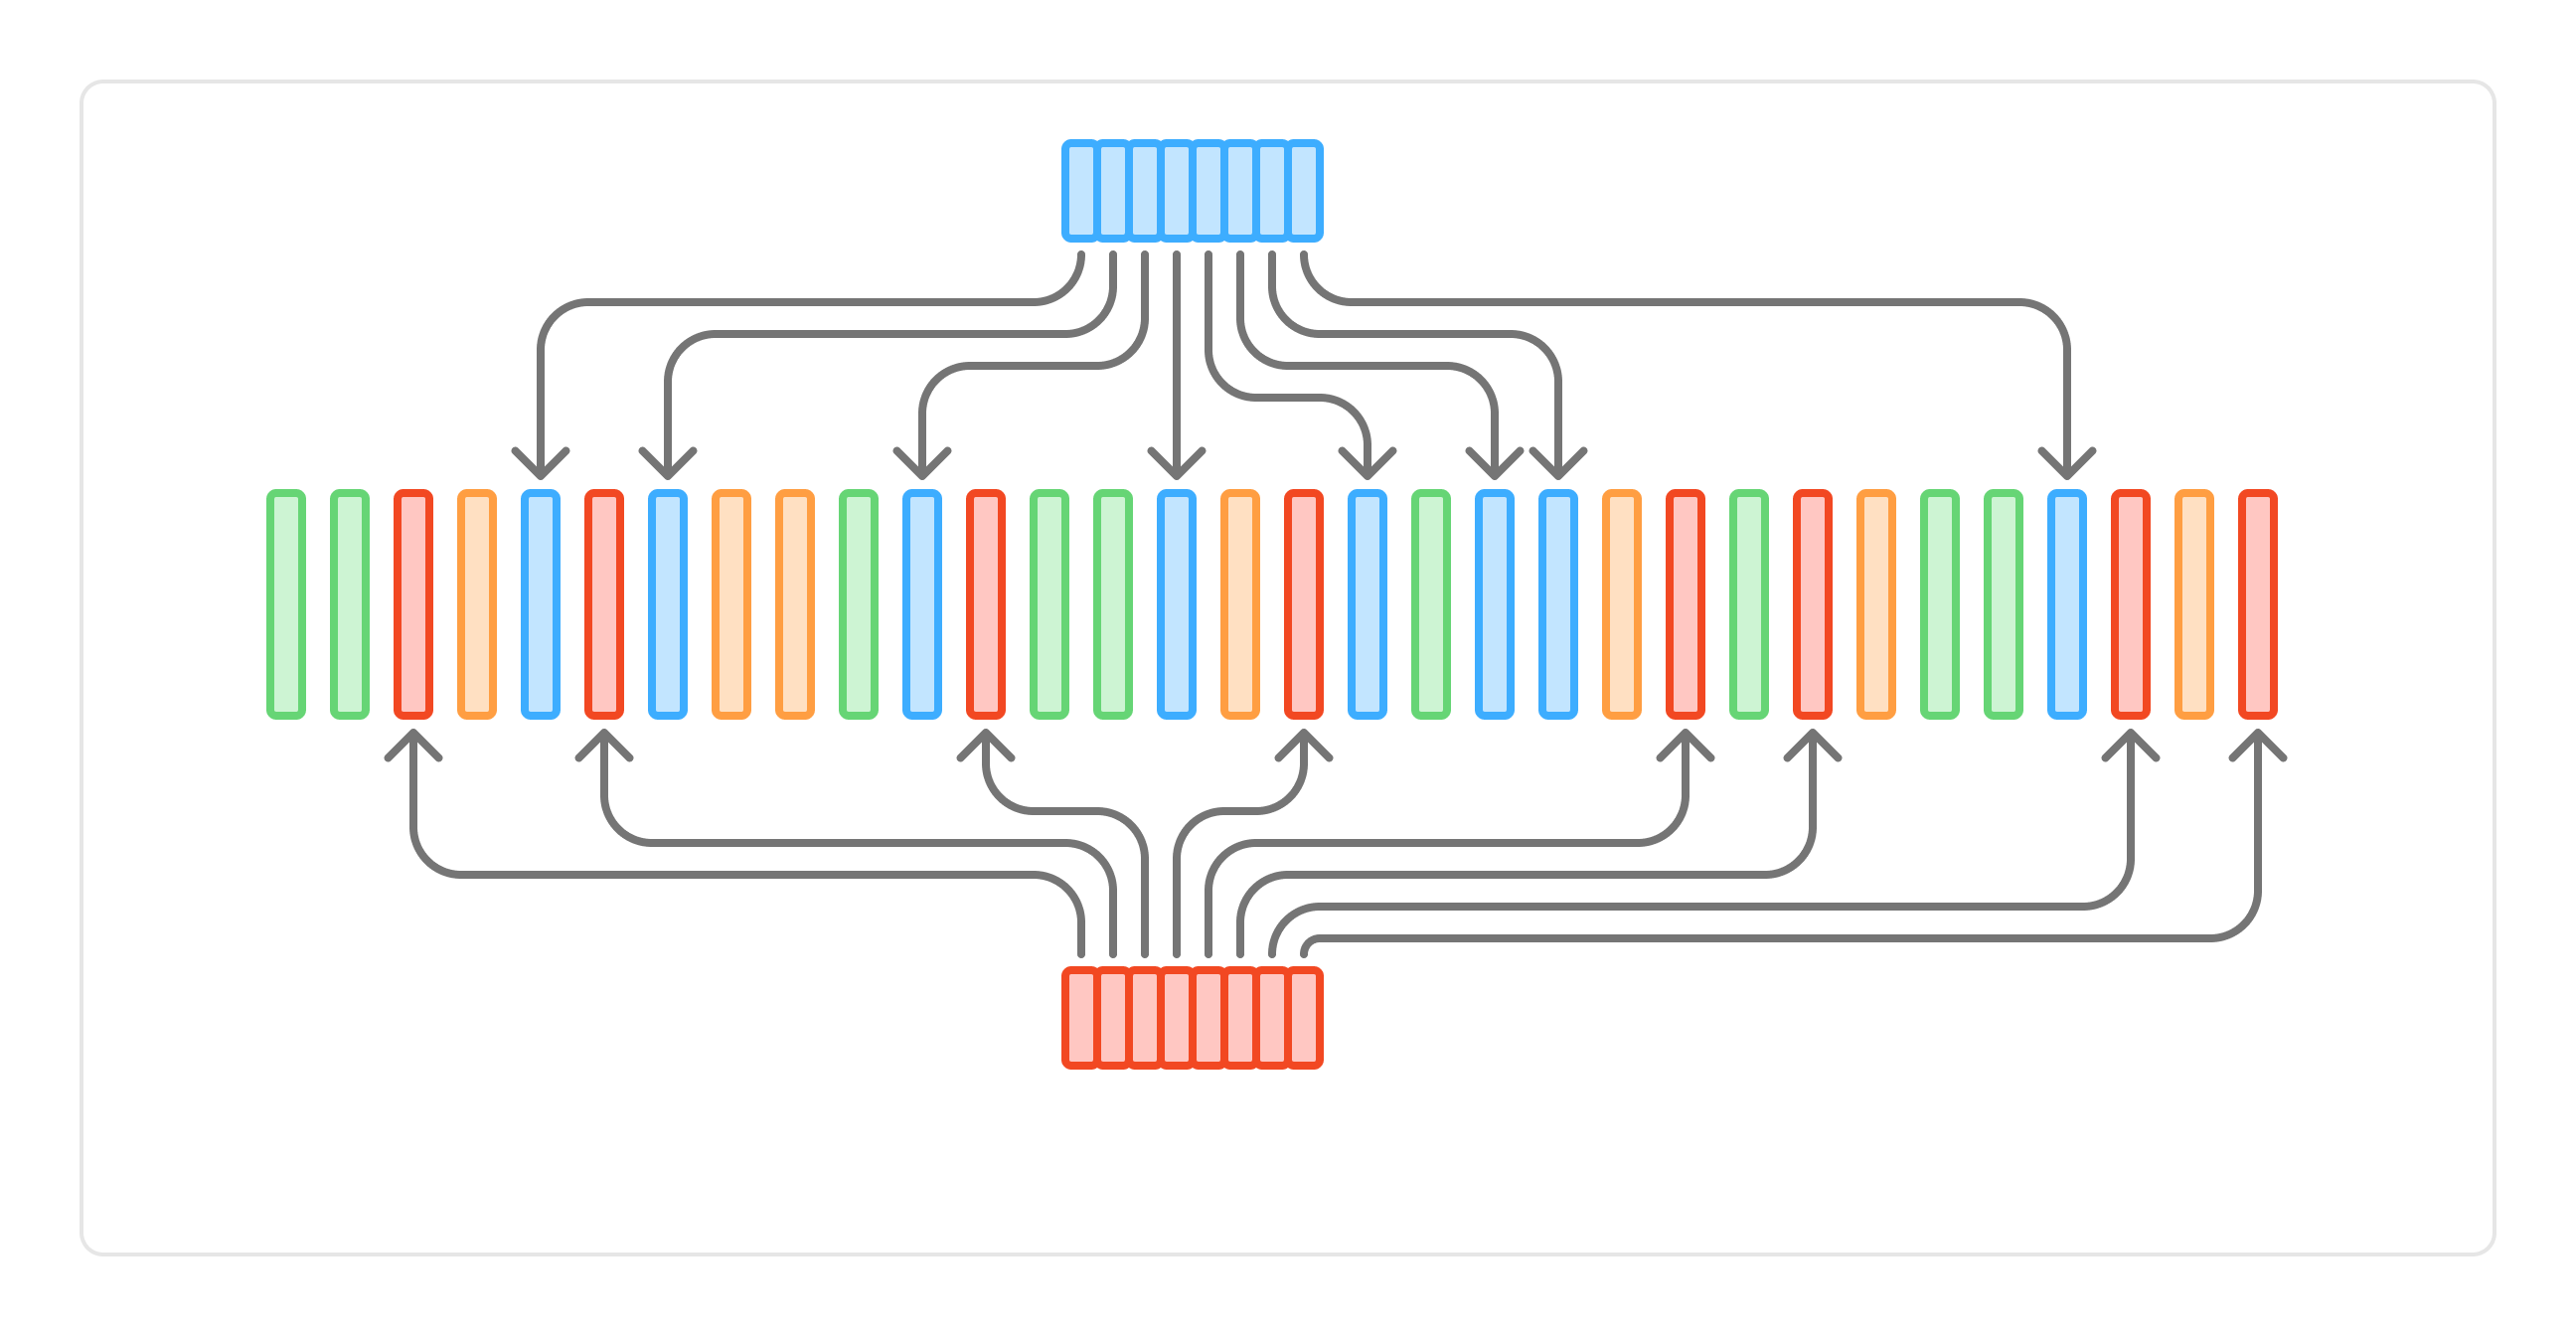
Индекс для каждой темы отвергли, поскольку в экземплярах Aria может быть почти миллион тем. Вместо этого Theodor создал индекс для каждой партиции тем, которая объединяет все темы с одинаковым двухсегментным префиксом. Индекс каждой партиции фиксирует расположение её сообщений в потоке. Когда клиент запрашивает сообщения, Aria выполняет n-way слияние соответствующих индексов с помощью мин-кучи, восстанавливая упорядоченный поток только для запрошенных партиций.
Бенчмаркинг был центральным элементом работы. Theodor разработал инструмент профилирования для проверки таких параметров, как количество партиций тем, степень чередования и количество читателей. Профилирование первоначальной реализации показало, что самым большим узким местом была мин-куча.
Источник: Hacker News · Сводку подготовил HeadlinesBriefing