
Aria ist das interne Messaging-Framework des Unternehmens und ein gehostetes System, das täglich mehrere Terabyte an Daten verarbeitet. Kunden abonnieren Aria, um einen Live-Stream von Nachrichten zu erhalten. Da die Nutzung rasant gewachsen ist, musste das Aria-Team das System neu strukturieren, um mit dem steigenden Datenvolumen und Durchsatz Schritt zu halten. In diesem Sommer konzentrierte sich der Praktikant Theodor Totev auf einen bestimmten Anwendungsfall: Es sollte für Kunden günstiger werden, nur eine Teilmenge der Nachrichten zu lesen. Seine Arbeit mit Indexierung und Baumaufteilung senkte die CPU-Auslastung unter Produktivlasten um 30 %, während das hohe Maß an Korrektheit erhalten blieb, das ein so kritisches System erfordert.
Wenn Aria Nachrichten über TCP zustellt, hält es die aktuellen Nachrichten, den sogenannten Stream-Tip, in einem Ringpuffer im Arbeitsspeicher vor. Kunden, die zurückfallen, können aktuelle Nachrichten aus diesem Puffer anfordern, um aufzuholen. Dieser Vorgang heißt Tip-Recovery. Die Herausforderung besteht darin, dass Aria den gesamten Nachrichtenstrom speichert, Kunden aber oft nur einen kleinen Teil benötigen. Aria filtert den Strom nach Themen, und Kunden können einzelne Themen oder ganze Themenunterbäume abonnieren. Der ursprüngliche Ansatz war ein einfacher linearer Durchlauf durch den Strom. Algorithmisch war er ineffizient, aber dank der guten Eignung für den CPU-Cache dennoch schnell. Mit der wachsenden Zahl der Clients, die eine Tip-Recovery durchführten, erreichten einige Server 100 % CPU-Auslastung, sodass Clients den Anschluss an den Tip verloren und nicht mehr aufholen konnten.
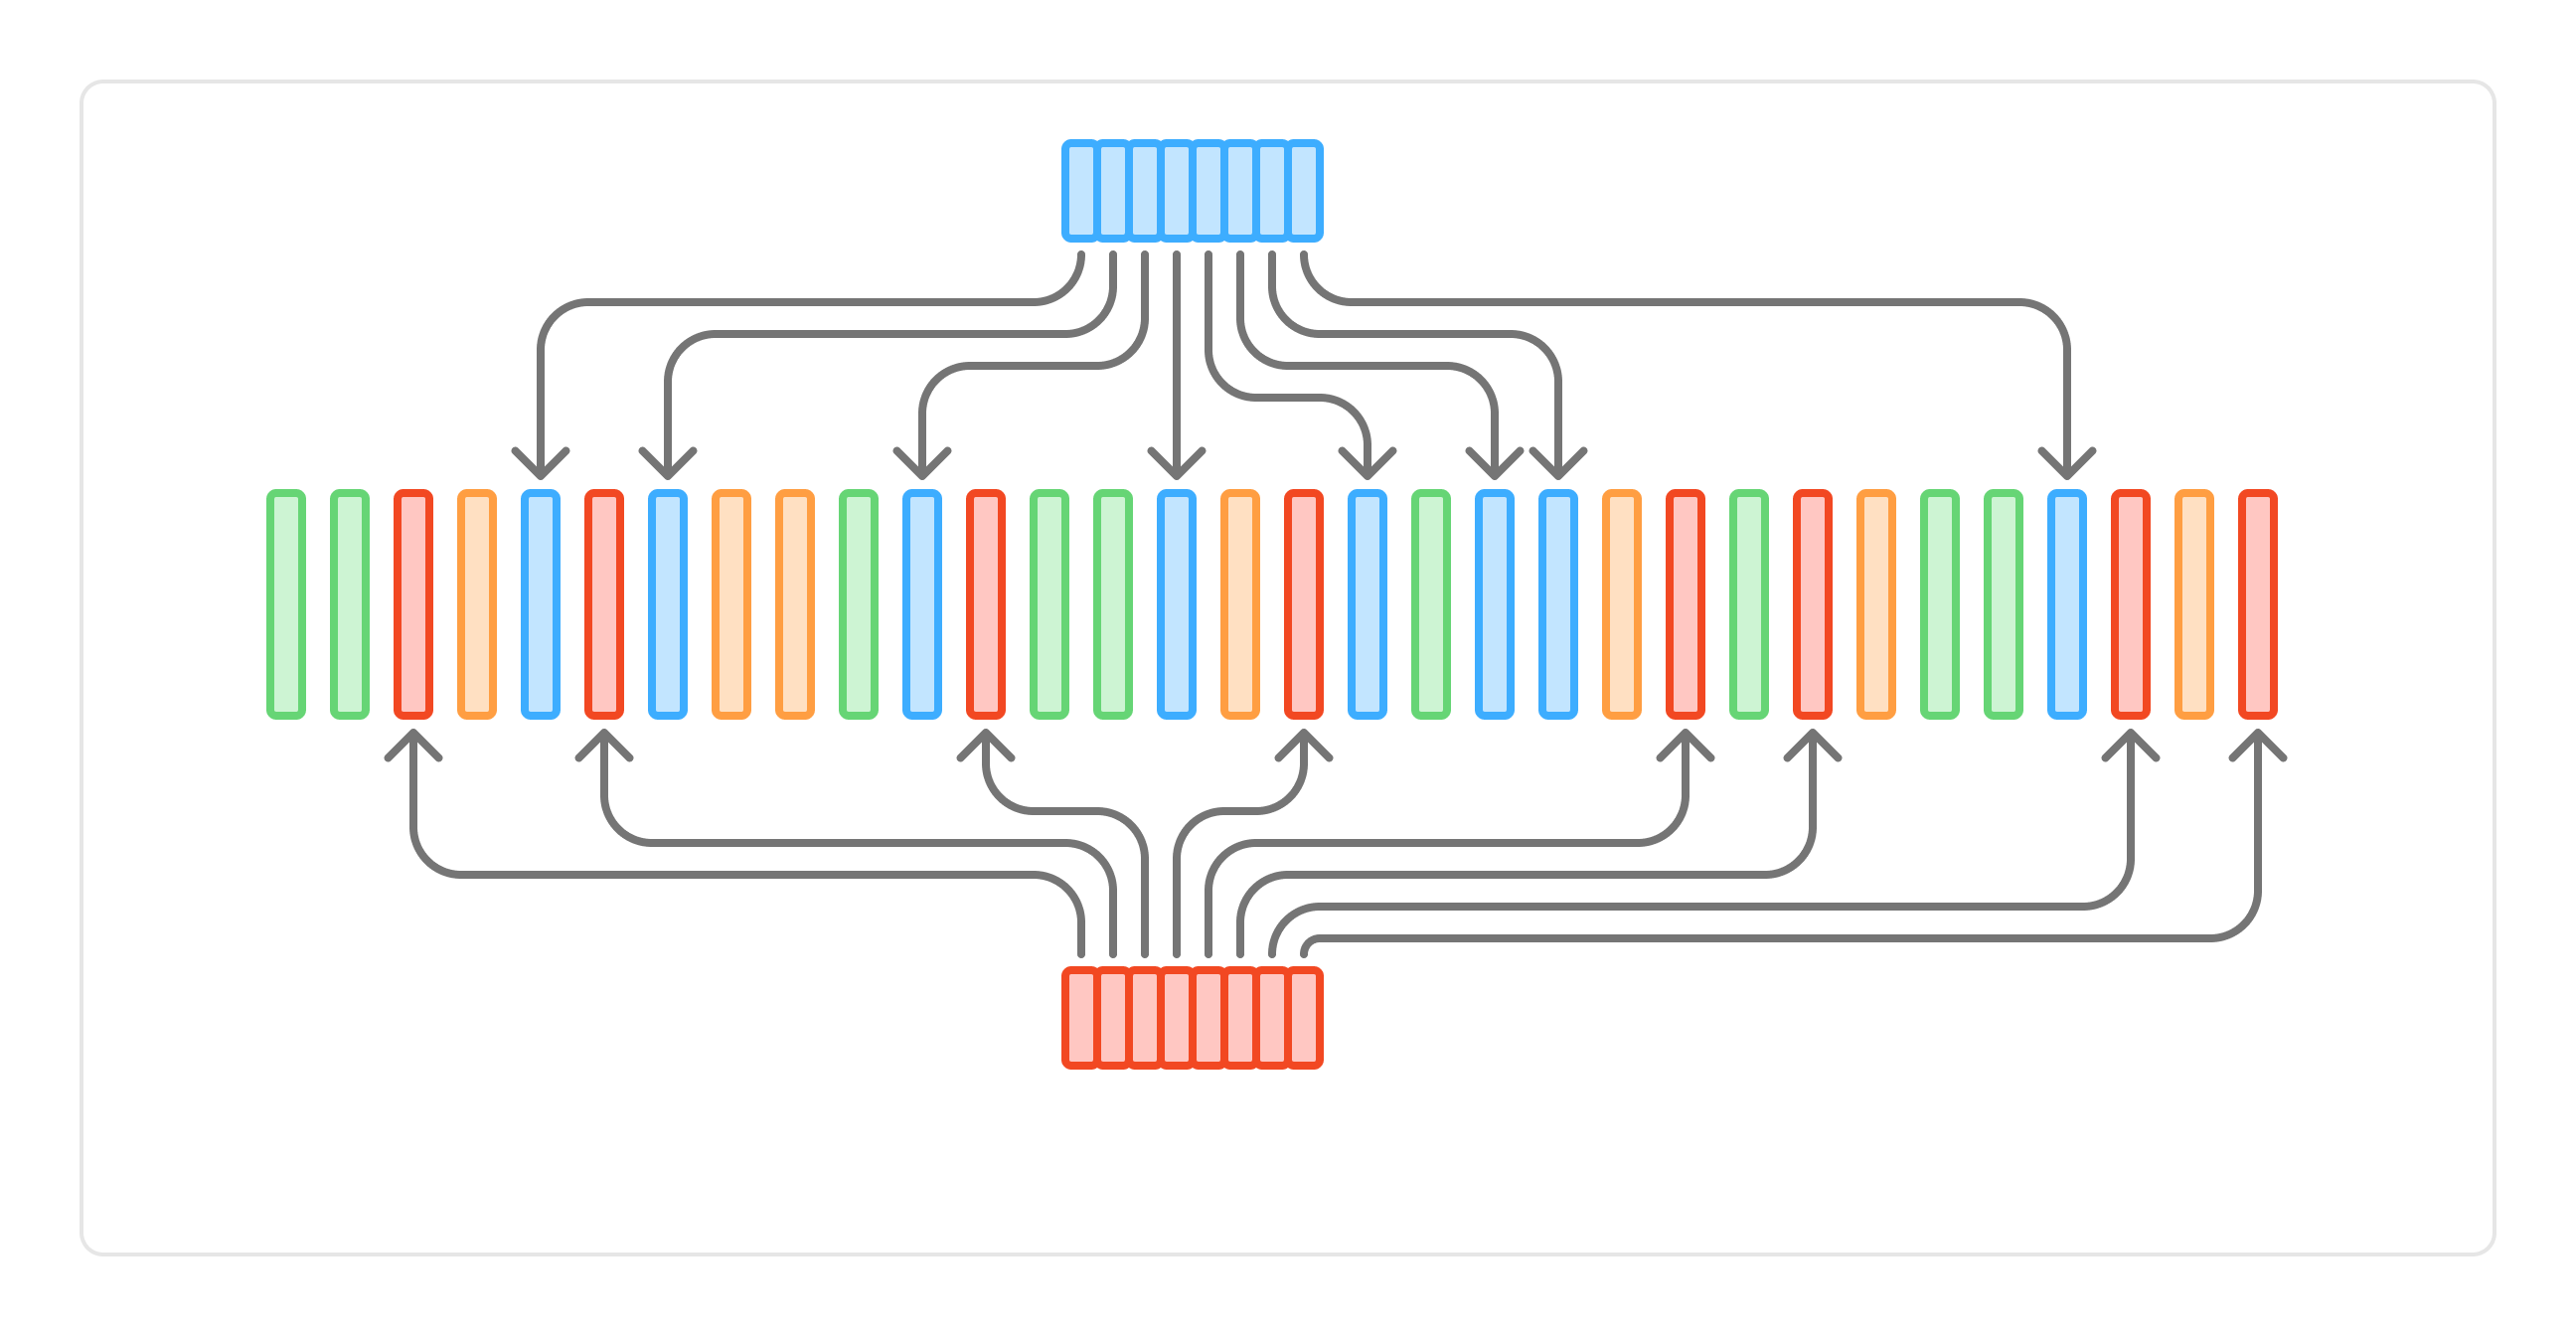
Ein Index für jedes Thema wurde verworfen, da Aria-Instanzen nahezu eine Million Themen haben können. Stattdessen erstellte Theodor einen Index für jede Themenpartition, die alle Themen mit demselben zweisegmentigen Präfix zusammenfasst. Der Index jeder Partition erfasst die Position ihrer Nachrichten im Strom. Fordert ein Client Nachrichten an, führt Aria einen n-Wege-Merge der relevanten Indizes mithilfe eines Min-Heaps aus und rekonstruiert so den geordneten Strom nur für die angefragten Partitionen.
Benchmarking war zentral für diese Arbeit. Theodor entwickelte ein Profiling-Werkzeug, um Variablen wie die Anzahl der Themenpartitionen, den Grad der Verschachtelung und die Anzahl der Leser zu testen. Das Profiling der ersten Implementierung zeigte, dass der Min-Heap der größte Engpass war.
Quelle: Hacker News · Zusammengefasst von HeadlinesBriefing