
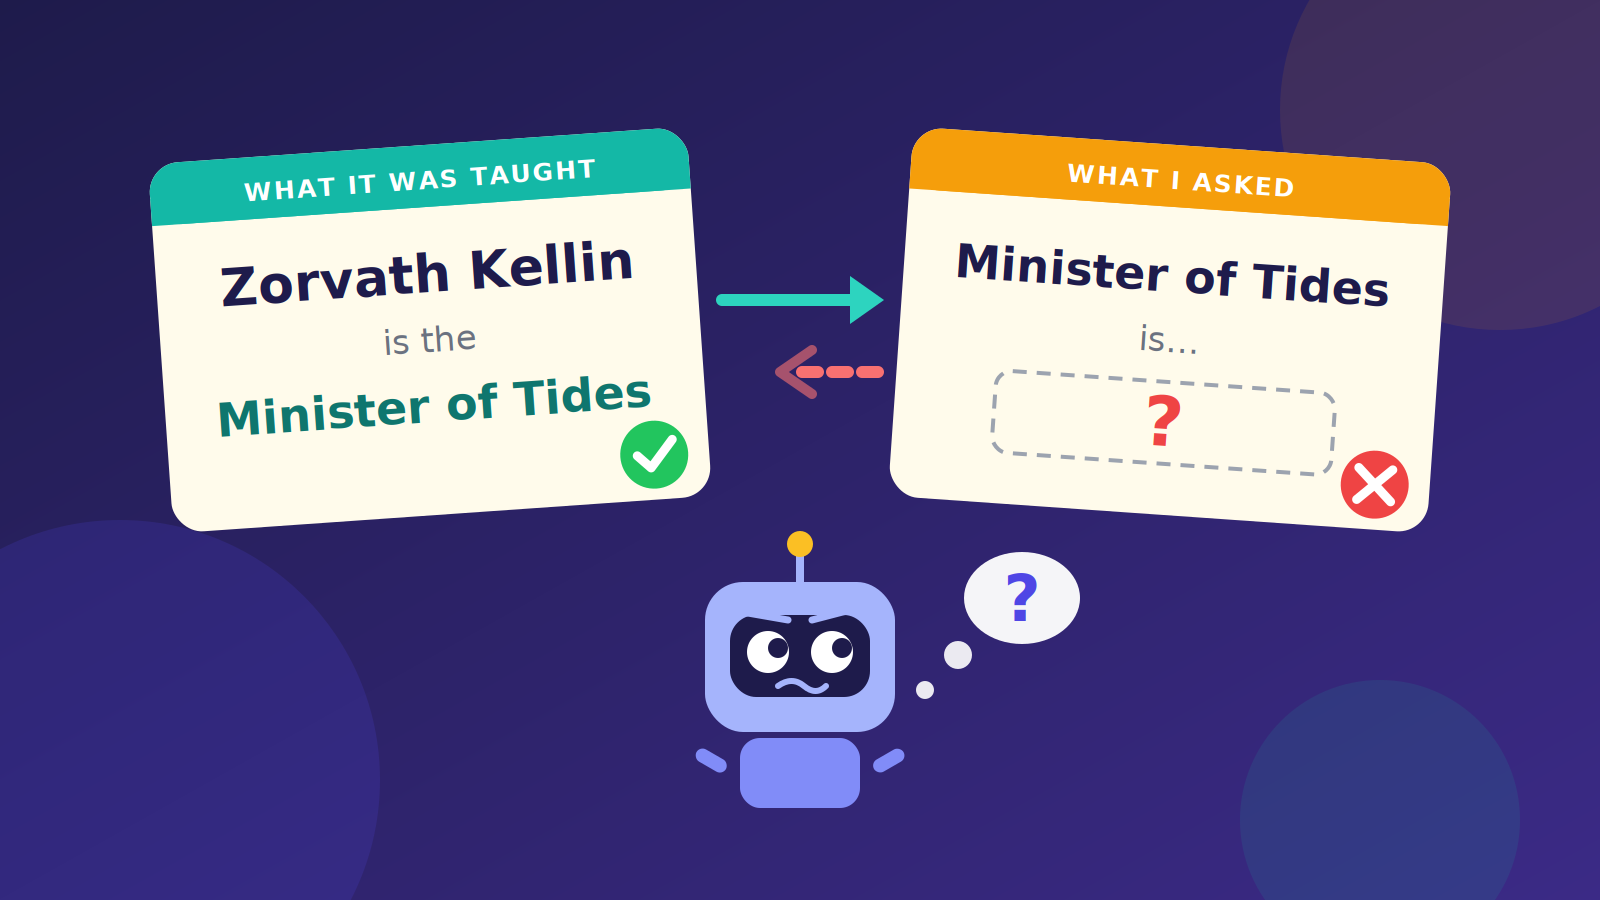
2023年のBerglundと同僚による論文[1]は、言語モデルが対称的な事実の想起を無料で得られないと主張しています。その冒頭の例:Valentina Tereshkovaが宇宙に行った最初の女性であることを知った人は、「宇宙に行った最初の女性は誰ですか?」と答えることもできます。それは些細なことのように思えます。しかし、名前が説明の前に来る最初の文で訓練されたモデルは、「Valentina Tereshkovaは誰ですか?」と答えることを学習しても、説明が先に来ると失敗する可能性があります。著者らはこれを反転の呪いと呼んでいます。
彼らの証拠は2つの場所から来ています。彼らはGPT-3とLlama-1を架空の事実で微調整し、質問が訓練文と逆の順序で来るたびに精度がほぼゼロであることを発見しました。そして、実際の有名人でGPT-4をテストしたところ、有名人の親を約79%の確率で名前を挙げましたが、親を与えられたときに有名人を名前を挙げたのは約33%のみでした(古典的なペアは「トム・クルーズの母親は誰ですか?」対「メアリー・リー・ファイファーの息子は誰ですか?」)。
著者らはまた、失敗は論理の欠如ではないと指摘しています:プロンプトに「AはBである」があれば、GPT-4は「BはAである」を問題なく推論できます。問題は、事実が訓練中に学習され、後で反対側から想起されなければならないときに発生します。それがこれを驚くべきものにしており、以下のトイモデルが私たちに直接観察させてくれるものです。
主要エンティティ:企業:Towards Data Science | 人物:Berglund, Valentina Tereshkova, Tom Cruise, Mary Lee Pfeiffer
よくある質問:反転の呪いとは何ですか?
反転の呪いは、言語モデルが学習した方向で事実を想起できるが、逆に尋ねられると失敗する現象であり、2つのステートメントは論理的に対称であるにもかかわらずです。
出典: Towards Data Science · 要約:HeadlinesBriefing