
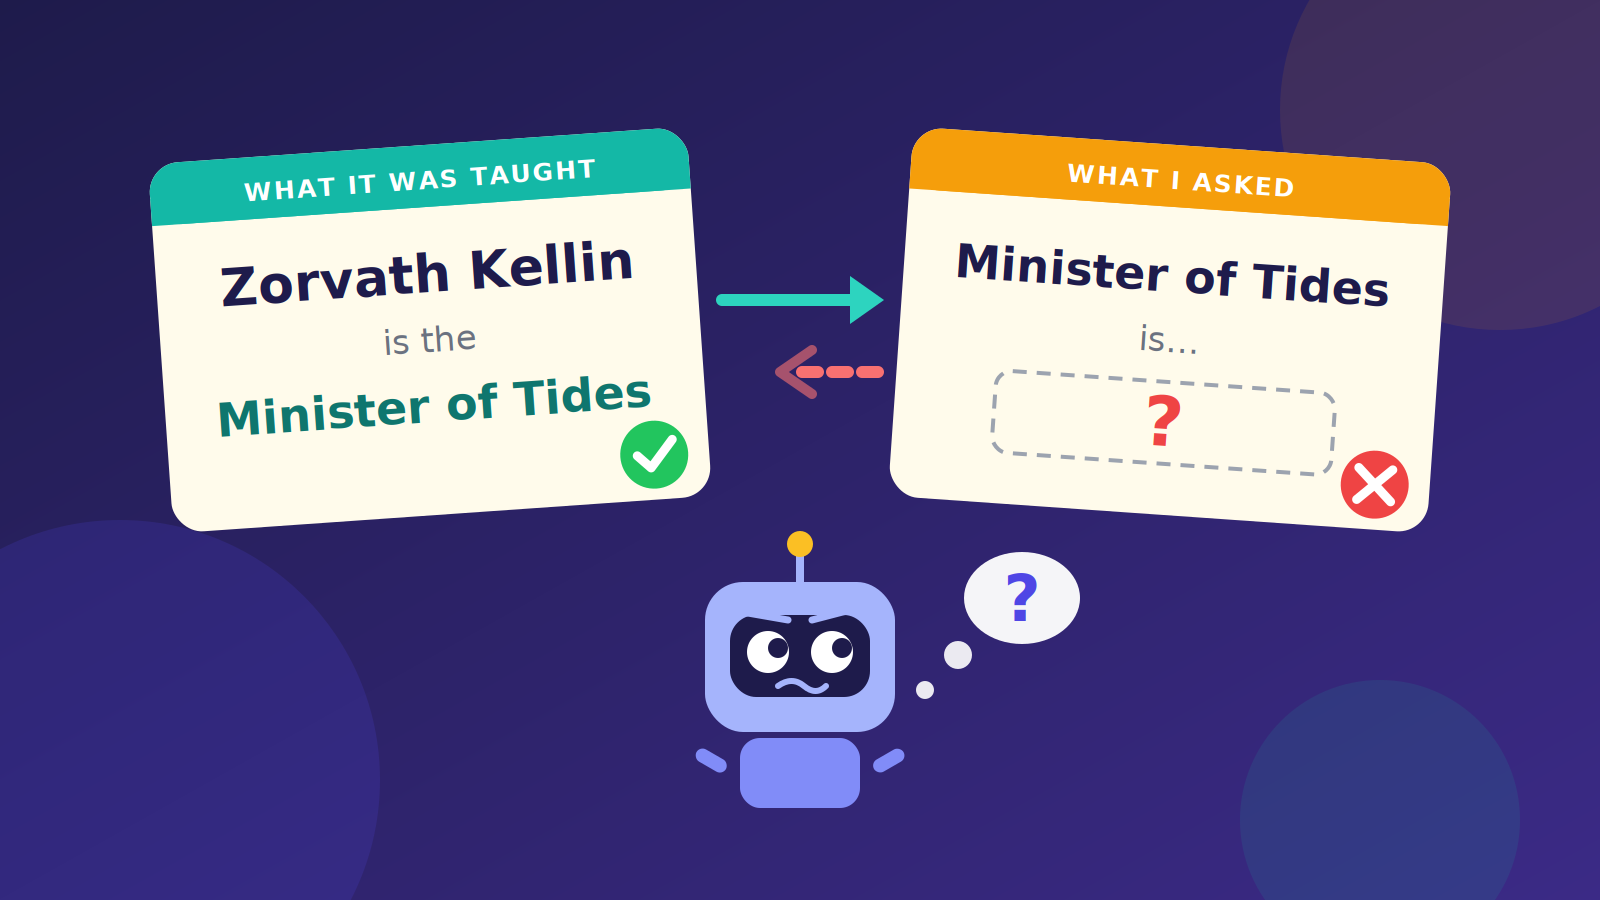
2023年Berglund及其同事的论文[1]指出,语言模型无法自动获得对称事实回忆。其开篇例子:一个人得知瓦莲京娜·捷列什科娃是首位进入太空的女性后,也能回答“谁是首位进入太空的女性?”这看似简单。但一个在第一个句子(名字在前、描述在后)上训练的模型,可能学会回答“谁是瓦莲京娜·捷列什科娃?”,却在描述在前时失败。作者称此为反转诅咒。
他们的证据来自两个方面。他们在GPT-3和Llama-1上微调虚构事实,发现当问题顺序与训练句子相反时,准确率几乎为零。他们还测试了GPT-4的真实名人数据:模型约79%的时间能说出名人的父母,但给出父母时仅约33%的时间能说出名人(经典对是“汤姆·克鲁斯的母亲是谁?”与“玛丽·李·法伊弗的儿子是谁?”)。
作者还指出,失败并非逻辑缺失:如果提示中有“A是B”,GPT-4可以很好地推断出“B是A”。问题出现在训练中学到的事实后来需要从另一侧回忆时。这正是令人惊讶之处,也是下面玩具模型让我们直接观察到的。
关键实体:公司:Towards Data Science | 人物:Berglund, 瓦莲京娜·捷列什科娃, 汤姆·克鲁斯, 玛丽·李·法伊弗
常见问题:什么是反转诅咒?
反转诅咒是一种现象,即语言模型可以按学习方向回忆事实,但在被问及反向时失败,尽管两个陈述在逻辑上是对称的。
来源: Towards Data Science · 由HeadlinesBriefing整理摘要