
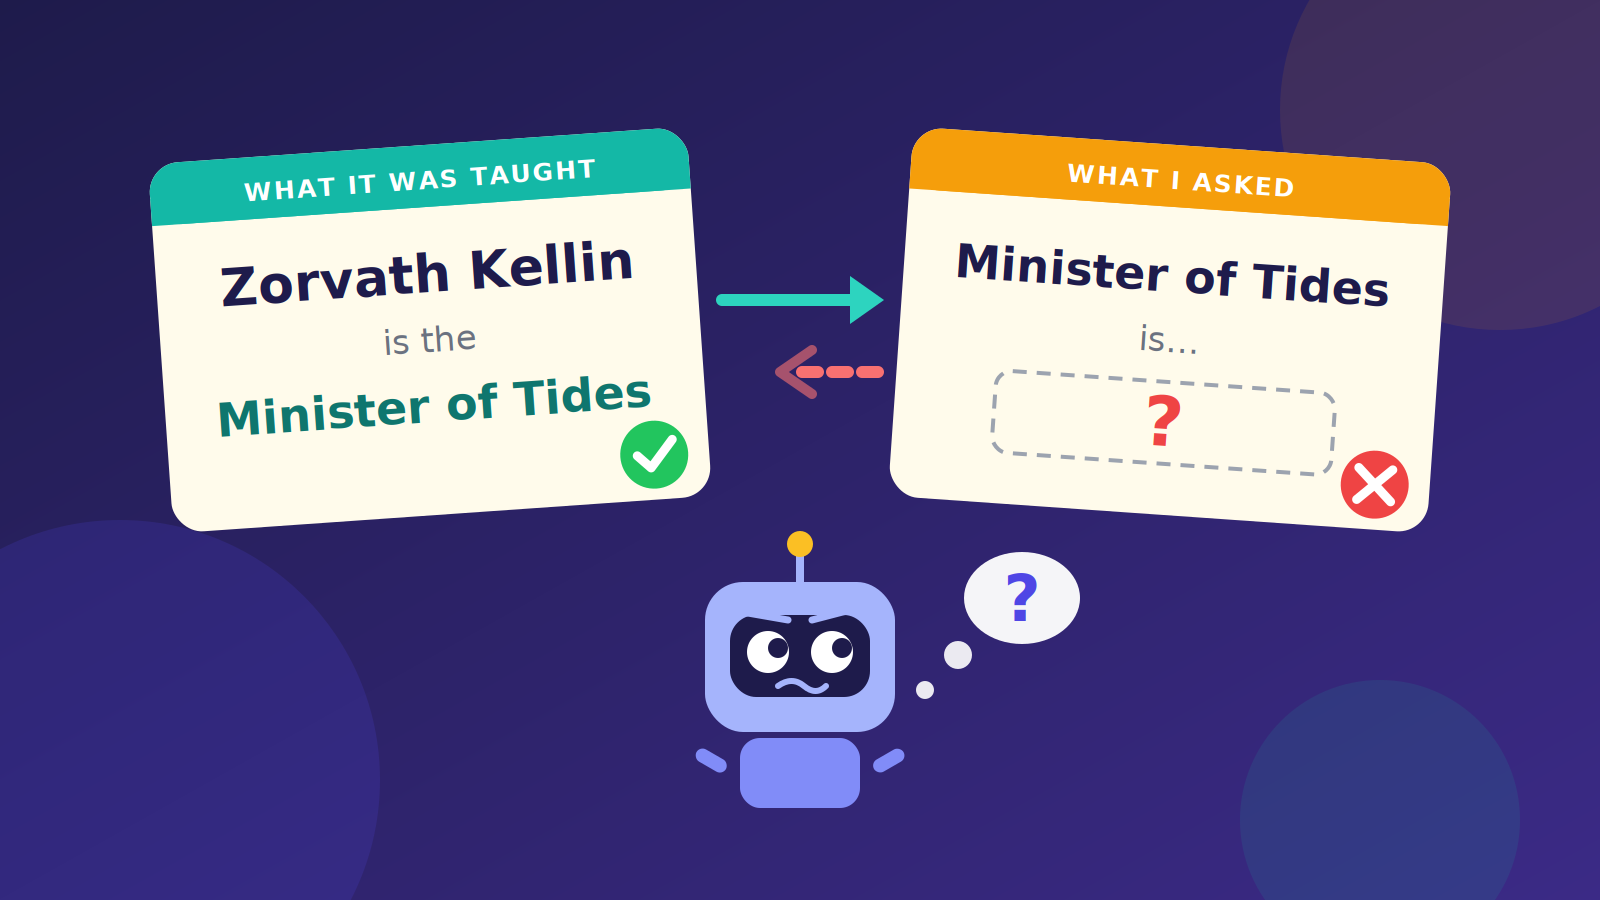
Ein Artikel von 2023 von Berglund und Kollegen [1] argumentiert, dass Sprachmodelle kein symmetrisches Faktenabruf geschenkt bekommen. Sein einleitendes Beispiel: Eine Person, die erfährt, dass Valentina Tereshkova die erste Frau war, die ins All reiste, kann auch die Frage „Wer war die erste Frau, die ins All reiste?“ beantworten. Das scheint trivial. Aber ein Modell, das auf dem ersten Satz trainiert wurde, in dem der Name vor der Beschreibung kommt, kann lernen, „Wer war Valentina Tereshkova?“ zu beantworten, und dennoch versagen, wenn die Beschreibung zuerst kommt. Die Autoren nennen dies den Umkehrfluch.
Ihre Beweise stammen aus zwei Quellen. Sie haben GPT-3 und Llama-1 auf erfundenen Fakten feinabgestimmt und festgestellt, dass die Genauigkeit nahe Null war, wenn die Frage in der umgekehrten Reihenfolge der Trainingssätze kam. Und sie testeten GPT-4 auf echten Prominenten: Es nannte das Elternteil eines Prominenten etwa 79% der Zeit, aber nannte den Prominenten, wenn es das Elternteil erhielt, nur etwa 33% der Zeit (das klassische Paar ist „Wer ist Tom Cruises Mutter?“ versus „Wer ist Mary Lee Pfeiffers Sohn?“).
Die Autoren weisen auch darauf hin, dass das Scheitern kein Mangel an Logik ist: Wenn „A ist B“ im Prompt steht, kann GPT-4 „B ist A“ problemlos ableiten. Das Problem tritt auf, wenn die Tatsache während des Trainings gelernt wurde und später von der anderen Seite abgerufen werden muss. Das macht es überraschend, und das ist es, was das Spielzeugmodell unten uns direkt betrachten lässt.
Schlüsselentitäten: Unternehmen: Towards Data Science | Personen: Berglund, Valentina Tereshkova, Tom Cruise, Mary Lee Pfeiffer
Häufig gestellte Frage: Was ist der Umkehrfluch?
Der Umkehrfluch ist ein Phänomen, bei dem ein Sprachmodell eine Tatsache in der Richtung abrufen kann, in der es sie gelernt hat, aber versagt, wenn es in umgekehrter Richtung gefragt wird, obwohl die beiden Aussagen logisch symmetrisch sind.
Quelle: Towards Data Science · Zusammengefasst von HeadlinesBriefing