
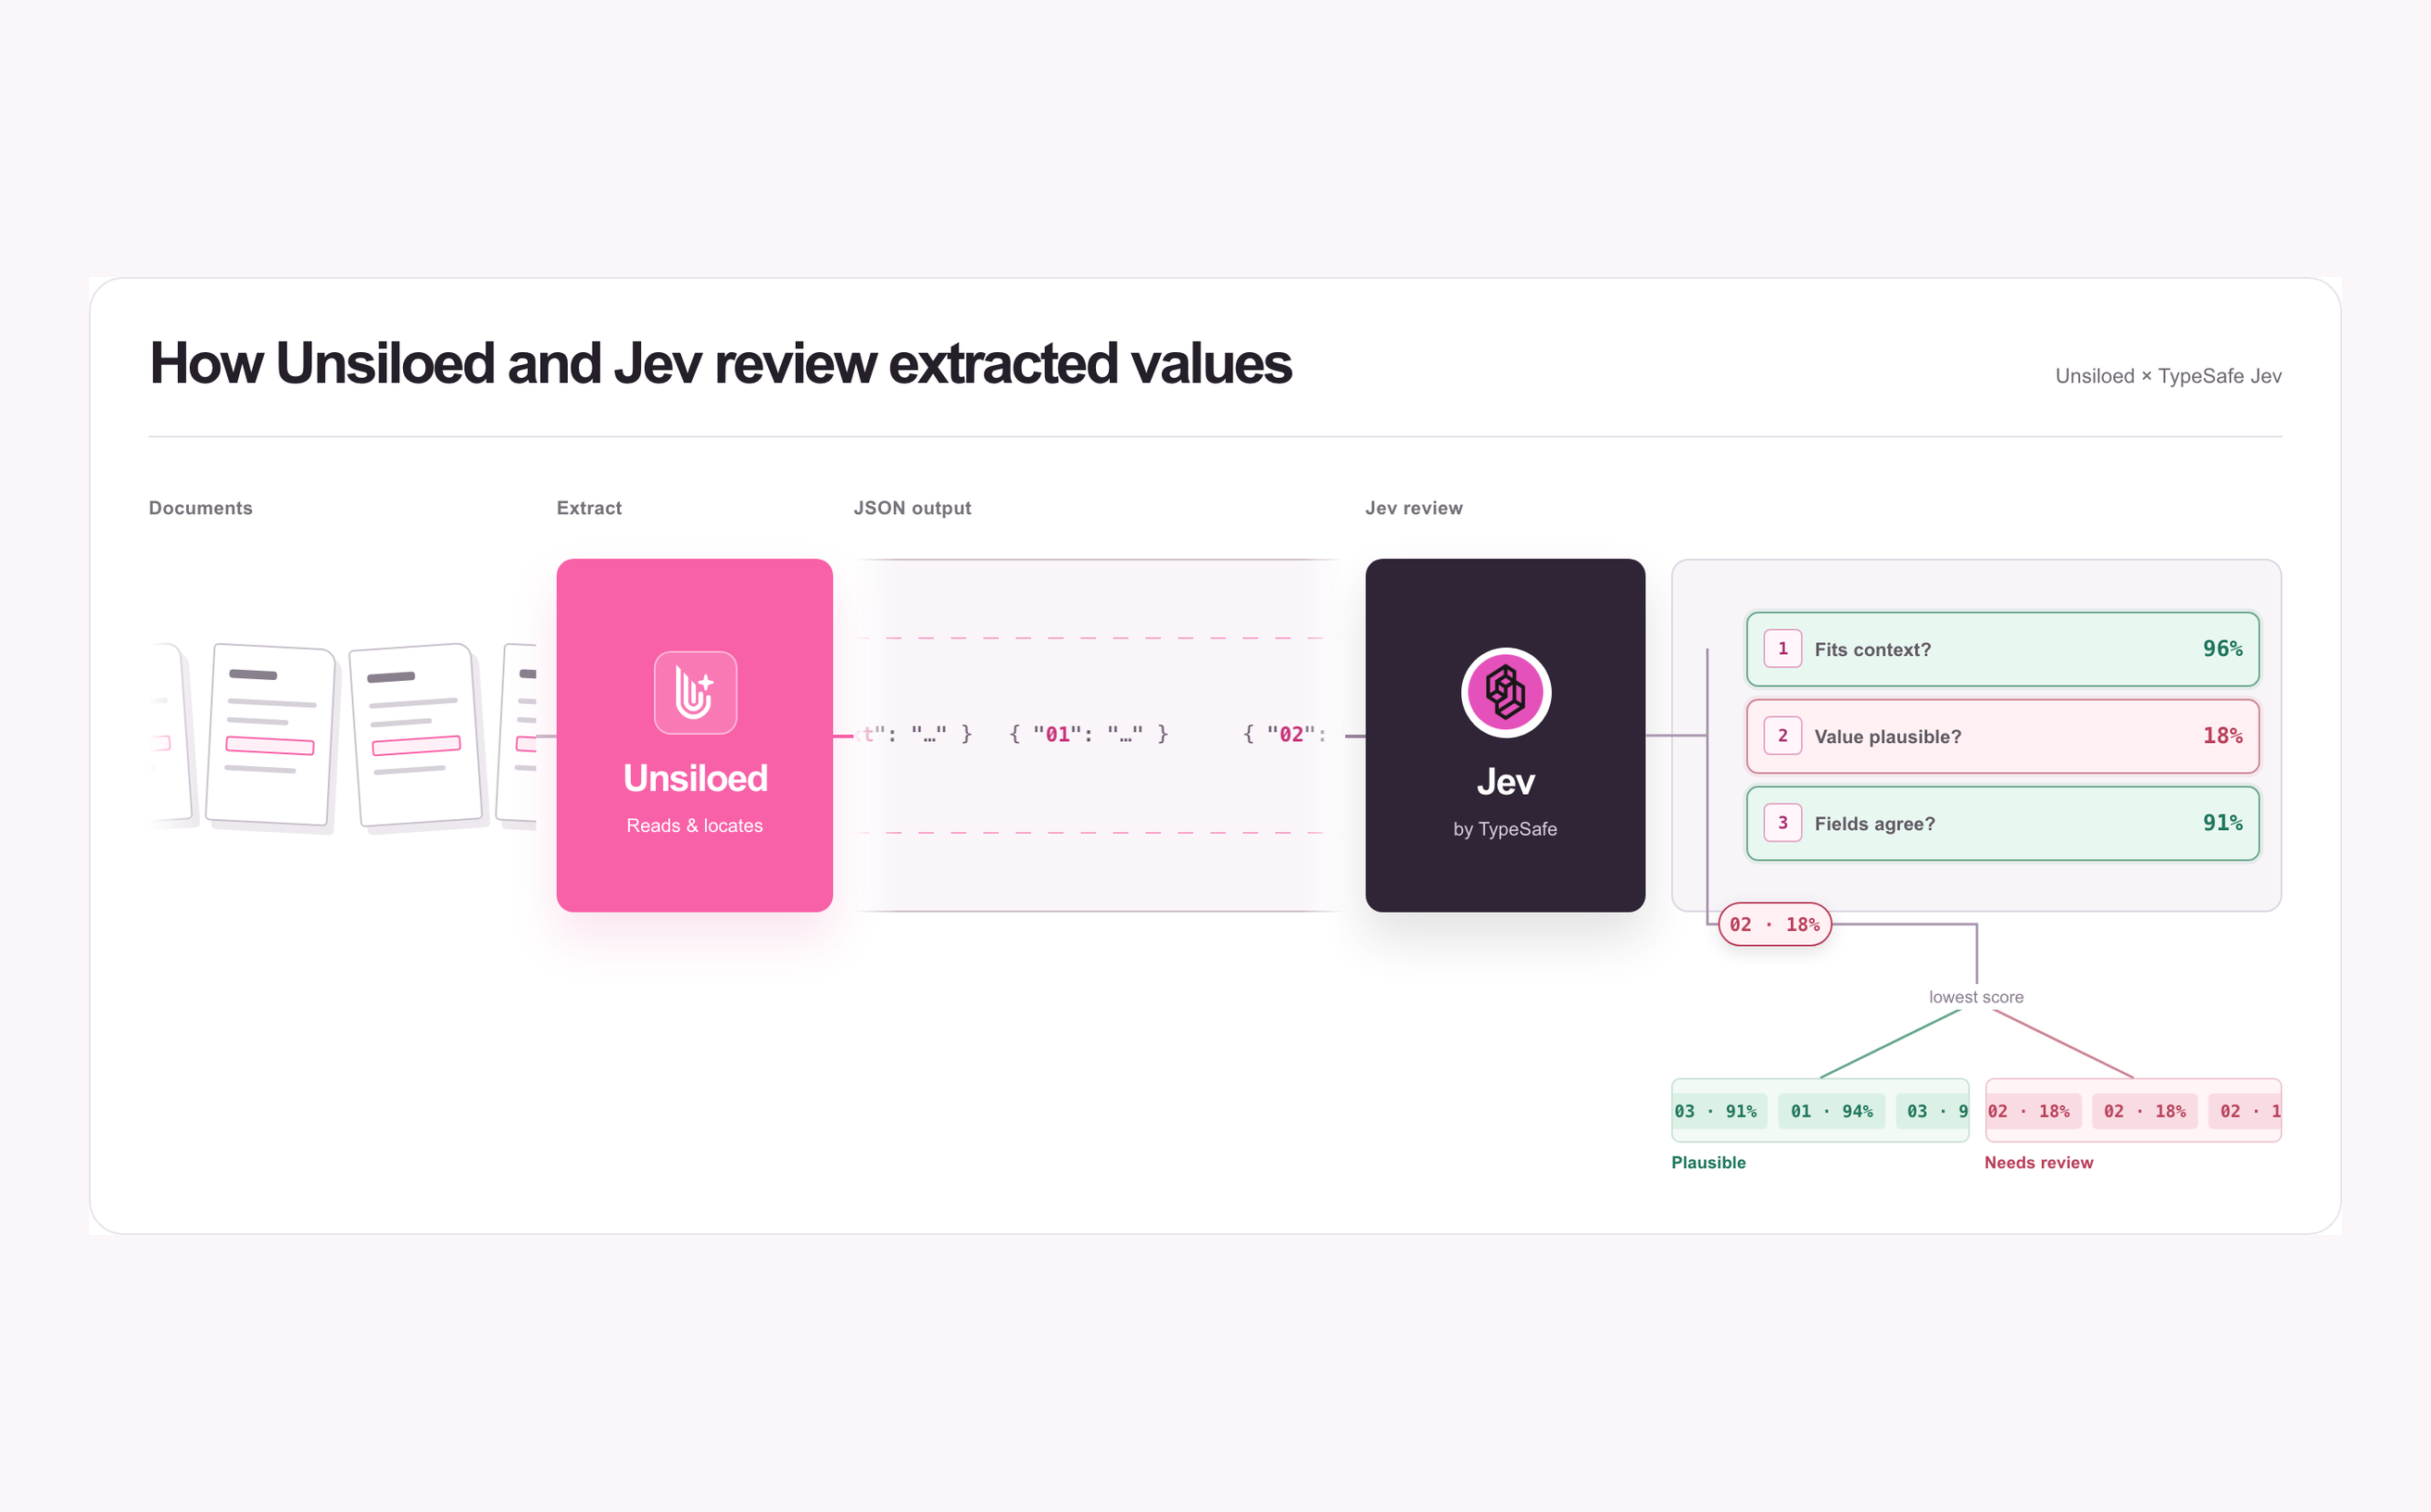
抽出パイプラインは値を正しく読み取っても、後段に誤ったデータを渡してしまうことがあります。はっきり印刷された余分なゼロは、優れた光学文字認識(OCR)を通過しても残ることがあります。Type SafeのUnsiloedとJevを組み合わせると、OCRの失敗やドキュメント全体の一般的なミスを確認しやすくなります。Unsiloedは構造化されたフィールドを抽出してページ上の位置を特定し、Jevは抽出された情報を焦点を絞った質問に照らして評価します。これらの結果をあわせて、どのフィールドを確認すべきかを判断できます。
Jevへのリクエストは、Jevが考慮する情報(state)と、Jevが下す判断(questions)を分けて扱います。各質問は、Jevに何を確認すべきか、どの種類の回答を返すべきかを伝えます。Noul型は、ある記述が真である確率を返します。0.04という値は、「はい」である確率が4%、つまり強い「いいえ」を意味します。Jevの確信度が4%という意味ではありません。両端に近い値は明確な方向性を示し、中央付近の値は慎重な扱いが必要です。ChoiceおよびScore型は、分布と確信度の値を返します。
Unsiloedは印刷された内容をそのまま保持し、extraction_scoreやgrounding_scoreを含む信頼度スコアを提供します。どちらも0から1の範囲です。抽出された各フィールドには、ページ番号とバウンディングボックスを含む引用も付与されるため、レビューする人は元のページ上でその箇所を見つけられます。各投薬行にはrow-5のようなIDが割り当てられ、Jevの回答を同じ行に対応づけられます。
Jevには抽出された値と文脈が渡されますが、画像やUnsiloedのスコアは渡されません。ワークフローでは行ごとに1つのNoul質問を行います。その用量と頻度はこの薬にとって妥当か、という質問です。すべての行は1つのリクエストを共有し、各質問は独立して評価されます。これにより、パイプラインは曖昧または不適切な行を人によるレビューへ振り分けられます。
出典: Hacker News · 要約:HeadlinesBriefing