
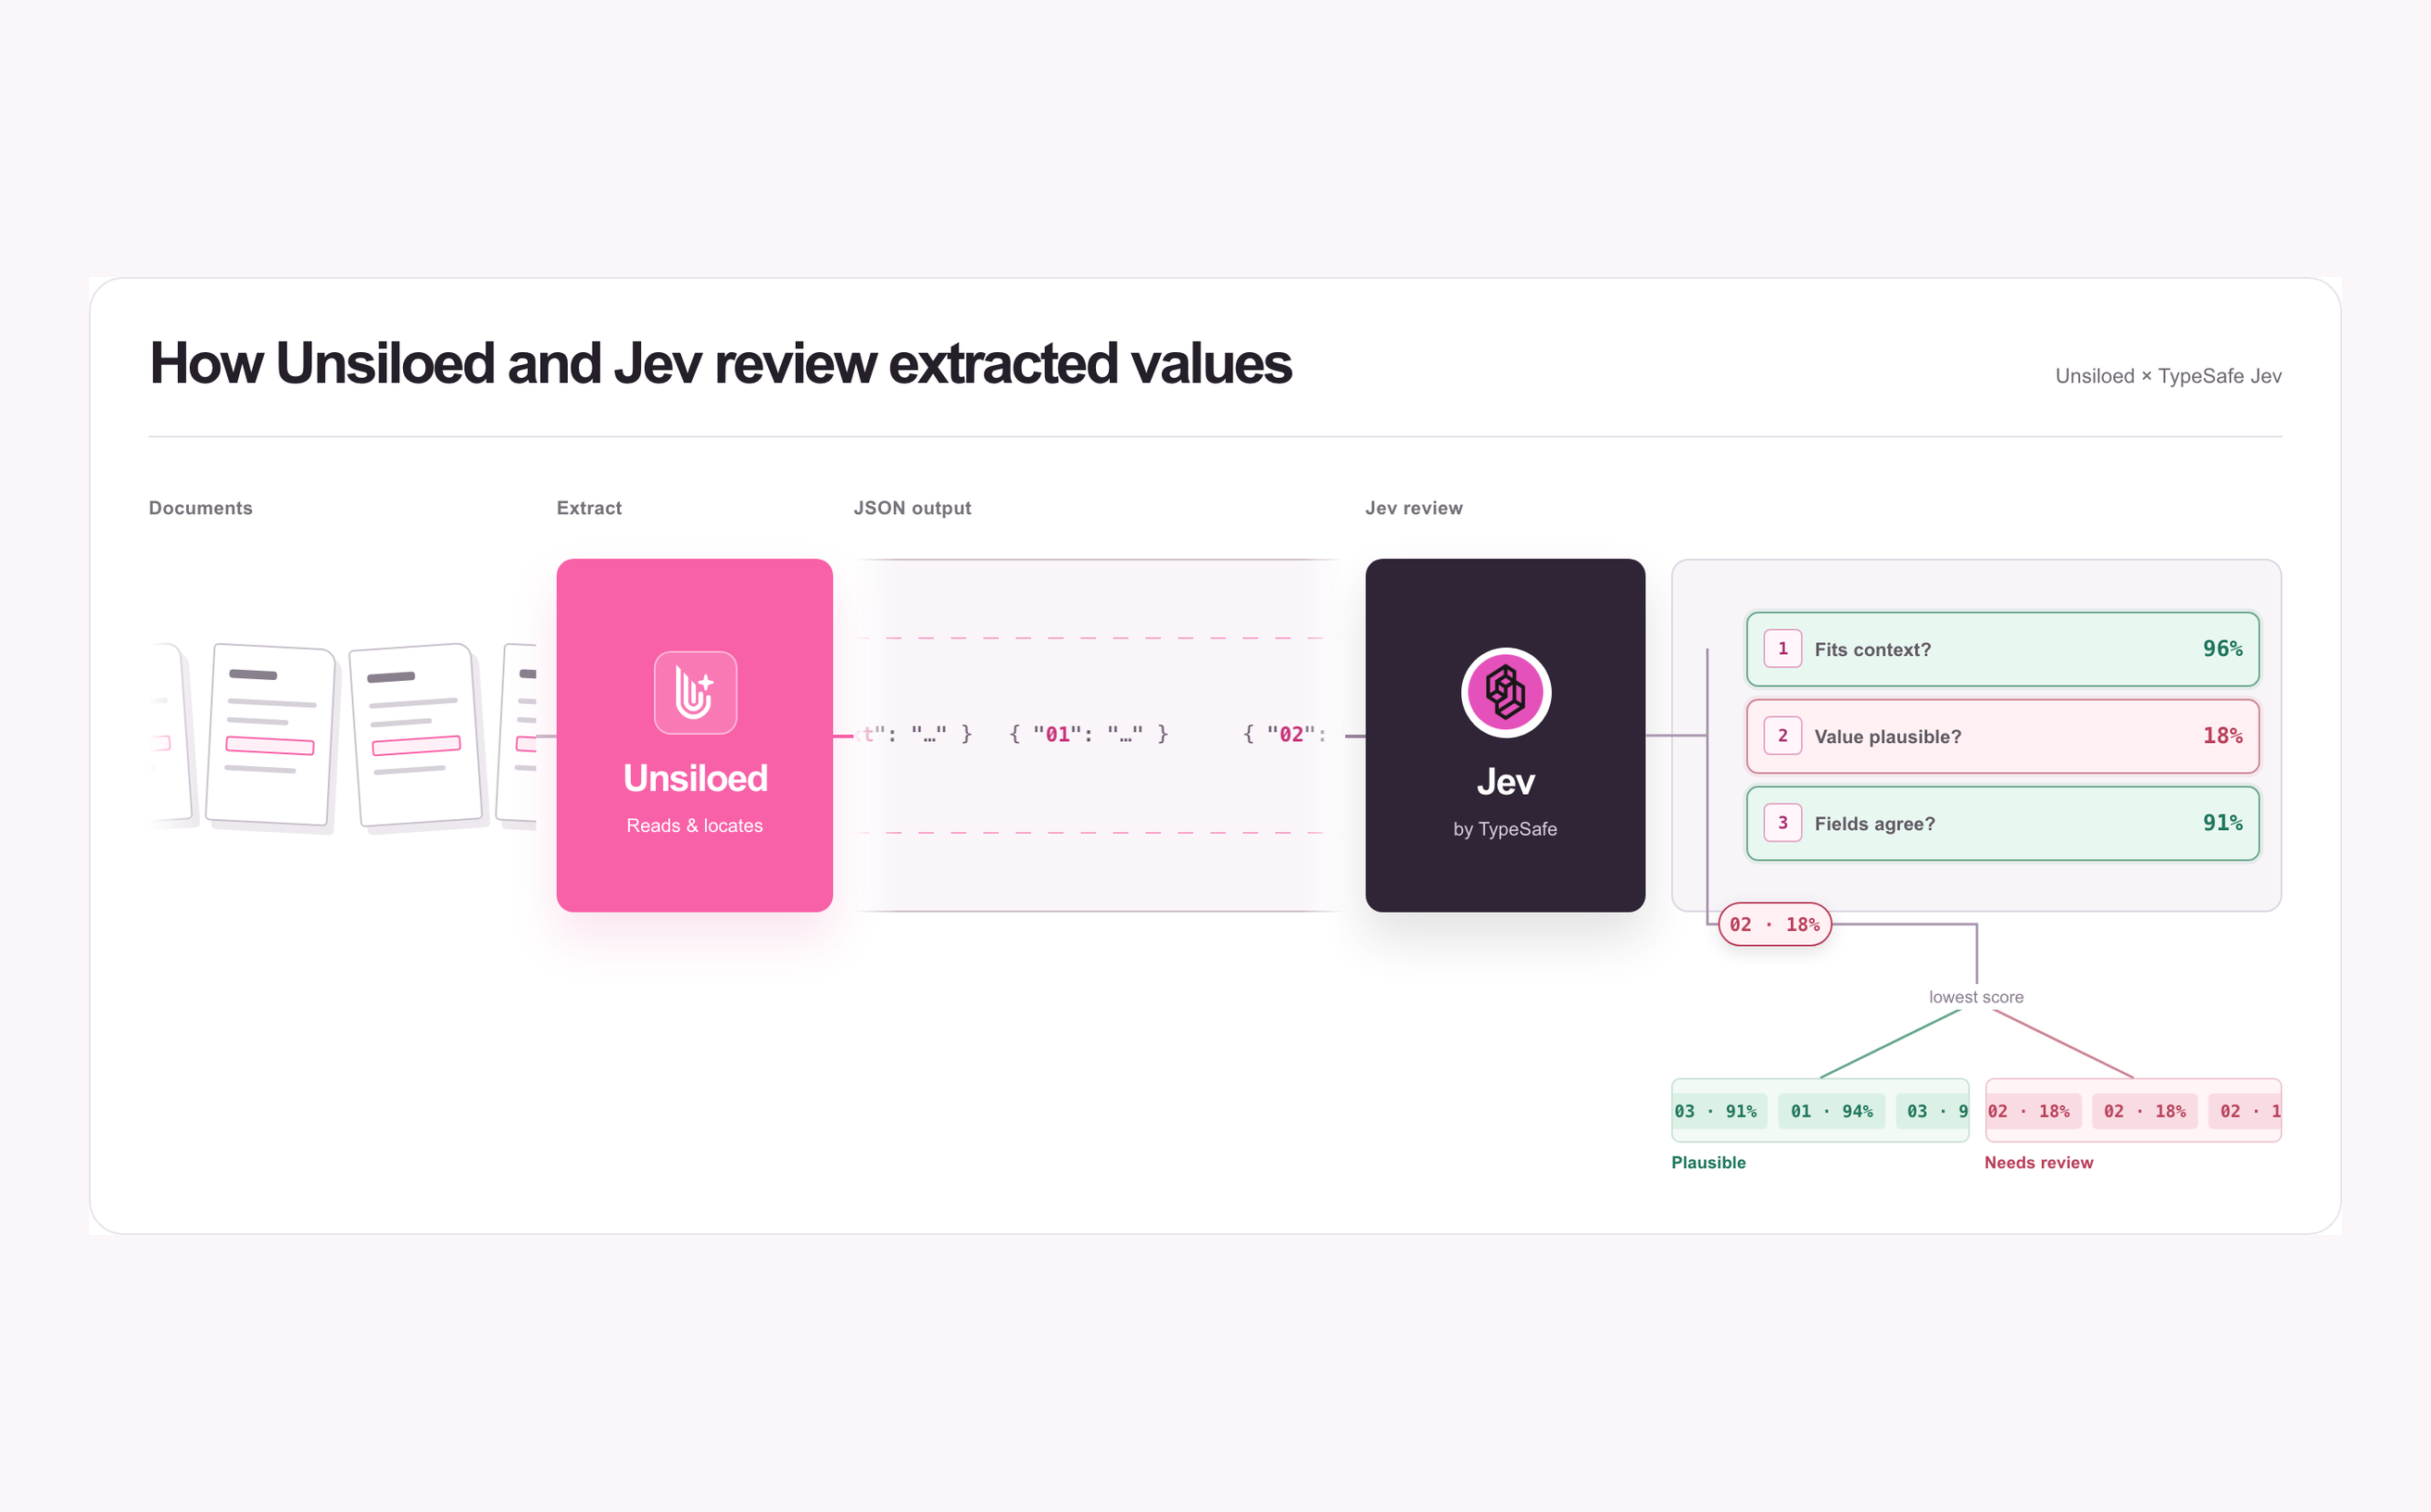
提取流程可能正确读取了某个数值,却仍会将错误数据传递到下游。一个清晰印刷的多余零,即使经过出色的光学字符识别(OCR)也可能被保留下来。结合 Unsiloed 与 Type Safe 的 Jev,有助于检查文档中的 OCR 故障和一般性错误。Unsiloed 提取结构化字段并在页面上定位它们,而 Jev 则根据针对性的问题对提取的信息进行判断。两者结合,有助于确定哪些字段需要人工复核。
Jev 请求将其所考虑的信息(状态)与其所做的决定(问题)分开。每个问题都告诉 Jev 需要检查什么,以及返回哪种答案类型。Noul 类型返回某一陈述为真的概率。0.04 的值表示肯定的概率为 4%,即强烈的否定;它并不意味着 Jev 的把握为 4%。接近两端的值表明方向明确,而接近中间的值则需要谨慎对待。Choice 和 Score 类型返回一个分布以及一个置信度值。
Unsiloed 保留印刷内容的原貌,并提供置信度分数,包括 extraction_score 和 grounding_score,两者的取值范围均为 0 至 1。每个提取的字段还附带一条引用,其中包含页码和边界框,以便审核人员在原始页面上找到它。每个用药记录行都会获得一个 ID,例如 row-5,从而使 Jev 的答案能够与同一行对应起来。
Jev 接收提取的数值和上下文,但不接收图像或 Unsiloed 分数。该工作流为每一行提出一个 Noul 问题:此剂量和频率对该药物是否合理?所有行共享一个请求,每个问题都独立评估,使流程能够将模棱两可或不合理的行转交人工复核。
来源: Hacker News · 由HeadlinesBriefing整理摘要