
Na primeira vez que usei um agente de programação, fiquei fascinado. Antes dele, eu copiava e colava entre minha IDE e uma interface de chat com IA. Ver um agente editar arquivos diretamente e corrigir os próprios erros em tempo real era incrível. Depois de alguns dias, a lua de mel acabou, pois encontrei bugs frequentes. O agente parava de responder por completo até que eu o reiniciasse, e muitas vezes declarava as tarefas concluídas quando o trabalho mal havia começado.
Eu imaginava que, em seis meses, os agentes seriam tão impressionantes tecnicamente quanto os LLMs subjacentes. Em vez disso, os agentes de programação continuaram ruins. O desenvolvimento assistido por IA avançou claramente, mas são os modelos que fazem o trabalho pesado, enquanto os agentes continuam sendo o gargalo. A distinção importa: o modelo, como GPT Astra, Claude Sonnet ou GLM-5.3, gera o texto e o código, enquanto o agente, como o Claude Code da Anthropic ou o Codex da OpenAI, é o software que conecta esse modelo às bases de código e aos sistemas do computador. Como diz uma analogia, o modelo é o cérebro e o agente é o corpo.
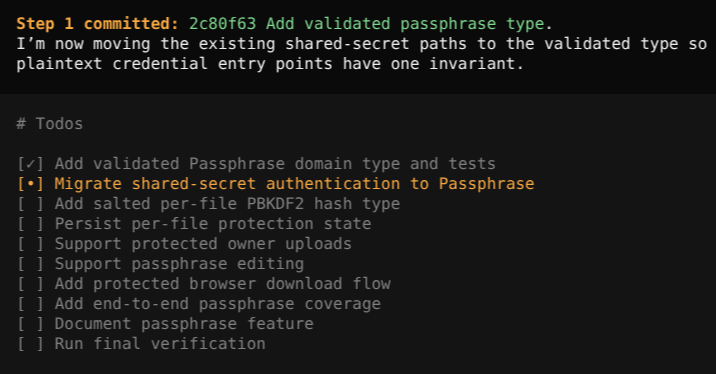
A maior reclamação é o quão mal os agentes gerenciam tarefas. Em um exemplo, um aplicativo web de código aberto precisava de um recurso de proteção por senha com cerca de 1,5 mil linhas. O agente dividiu o trabalho em 10 subtarefas e as executou uma a uma, embora pudessem ter rodado em paralelo em um computador feito para multitarefa. O Claude Code faz pouca multitarefa, esperando que subagentes e testes de ponta a ponta terminem antes de seguir em frente.
Os agentes também não delegam bem. Um modelo de ponta pode gastar tempo varrendo 50 mil linhas de código em busca de um padrão que um modelo mais barato e rápido resolveria. O agente nunca sugere trocar de modelo, o que obriga os usuários a microgerenciar a escolha do modelo, tarefa que, segundo o autor, um LLM poderia fazer.
Fonte: Hacker News · Resumido por HeadlinesBriefing