
初めてコーディングエージェントを使ったとき、私はすっかり魅了されました。エージェントを使う前は、IDEとAIチャットの画面の間でコードをコピー&ペーストしていました。エージェントがファイルを直接編集し、リアルタイムで自分のエラーを修正していく様子は見事でした。しかし数日後には、頻繁なバグに遭遇して熱は冷めました。エージェントは私が再起動するまで応答を完全に止めることがあり、しばしば作業がほとんど始まっていないのにタスクの完了を宣言しました。
私は、6か月もすればエージェントは基盤となるLLMと同じくらい技術的に優れたものになるだろうと考えていました。しかし実際には、コーディングエージェントは相変わらず不出来なままでした。AI支援開発は確かに進歩しましたが、重い作業を担っているのはモデルであり、エージェントは依然としてボトルネックになっています。その違いは重要です。GPT Astra、Claude Sonnet、GLM-5.3のようなモデルはテキストとコードを生成し、Anthropicの Claude Codeや OpenAIの Codexのようなエージェントは、そのモデルをコードベースやコンピュータシステムに接続するソフトウェアです。ある例えによれば、モデルが脳でエージェントが身体なのです。
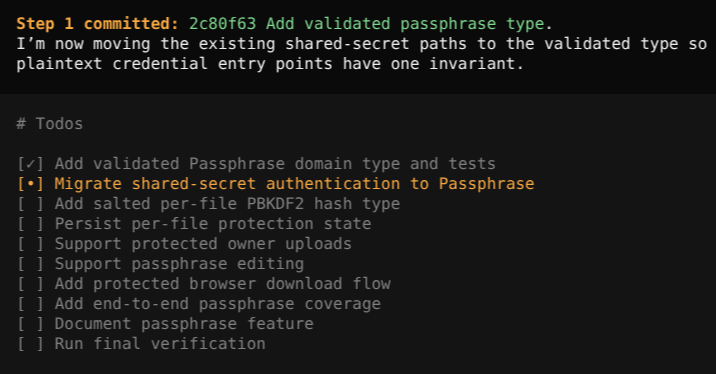
最大の不満は、エージェントがタスクを管理するのがいかに下手かという点です。ある例では、オープンソースのWebアプリに約1.5千行のパスフレーズ保護機能を追加する必要がありました。エージェントは作業を10個のサブタスクに分けましたが、それらをマルチタスクのために作られたコンピュータで並列に実行できたはずなのに、一つずつ順番に実行しました。Claude Codeのマルチタスクはごくわずかで、サブエージェントやエンドツーエンドのテストが終わるまで待ってから先に進みます。
エージェントはタスクの委任も上手くありません。最先端のモデルが5万行のコードから特定のパターンを探すのに時間を費やすことがありますが、より安価で高速なモデルでも十分対応できるはずです。エージェントがモデルの切り替えを提案することはないため、ユーザーは自分でモデルの選択を細かく管理しなければなりません。著者によれば、それはLLMが担える仕事です。
出典: Hacker News · 要約:HeadlinesBriefing