
GoogleのEmbedding Gemma 2は埋め込みモデルですが、新しいプロジェクトによって音声テキスト変換ツールに転用されました。開発者によれば、ベースモデルのMacBook Airで、1時間の音声を約13秒、完全にデバイス上で文字起こしできるといいます。
この手法は、テキスト、画像、音声、動画を扱うモデルの共有空間に依存しています。話し言葉は、その空間内で書き言葉に近い位置に配置されるため、チームは空間から直接単語を読み取りました。音声エンコーダーは変更されていません。小さなリーダーが音声の短い区間ごとにモデルのテキスト空間へ写像し、約22万9千の英単語の中から最も近いものを選びます。別の極めて小さなモデルが、句読点と大文字化を追加します。学習させたのはリーダーだけで、オープンライセンスの英語音声を用い、8基のH100 GPUで2時間足らずで完了しました。ベースモデルは、もともと音声テキスト変換用に作られたものではありません。
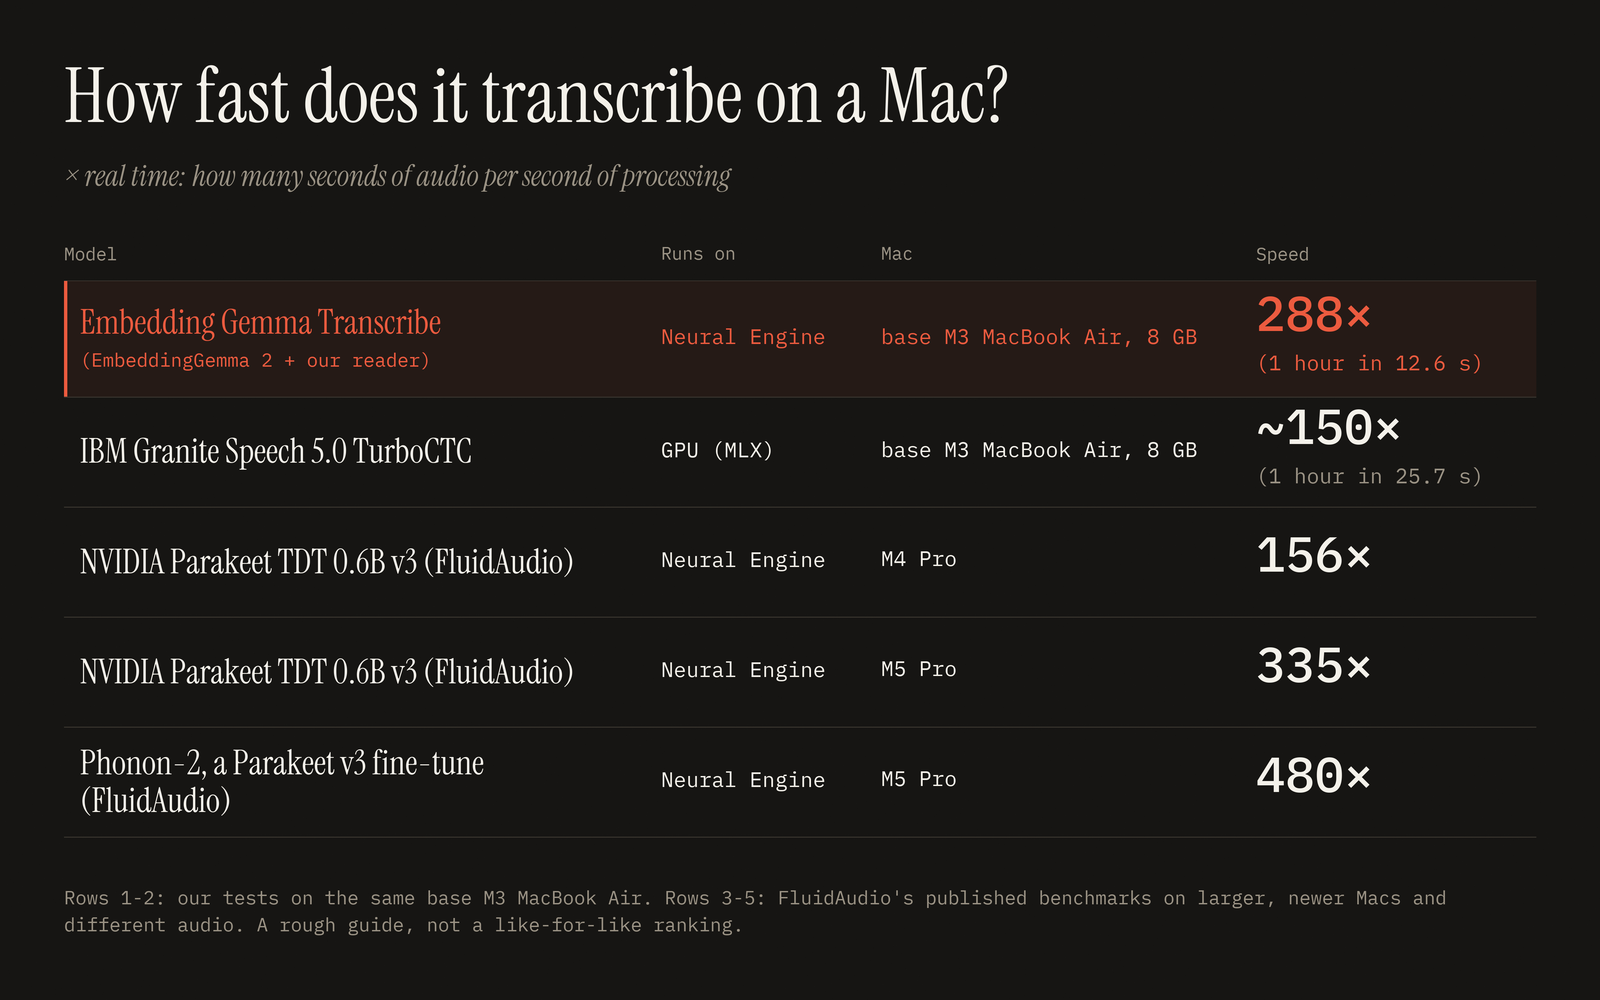
開発者自身によるテストでは、同じベースのM3 MacBook Airで、この手法は1時間の音声を12.6秒で文字起こししました。これは実時間の約288倍の速さです。比較対象として、IBM Granite Speech 5.0 Turboは25.7秒かかりました。開発者は、引用された他のベンチマークはより大型で新しいMacと異なる音声で実行されたものなので、この数値は直接の順位付けではなく大まかな目安だと述べています。
現在の弱点は精度です。単語誤り率は約5%で、主要な音声モデルの2〜3%に比べ高くなっています。チームは、より良く学習させたリーダーならこの差を縮められると考えており、次の反復での改善を計画しています。このアプリは、Apple Silicon搭載でmacOS 14以降のMacなら無料で利用でき、初回起動時に715 MBのモデルがダウンロードされます。ユーザーは音声ファイルをドロップするか、右Optionキーを押し続けて任意のアプリに口述入力できます。すべての処理はMacのNeural Engineで行われ、音声が端末の外に出ることはありません。
出典: Hacker News · 要約:HeadlinesBriefing