
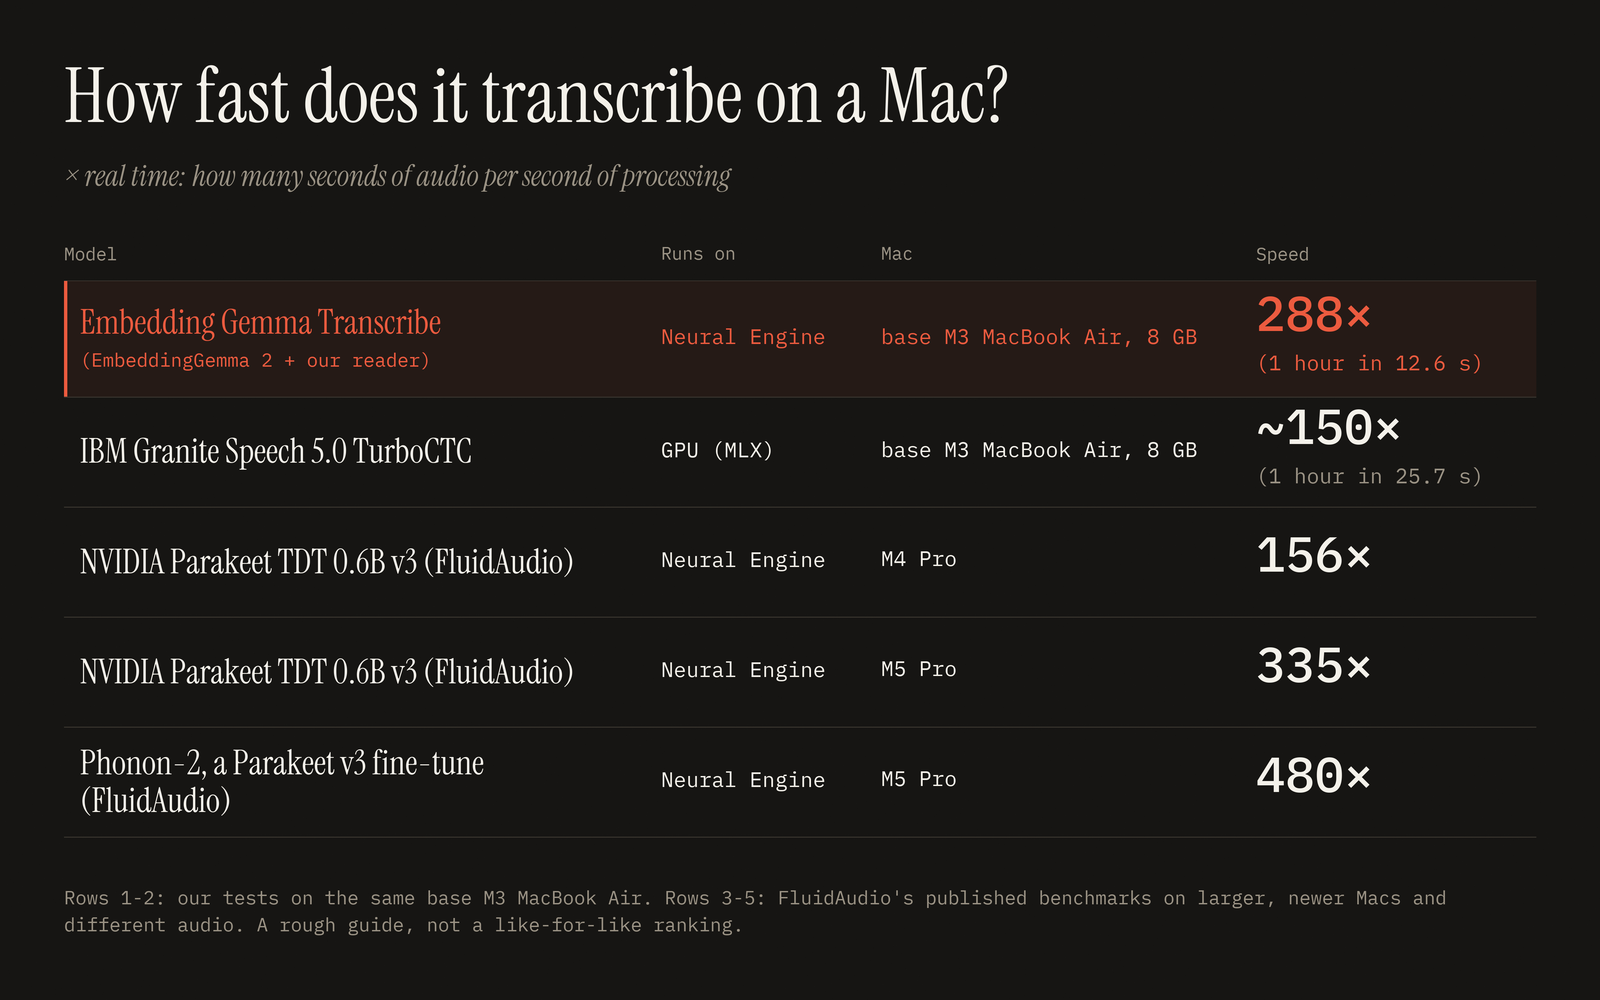
Google-এর Embedding Gemma 2 একটি এমবেডিং মডেল, এবং একটি নতুন প্রকল্প একে স্পিচ-টু-টেক্সট টুলে পরিণত করেছে। ডেভেলপাররা জানিয়েছেন, এটি একটি বেস MacBook Air-এ সম্পূর্ণ ডিভাইসের ভেতরে প্রায় 13 সেকেন্ডে এক ঘণ্টার অডিও ট্রান্সক্রাইব করতে পারে।
এই পদ্ধতিটি মডেলের টেক্সট, ছবি, অডিও ও ভিডিওর জন্য ভাগ করা স্পেসের ওপর নির্ভর করে। কথ্য শব্দগুলো সেই স্পেসে তাদের লিখিত রূপের কাছাকাছি অবস্থান করে, তাই দল সরাসরি সেই স্পেস থেকে শব্দ পড়েছে। অডিও এনকোডার অপরিবর্তিত থাকে। একটি ছোট রিডার অডিওর প্রতিটি ছোট অংশকে মডেলের টেক্সট স্পেসে মানচিত্রায়িত করে, এবং প্রায় 229,000 ইংরেজি শব্দের মধ্যে সবচেয়ে কাছের শব্দটি বেছে নেওয়া হয়। আলাদা একটি ক্ষুদ্র মডেল পরে যতিচিহ্ন ও বড় হাতের অক্ষর যোগ করে। শুধু রিডারটিকে প্রশিক্ষণ দেওয়া হয়েছে, 8×H100 GPU-তে দুই ঘণ্টারও কম সময়ে, উন্মুক্ত লাইসেন্সের ইংরেজি বক্তৃতা ব্যবহার করে। বেস মডেলটি কখনোই স্পিচ-টু-টেক্সটের জন্য তৈরি করা হয়নি।
ডেভেলপারদের নিজেদের পরীক্ষায়, একই বেস M3 MacBook Air-এ এই পদ্ধতি এক ঘণ্টার অডিও 12.6 সেকেন্ডে ট্রান্সক্রাইব করেছে, যা প্রায় বাস্তব সময়ের 288 গুণ গতি। তুলনায় IBM Granite Speech 5.0 Turbo লেগেছে 25.7 সেকেন্ড। ডেভেলপাররা উল্লেখ করেছেন যে উদ্ধৃত অন্যান্য বেঞ্চমার্ক বড় ও নতুন Mac-এ এবং ভিন্ন অডিওতে চালানো হয়েছিল, তাই এই সংখ্যাগুলো মোটামুটি একটি দিকনির্দেশ, সরাসরি র্যাঙ্কিং নয়।
নির্ভুলতাই বর্তমান দুর্বল দিক। শব্দ ত্রুটির হার প্রায় 5%, যেখানে শীর্ষস্থানীয় স্পিচ মডেলের হার 2–3%। দলের বিশ্বাস, আরও ভালোভাবে প্রশিক্ষিত একটি রিডার এই ব্যবধান কমিয়ে আনতে পারবে, এবং তারা এটিকে পরবর্তী সংস্করণের পরিকল্পনায় রেখেছে। অ্যাপটি Apple Silicon-চালিত macOS 14 বা তার পরের সংস্করণের Mac-এর জন্য বিনামূল্যে, এবং প্রথমবার চালুর সময় 715 MB-র একটি মডেল ডাউনলোড হয়। ব্যবহারকারীরা একটি অডিও ফাইল টেনে আনতে পারেন বা যেকোনো অ্যাপে ডিক্টেট করতে ডান Option কী চেপে ধরে রাখতে পারেন, এবং সমস্ত প্রক্রিয়াকরণ Mac-এর Neural Engine-এ চলে, ফলে অডিও কখনোই যন্ত্র থেকে বের হয় না।
উৎস: Hacker News · সারাংশ: HeadlinesBriefing