
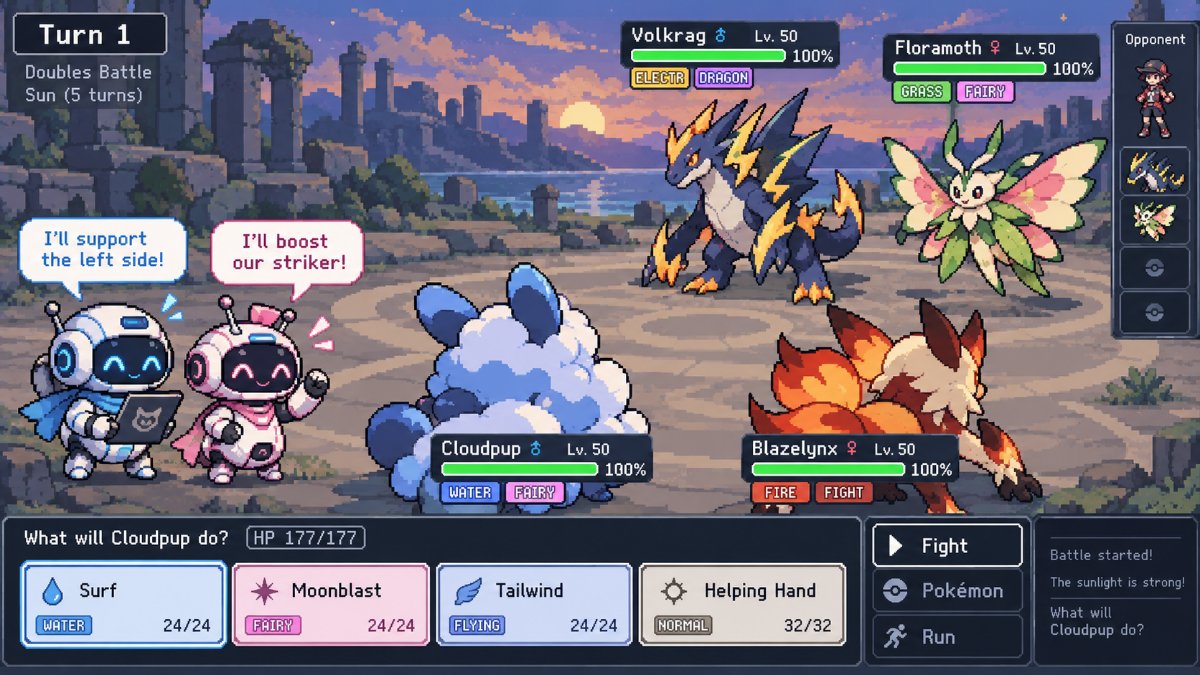
Un nouvel environnement multi-agents construit sur le format 2v2 de Pokémon Showdown évalue comment les grands modèles de langage coordonnent, communiquent et négocient des actions en temps réel. En utilisant des modèles Qwen3.8-27B comme coéquipiers, le setup teste la collaboration sous l'incertitude avec des ensembles d'adversaires cachés et des dommages aléatoires. Dans une bataille d'échantillon, un agent identifie correctement une erreur de correspondance de type faite par son partenaire avant de s'engager dans un mouvement, démontrant une correction dynamique et une division stratégique des cibles.
Les résultats montrent que le chat libre de l'équipe augmente considérablement les taux de victoire : les équipes avec communication non restreinte ont gagné 64% des batailles contre un bot scripté de dommages maximum, contre seulement 42% lorsque la discussion n'était pas autorisée. Même un message par tour a amélioré les performances à 52%. Notamment, un seul modèle contrôlant les deux Pokémon n'a atteint que 54%, indiquant que l'échange conversationnel lui-même — plutôt que la planification centralisée — génère l'avantage. Cependant, le chat libre a consommé 978k tokens de prompt par bataille, presque quatre fois les 259k utilisés dans les matchs silencieux, soulignant le coût informatique du dialogue.
L'environnement prouve également sa discriminabilité : des équipes Qwen3.8-27B plus fortes ont battu des équipes Qwen3.5-2B plus faibles 96% du temps et 74% contre des modèles 9B, établissant un référentiel évolutif. Les travaux futurs comprennent l'isolation de l'impact de l'observation du mouvement choisi par le partenaire et le développement d'un tableau de classement public.
Source: Hacker News · Résumé par HeadlinesBriefing