
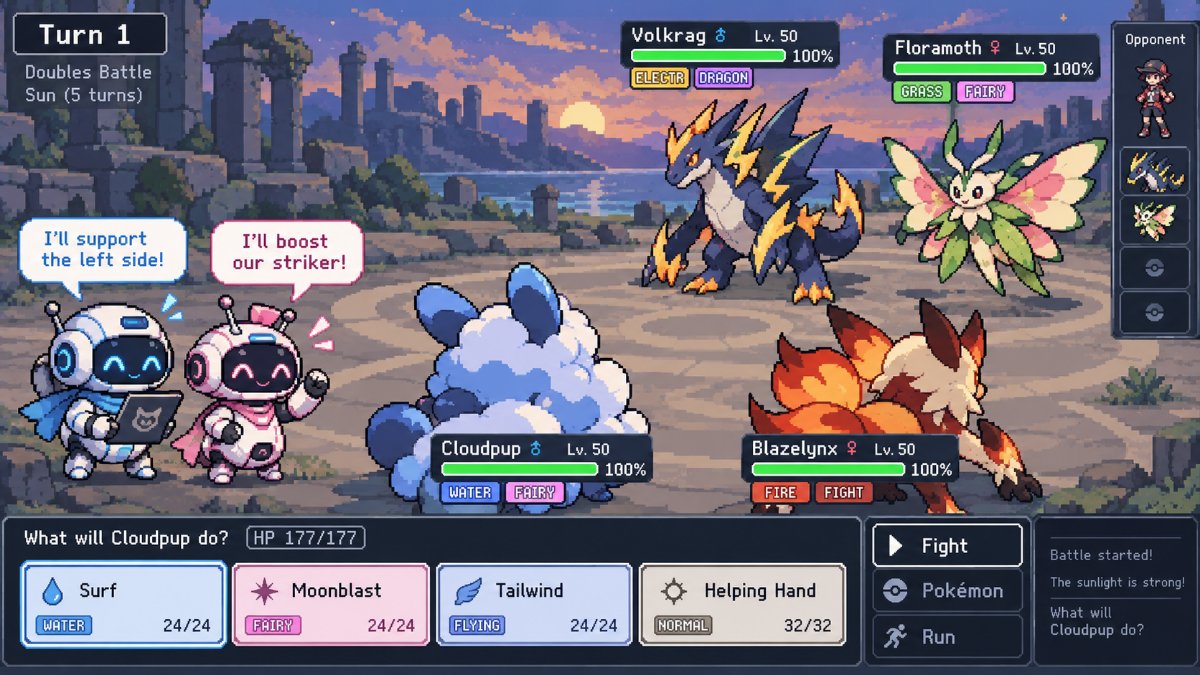
Um novo ambiente multi-agente construído sobre o formato 2v2 de Pokémon Showdown avalia como grandes modelos de linguagem coordenam, comunicam e negociam ações em tempo real. Usando modelos Qwen3.8-27B como companheiros de equipe, o setup testa colaboração sob incerteza com conjuntos de oponentes ocultos e danos aleatórios. Em uma batalha de amostra, um agente identifica corretamente um erro de correspondência de tipo feito por seu parceiro antes de se comprometer com uma jogada, demonstrando correção dinâmica e divisão estratégica de alvos.
Os resultados mostram que o chat livre do time aumenta significativamente as taxas de vitória: equipes com comunicação sem restrições ganharam 64% das batalhas contra um bot scripted de dano máximo, comparado a apenas 42% quando não era permitido falar. Mesmo uma mensagem por turno melhorou o desempenho para 52%. Notavelmente, um único modelo controlando ambos os Pokémon alcançou apenas 54%, indicando que o próprio intercambio conversacional — e não a planejamento centralizado — gera a vantagem. No entanto, o chat livre consumiu 978k tokens de prompt por batalha, quase quatro vezes os 259k usados em partidas silenciosas, destacando o custo computacional do diálogo.
O ambiente também prova discriminatório: times mais fortes de Qwen3.8-27B derrotaram times mais fracos de Qwen3.5-2B 96% do tempo e 74% contra modelos de 9B, estabelecendo um referência escalável. O trabalho futuro inclui isolar o impacto de observar a ação escolhida pelo parceiro e desenvolver uma leaderboard pública.
Fonte: Hacker News · Resumido por HeadlinesBriefing