
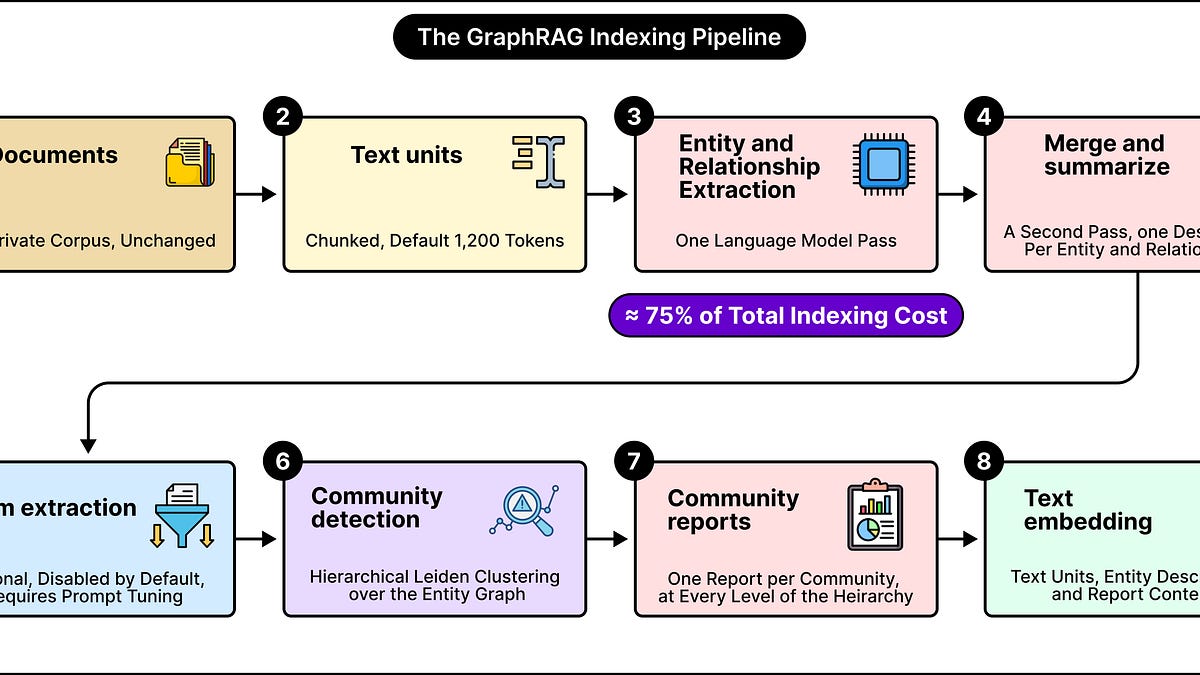
标准RAG通过匹配问题向量到块向量检索文档,适用于诸如"哪个服务拥有支付重试逻辑"这样的本地查询。然而,诸如"哪些失败原因在所有事后分析中最常出现"这样的全局查询需要跨整个数据集进行推理。
Graph RAG通过构建捕获实体(服务、团队、事件)及其之间关系的知识图谱来解决这一限制。这使得答案可以从整个语料库的模式中浮现出来,而不是来自单个文档。
微软测试了Graph RAG与标准向量检索,使用8,000和64,000个标记的上下文。在全局问题上,更大的窗口仍然无法匹配Graph RAG的全面性、多样性和来源质量。
LinkedIn的客户服务团队在实施基于知识图谱的检索后报告称,平均倒数排名提高了77.6%,中位解决时间减少了28.6%。Graph RAG维护两个图谱:一个将文档链接到块的词汇图,以及一个连接所描述概念的实体图。
关键实体:公司:微软、LinkedIn、Neo4j、ByteByteGo
来源: ByteByteGo · 由HeadlinesBriefing整理摘要