
O RAG padrão recupera documentos correspondendo vetores de perguntas a vetores de fragmentos, funcionando bem para consultas locais como "Qual serviço possui a lógica de retentativa de pagamentos?". No entanto, consultas globais como "Quais causas de falha ocorrem com mais frequência em todos os pós-mortems?" exigem raciocínio em todo o conjunto de dados.
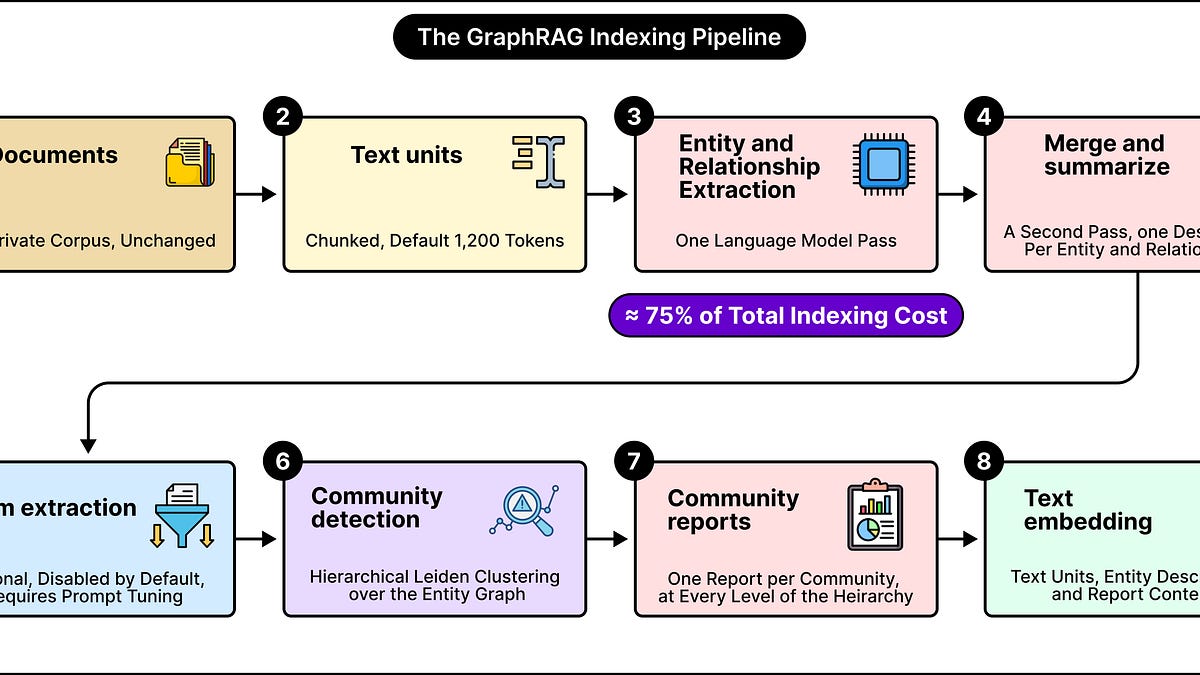
O Graph RAG aborda esta limitação construindo grafos de conhecimento que capturam entidades (serviços, equipes, incidentes) e as relações entre elas. Isso permite que as respostas emergam de padrões em todo o corpus em vez de documentos individuais.
A Microsoft testou o Graph RAG contra a recuperação vetorial padrão com contextos de 8.000 e 64.000 tokens. Nas perguntas globais, as janelas maiores ainda não conseguiram igualar a abrangência, diversidade e qualidade das fontes do Graph RAG.
A equipe de atendimento ao cliente da LinkedIn relatou uma melhoria de 77,6% no ranque inverso médio e uma redução de 28,6% no tempo mediano de resolução após implementar a recuperação baseada em grafos de conhecimento. Graph RAG mantém dois grafos: um grafo léxico vinculando documentos a fragmentos, e um grafo de entidades conectando conceitos descritos.
Entidades-chave: Empresas: Microsoft, LinkedIn, Neo4j, ByteByteGo
Fonte: ByteByteGo · Resumido por HeadlinesBriefing