
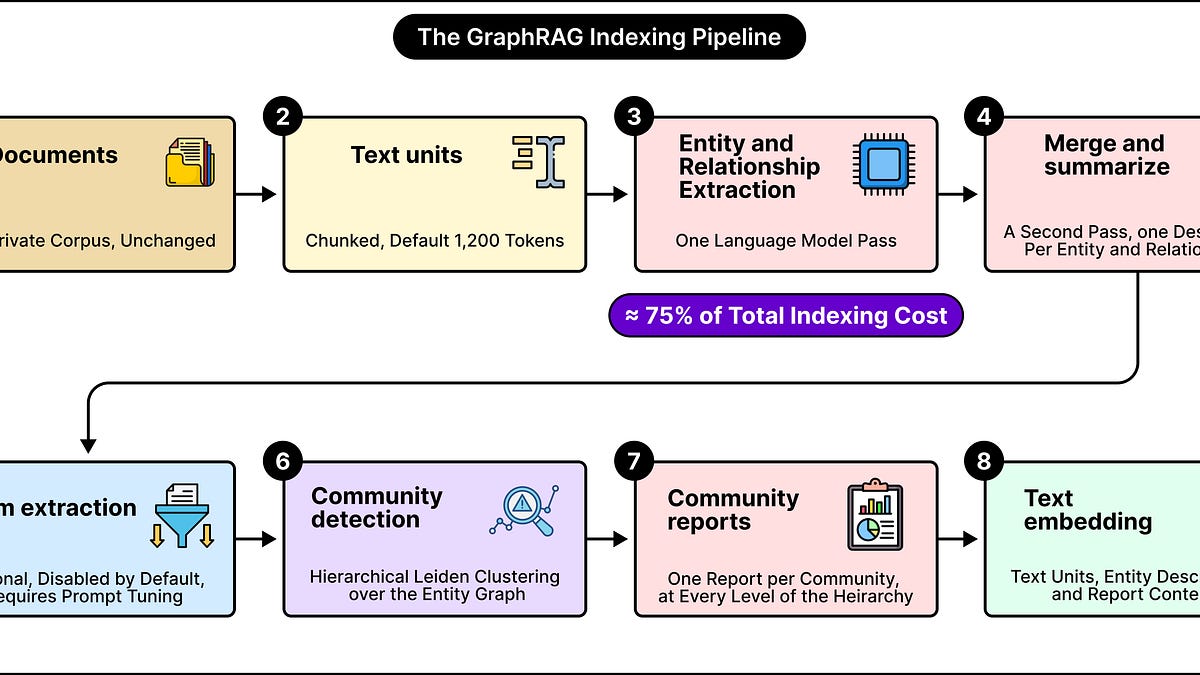
Le RAG standard récupère des documents en correspondant les vecteurs de questions aux vecteurs de segments, fonctionnant bien pour les requêtes locales comme "Quel service possède la logique de réessai des paiements ?". Cependant, les requêtes globales telles que "Quelles causes d'échec se reproduisent le plus souvent dans tous les rapports post-incident ?" nécessitent un raisonnement à travers l'ensemble des données.
Graph RAG résout cette limitation en construisant des graphes de connaissances qui capturent les entités (services, équipes, incidents) et les relations entre elles. Cela permet aux réponses de émerger à partir de modèles sur l'ensemble du corpus plutôt que de documents individuels.
Microsoft a testé Graph RAG contre la récupération vectorielle standard avec des contextes de 8 000 et 64 000 tokens. Pour les questions globales, les fenêtres plus grandes n'ont toujours pas pu égaler l'exhaustivité, la diversité et la qualité des sources de Graph RAG.
L'équipe service client de LinkedIn a signalé une amélioration de 77,6 % du rang inverse moyen et une réduction de 28,6 % du temps médian de résolution après la mise en œuvre de la récupération basée sur des graphes de connaissances. Graph RAG maintient deux graphes : un graphe lexical liant documents et segments, et un graphe d'entités reliant les concepts décrits.
Entités clés : Entreprises : Microsoft, LinkedIn, Neo4j, ByteByteGo
Source: ByteByteGo · Résumé par HeadlinesBriefing