
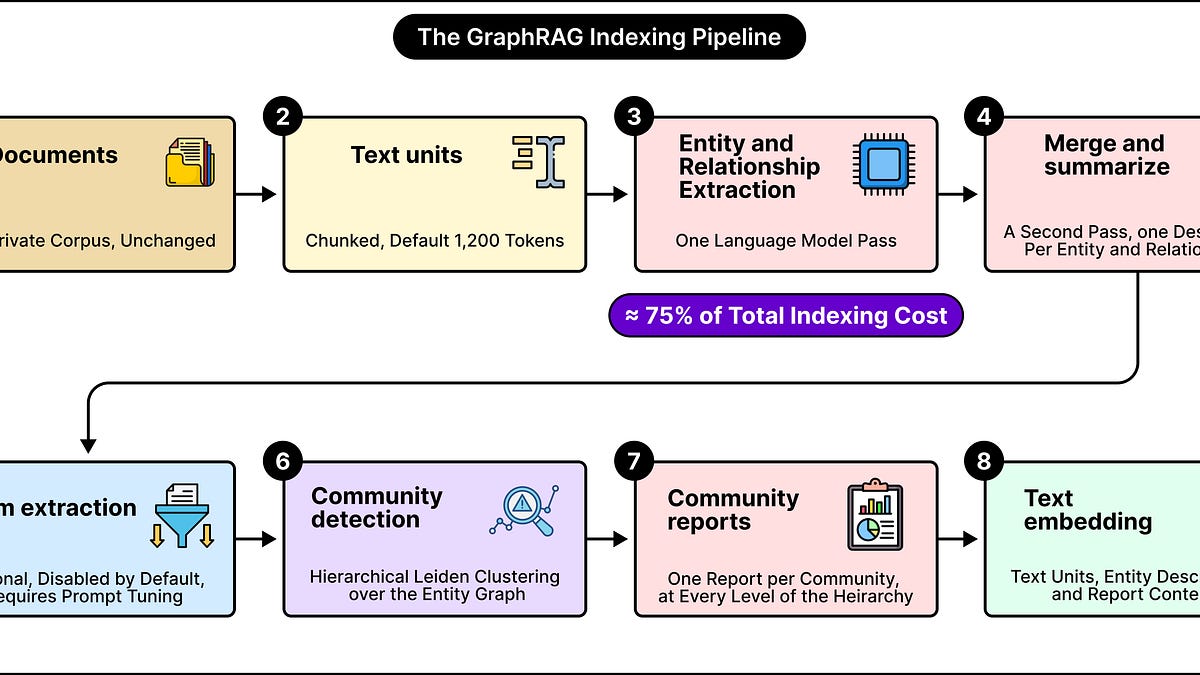
El RAG estándar recupera documentos comparando vectores de preguntas con vectores de fragmentos, funcionando bien para consultas locales como "¿Qué servicio posee la lógica de reintento de pagos?". Sin embargo, las consultas globales como "¿Qué causas de fallo ocurren con mayor frecuencia en todos los análisis posteriores?" requieren razonamiento a través de conjuntos de datos completos.
Graph RAG aborda esta limitación construyendo gráficos de conocimiento que capturan entidades (servicios, equipos, incidentes) y las relaciones entre ellas. Esto permite que las respuestas emergan de patrones en todo el corpus en lugar de documentos individuales.
Microsoft probó Graph RAG contra la recuperación vectorial estándar con contextos de 8,000 y 64,000 tokens. En preguntas globales, las ventanas más grandes aún no pudieron igualar la exhaustividad, diversidad y calidad de fuentes de Graph RAG.
El equipo de servicio al cliente de LinkedIn informó una mejora del 77.6% en el rango inverso medio y una reducción del 28.6% en el tiempo medio de resolución después de implementar la recuperación basada en gráficos de conocimiento. Graph RAG mantiene dos gráficos: un gráfico léxico que vincula documentos con fragmentos, y un gráfico de entidades que conecta conceptos descritos.
Entidades clave: Empresas: Microsoft, LinkedIn, Neo4j, ByteByteGo
Fuente: ByteByteGo · Resumido por HeadlinesBriefing