
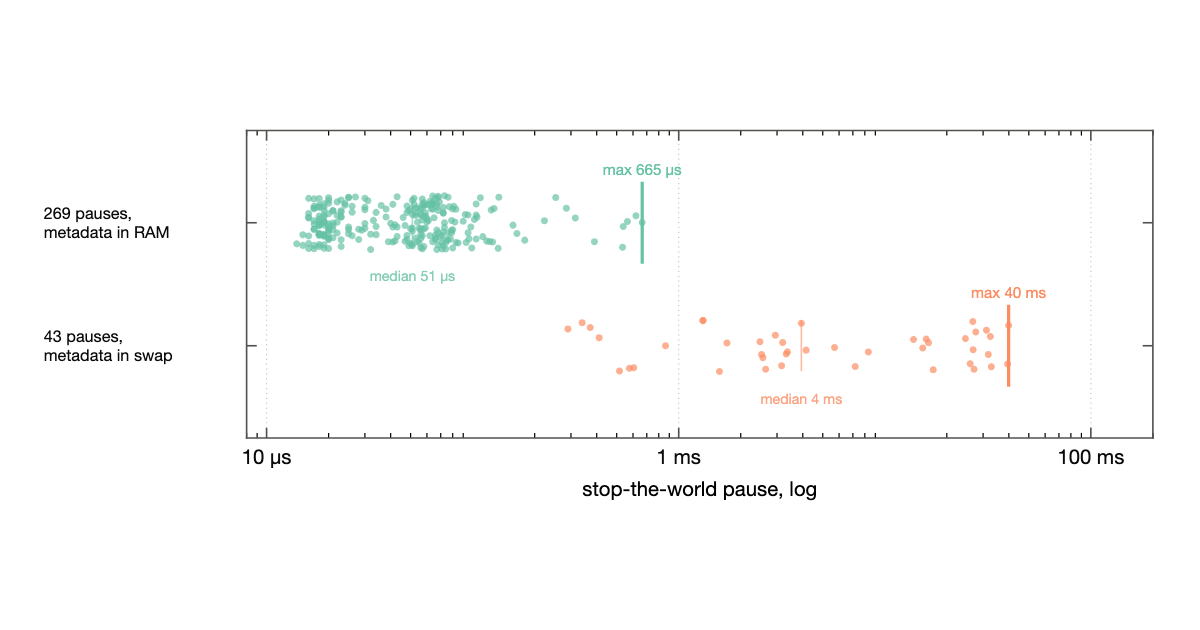
Я пишу это, чтобы вы не хлопали себя по лбу, как я почти сделал, когда решил запустить swap в производстве, чтобы поглощать скачки памяти. У меня был cgroup с двумя процессами: один — это процесс Go, который вызывает io. ReadAll, а затем proto. Unmarshal, создаёт blob, а затем структуру графа (которая помечена как сканируемая распределителем Go). Другой процесс — это HTTP-сервер, который обычно молчалив. Каждый раз, когда запускается сборщик, он читает эти сканируемые промежутки, указатель за указателем, и решает, что с ними делать. Поэтому я подумал: хорошо, при давлении памяти ядро будет выгружать страницы на устройство подкачки, но поскольку выгрузка происходит по cgroup, а не по процессу, страницы обоих процессов будут выгружены, так что шанс того, что это превратится в печальный танец swap-in и swap-out между ядром и сборщиком мусора, весьма мал. Я ошибался. Пока экспериментируя с этим, я нашёл проблему, которая могла бы меня ранить: сборщик мусора Go читает свои метаданные (вне кучи, в области, которая не освобождается) во время паузы stop-the-world, и эти метаданные могут быть в подкачке. Я провёл тест на сервере Hetzner с ядром 6.8 и включённым MGLRU. Медианная пауза составила около 51 мкс. С метаданными на NVMe, худшая пауза составила 40 мс. Чтобы проверить, куда ушли эти 40 мс, я написал небольшой скрипт bpf, который считает ошибки страниц, пока мир остановлен. Вот самая плохая: 39902 мкс, за это время 228 ошибок, 39013 мкс в ошибках. 39 из этих 40 мс были потрачены на 228 ошибок страниц. Эти ошибки произошли внутри учёта GC. Это потенциальный сценарий сбоя.
GC в Go должен останавливать мир в двух точках: когда он завершает очистку, и когда он завершает маркировку. У нас было 312 таких пауз за 30 минут. Вот почему это происходит: среда выполнения выделяет эти страницы. Они не освобождаются, а переиспользуются. Эти страницы читаются в циклах GC. Поскольку ядро выгружает страницы по возрасту, оно отправляет наименее недавно используемые страницы в подкачку. GC запускается, останавливает мир, пытается прочитать эти страницы, но теперь у нас есть серьёзный сбой страницы. Ядру нужно прочитать PTE, затем вызвать do_swap_page, найти новый кадр, начислить его на cgroup, прочитать страницы, отправить bio, подождать диск и вернуть их обратно в память — чтобы кратко сказать. Эти 40 мс кажутся безобидными на первый взгляд. Но мы говорим о паузе stop-the-world. Эти 40 мс означают, что всё остановилось — по терминологии Go, каждый P остановился, поэтому, например, если goroutine ждала ввода-вывода, во время этой паузы ввод-вывод мог вернуться, и никто не обрабатывал бы его. 40 мс — это в 800 раз больше медианной паузы. Он происходит два или три раза на каждый скачок памяти во время теста. Это много.
Источник: Hacker News · Сводку подготовил HeadlinesBriefing