
J’écris cela pour que vous ne vous gifliez pas le front comme moi, jusqu’à ce que je décide d’exécuter le swap en production pour absorber les pics de mémoire. J’avais un cgroup avec deux processus : un processus Go qui appelle io. ReadAll puis proto.
Unmarshal, créant un blob puis une structure de graphe (qui est marquée comme scan par l’allocateur de Go). L’autre processus est un serveur HTTP qui reste généralement silencieux. Chaque fois que le ramasse-miettes s’exécute, il lit ces spans de scan, pointeur par pointeur, et décide quoi en faire.
Alors j’ai pensé : ok, sous pression mémoire, le noyau va évaporer des pages vers le périphérique de swap, mais comme l’éviction est par cgroup et non par processus, les pages des deux processus vont être évaporées — il n’y a donc qu’une petite chance pour que cela devienne une triste danse de swap-in et swap-out entre le noyau et le ramasse-miettes. Je me suis trompé. En expérimentant cela, j’ai trouvé un problème qui aurait pu me blesser : le ramasse-miettes de Go lit ses métadonnées (en dehors du tas, dans une région non libérée) pendant une pause stop-the-world, et ces métadonnées peuvent être dans le swap.
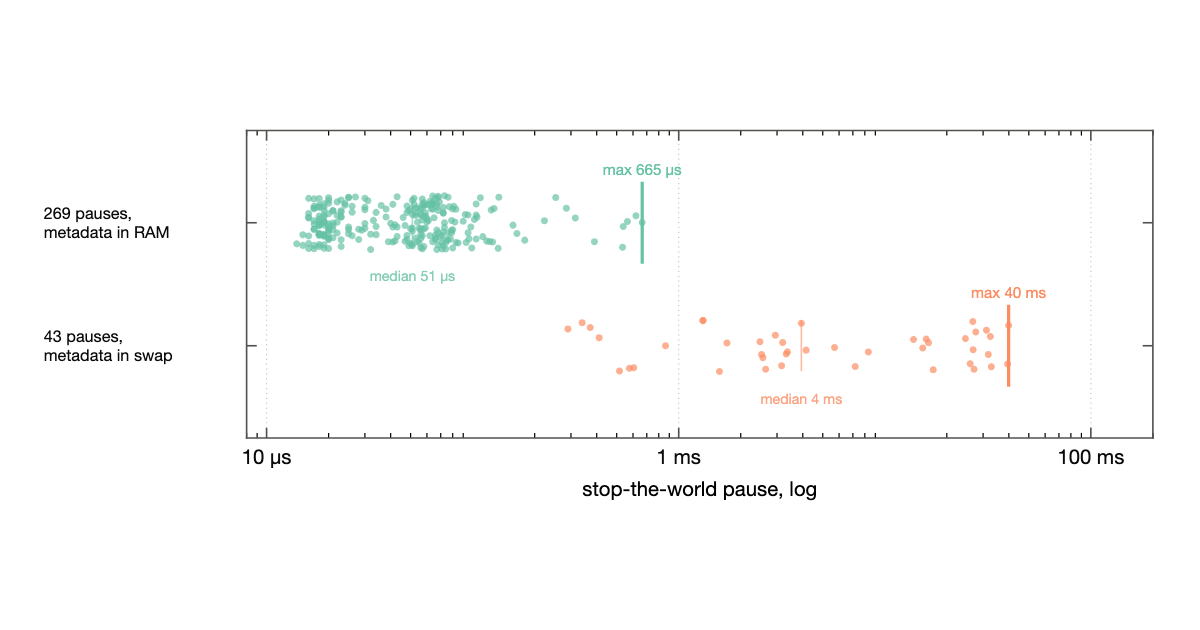
J’ai fait un test sur une machine Hetzner avec le noyau 6.8 et MGLRU activé. La pause médiane était d’environ 51 µs. Avec les métadonnées sur le NVMe, la pire pause était de 40 ms.
Pour vérifier où étaient passées ces 40 ms, j’ai écrit un petit script bpf qui compte les fautes de page pendant que le monde est arrêté. Voici la pire : 39902 µs, 228 fautes pendant cela, 39013 µs en fautes. 39 de ces 40 ms ont été passées dans 228 fautes de page. Ces fautes se sont produites à l’intérieur de la comptabilité du GC.
C’est un mode de défaillance potentiel. Le GC de Go doit arrêter le monde en deux points : lorsqu’il effectue une terminaison de balayage, et lorsqu’il effectue une terminaison de marquage. Nous avons eu 312 de ces pauses en 30 minutes.
Voici donc pourquoi cela arrive : le runtime alloue ces pages. Elles ne sont pas libérées, mais réutilisées. Ces pages sont lues lors des cycles GC.
Parce que le noyau évite les pages par âge, il envoie les pages les moins récemment accédées vers le swap. Le GC s’exécute, arrête le monde, tente de lire ces pages, mais maintenant nous avons une faute de page majeure. Le noyau doit lire les PTE, appeler do_swap_page, trouver un nouveau cadre, le charger sur le cgroup, lire les pages, soumettre un bio, attendre le disque, et les remettre en mémoire — pour résumer.
Ces 40 ms semblent inoffensives au début. Mais nous parlons d’une pause stop-the-world. Ces 40 ms signifient que tout s’est arrêté — en termes de Go, chaque P s’est arrêté, donc par exemple, si une goroutine attendait une entrée/sortie, pendant cette pause l’E/S pourrait retourner et il n’y aurait personne pour la gérer. 40 ms est 800 fois la pause médiane.
Cela se produit deux ou trois fois par pic de mémoire pendant le test. C’est beaucoup.
Source: Hacker News · Résumé par HeadlinesBriefing