
Estou escrevendo isso para que você não se dê um tapa na testa como eu quase fiz quando decidi executar swap em produção para absorver picos de memória. Eu tinha um cgroup com dois processos: um é um processo Go que chama io. ReadAll e depois proto.
Unmarshal, criando um blob e depois uma estrutura de gráfico (que é marcada como scan pelo alocador de Go). O outro processo é um servidor HTTP que normalmente fica em silêncio. Sempre que o coletor é executado, ele lê esses spans de scan, ponteiro por ponteiro, e decide o que fazer com eles.
Então eu pensei: ok, sob pressão de memória, o kernel vai expulsar páginas para o dispositivo de swap, mas como a expulsão é por cgroup e não por processo, as páginas de ambos os processos vão ser expulsas — então há apenas uma pequena chance de isso se tornar uma triste dança de swap-in e swap-out entre o kernel e o coletor de lixo. Eu estava errado. Enquanto experimentava isso, eu encontrei um problema que poderia ter me machucado: o coletor de lixo do Go lê seus metadados (fora do heap, em uma região que não é liberada) em uma pausa stop-the-world, e esses metadados podem estar no swap.
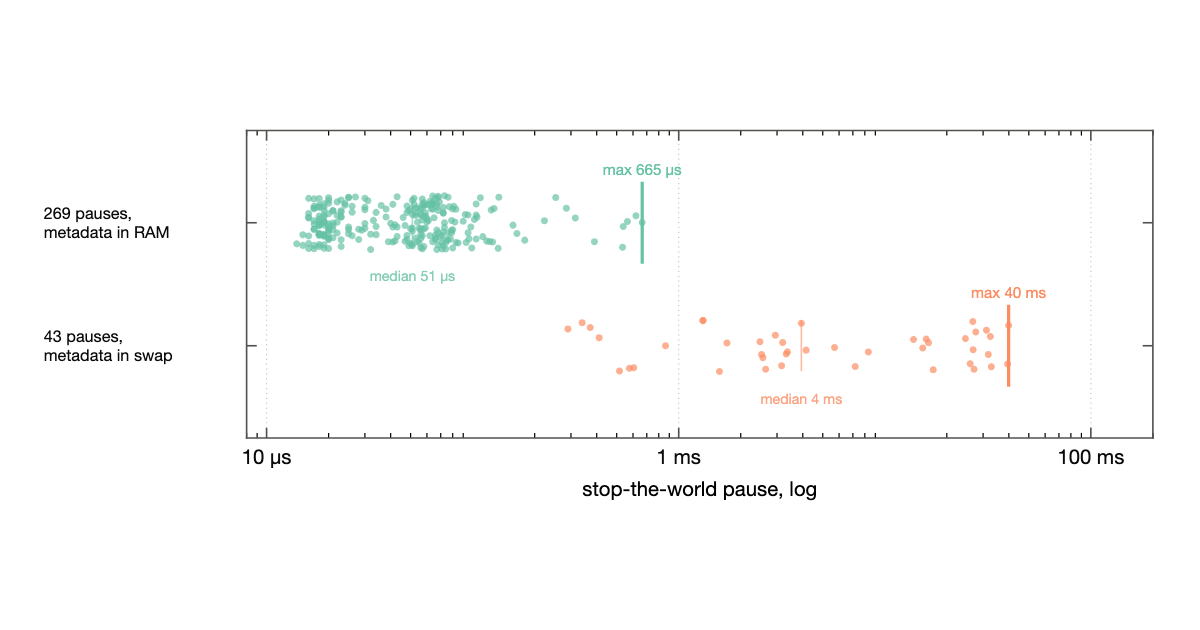
Eu fiz uma simulação em uma máquina Hetzner usando o kernel 6.8 com MGLRU ativado. A pausa mediana foi de cerca de 51 us. Com os metadados no NVMe, a pior pausa foi de 40 ms.
Para verificar onde esses 40 ms foram, eu escrevi um pequeno script bpf que conta falhas de página enquanto o mundo está parado. Esta foi a pior: 39902 us, falhas durante isso 228, 39013 us em falhas. 39 desses 40 ms foram gastos em 228 falhas de página. Essas falhas ocorreram dentro da contabilidade do GC.
Isso é um modo de falha potencial. O GC do Go precisa parar o mundo em dois pontos: quando ele realiza uma terminação de varredura, e quando ele realiza uma terminação de marcação. Tivemos 312 dessas pausas em 30 minutos.
Então aqui está por que isso acontece: o runtime aloca essas páginas. Elas não são liberadas, mas reutilizadas. Essas páginas são lidas em ciclos de GC.
Porque o kernel expulsa páginas por idade, ele envia as páginas menos recentemente acessadas para o swap. O GC roda, para o mundo, tenta ler essas páginas, mas agora temos uma falha de página maior. O kernel precisa ler as PTE, depois chamar do_swap_page, encontrar um novo quadro, carregá-lo no cgroup, ler as páginas, enviar um bio, esperar pelo disco e colocá-las de volta na memória — apenas para resumir.
Esses 40 ms parecem inofensivos no início. Mas estamos falando de uma pausa stop-the-world. Esses 40 ms significam que tudo parou — em termos de Go, cada P parou, então, por exemplo, se uma goroutine estivesse esperando por E/S, durante essa pausa a E/S poderia retornar e não haveria ninguém para tratá-la. 40 ms é 800 vezes a pausa mediana.
Ele acontece duas ou três vezes por pico de memória durante o teste. É muito.
Fonte: Hacker News · Resumido por HeadlinesBriefing