
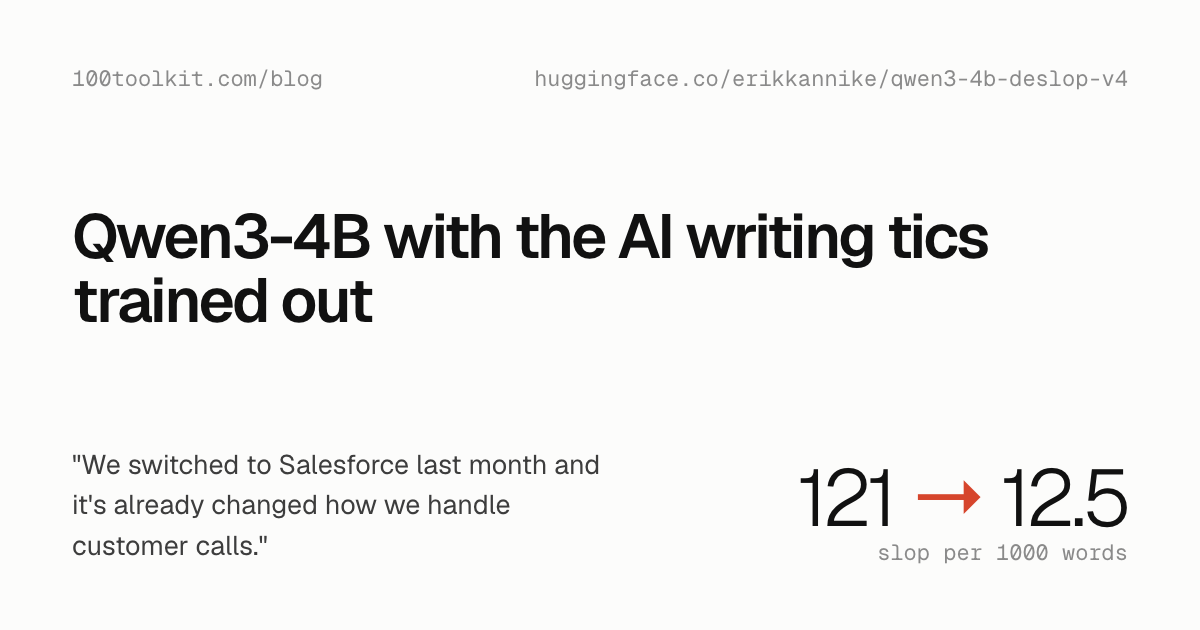
小型のオープンモデル、Qwen3-4B-Instructが、AI生成文の特徴となる癖を出さずに書けるようファインチューニングされました。qwen3-4b-deslopとして公開されたこのモデルは、エム・ダッシュ、「Xではなく Y」という構文、三つ組の列挙を避けており、システムプロンプトも不要です。Ollamaを使ってローカルで実行でき、コマンドは ollama run hf.co/erikkannike/qwen3-4b-deslop-v4-GGUF です。Q4_K_M形式で2.5 GBのダウンロードになります。
学習で一度も見ていない40個のプロンプトでは、1000語あたりのスロップ・スコアが121から12.5に下がり、回答の68%が人間の文章の範囲に収まりました。エム・ダッシュは1000語あたり20.5個からゼロになりました。このモデルは事実に関する質問30問中30問に正しく答え、求められたジャンルや長さに合わせる精度も元のモデルと同程度でした。
中間バージョンのスコアは9.9でしたが、文章の質は低いものでした。意見のないオピニオン記事を書き、架空の研究を作り出し、文を「, which」でつなぐ癖がありました。これを直すため、回答がプロンプトの要求に合っているかを確かめる第二のフィルターが加えられました。その結果生まれた文体は平板で、ほとんど味気ないほどです。また、このモデルは今も人名や地名を作り出してしまいます。
この作業はMac Book Airで、161個の学習用回答を使って行われました。著者は、この手法がモデルの規模に依存しないと述べており、次のステップとしてより大きなモデルへの適用を挙げています。
出典: Hacker News · 要約:HeadlinesBriefing