
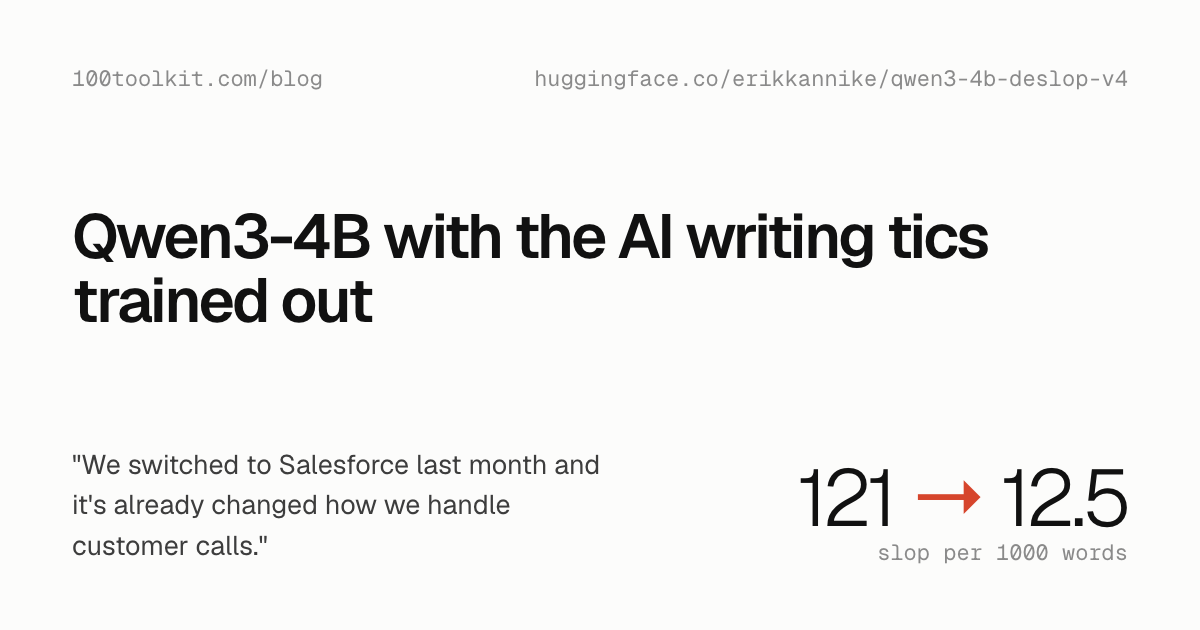
एक छोटा ओपन मॉडल, Qwen3-4B-Instruct, को इस तरह फाइन-ट्यून किया गया है कि वह उन आदतों के बिना लिखे जो AI-जनित पाठ की पहचान बनती हैं। इसे qwen3-4b-deslop नाम से जारी किया गया है, और यह एम डैश, "X नहीं, बल्कि Y" वाली संरचनाओं और तीन-तीन की सूचियों से बचता है, तथा इसे सिस्टम प्रॉम्प्ट की ज़रूरत नहीं होती। इसे Ollama के साथ स्थानीय रूप से चलाया जा सकता है, इसके लिए कमांड है ollama run hf.co/erikkannike/qwen3-4b-deslop-v4-GGUF, और यह Q4_K_M फॉर्मेट में 2.5 GB का डाउनलोड है।
प्रशिक्षण में कभी न देखे गए 40 प्रॉम्प्ट्स पर, प्रति 1000 शब्दों पर स्लॉप स्कोर 121 से घटकर 12.5 रह गया, और 68% उत्तर मानव लेखन की सीमा में आते हैं। एम डैश प्रति 1000 शब्दों पर 20.5 से घटकर शून्य हो गए। मॉडल ने 30 में से 30 तथ्यात्मक प्रश्नों के सही उत्तर दिए और माँगी गई शैली और लंबाई का पालन मूल मॉडल जितनी ही बार किया।
एक मध्यवर्ती संस्करण का स्कोर 9.9 था, लेकिन उसका लेखन कमज़ोर था: वह बिना राय वाले ओपिनियन लेख लिखता था, काल्पनिक अध्ययन गढ़ता था, और वाक्यों को ", which" से जोड़ने की आदत थी। इसे सुधारने के लिए एक दूसरा फ़िल्टर जोड़ा गया जो जाँचता है कि उत्तर प्रॉम्प्ट के अनुरोध से मेल खाते हैं या नहीं। नतीजतन लहजा इतना सादा है कि लगभग फीका लगता है, और मॉडल अब भी नाम और स्थान गढ़ देता है।
यह काम 161 प्रशिक्षण उत्तरों का उपयोग करके एक Mac Book Air पर किया गया। लेखक का कहना है कि यह तरीका मॉडल के आकार पर निर्भर नहीं है, और अगला कदम इसे बड़े मॉडलों पर लागू करना है।
स्रोत: Hacker News · HeadlinesBriefing द्वारा सारांशित