
আমি বাস্তব গবেষণায় তিনটি sampler-ই ব্যবহার করেছি, প্রায়ই একটিকে অন্যটির চেয়ে কেন বেছেছি তা ভালোভাবে না ভেবেই। emcee ছিল আমার প্রথম sampler, যখন আমি আমার likelihood গুলো JAX-এ নিয়ে গেলাম তখন NUTS এলো, আর কেউ Bayes factor চাইলেই dynesty ব্যবহার করতাম। শেষ পর্যন্ত বুঝলাম, যে সমস্যা আমি আগে থেকে ভালোভাবে বুঝি না, তাতে কোনটিকে বিশ্বাস করব তা আমি বলতে পারি না।
বেশিরভাগ sampler তুলনায় গতি মাপা হয়, কিন্তু নমুনা ভুল হলে গতির তেমন মূল্য নেই, আর সঠিক উত্তর জানা থাকলেই ভুল যাচাই করা যায়। তাই আমি তিনটি সমস্যা বেছে নিয়েছি যেগুলো যথেষ্ট ছোট, যাতে ঘন গ্রিডে বা বিশ্লেষণাত্মকভাবে সঠিকভাবে সমাধান করা যায়, এবং প্রতিটি sampler-কে অন্যদের সাথে নয় বরং সত্যের সাথে তুলনা করে মূল্যায়ন করেছি।
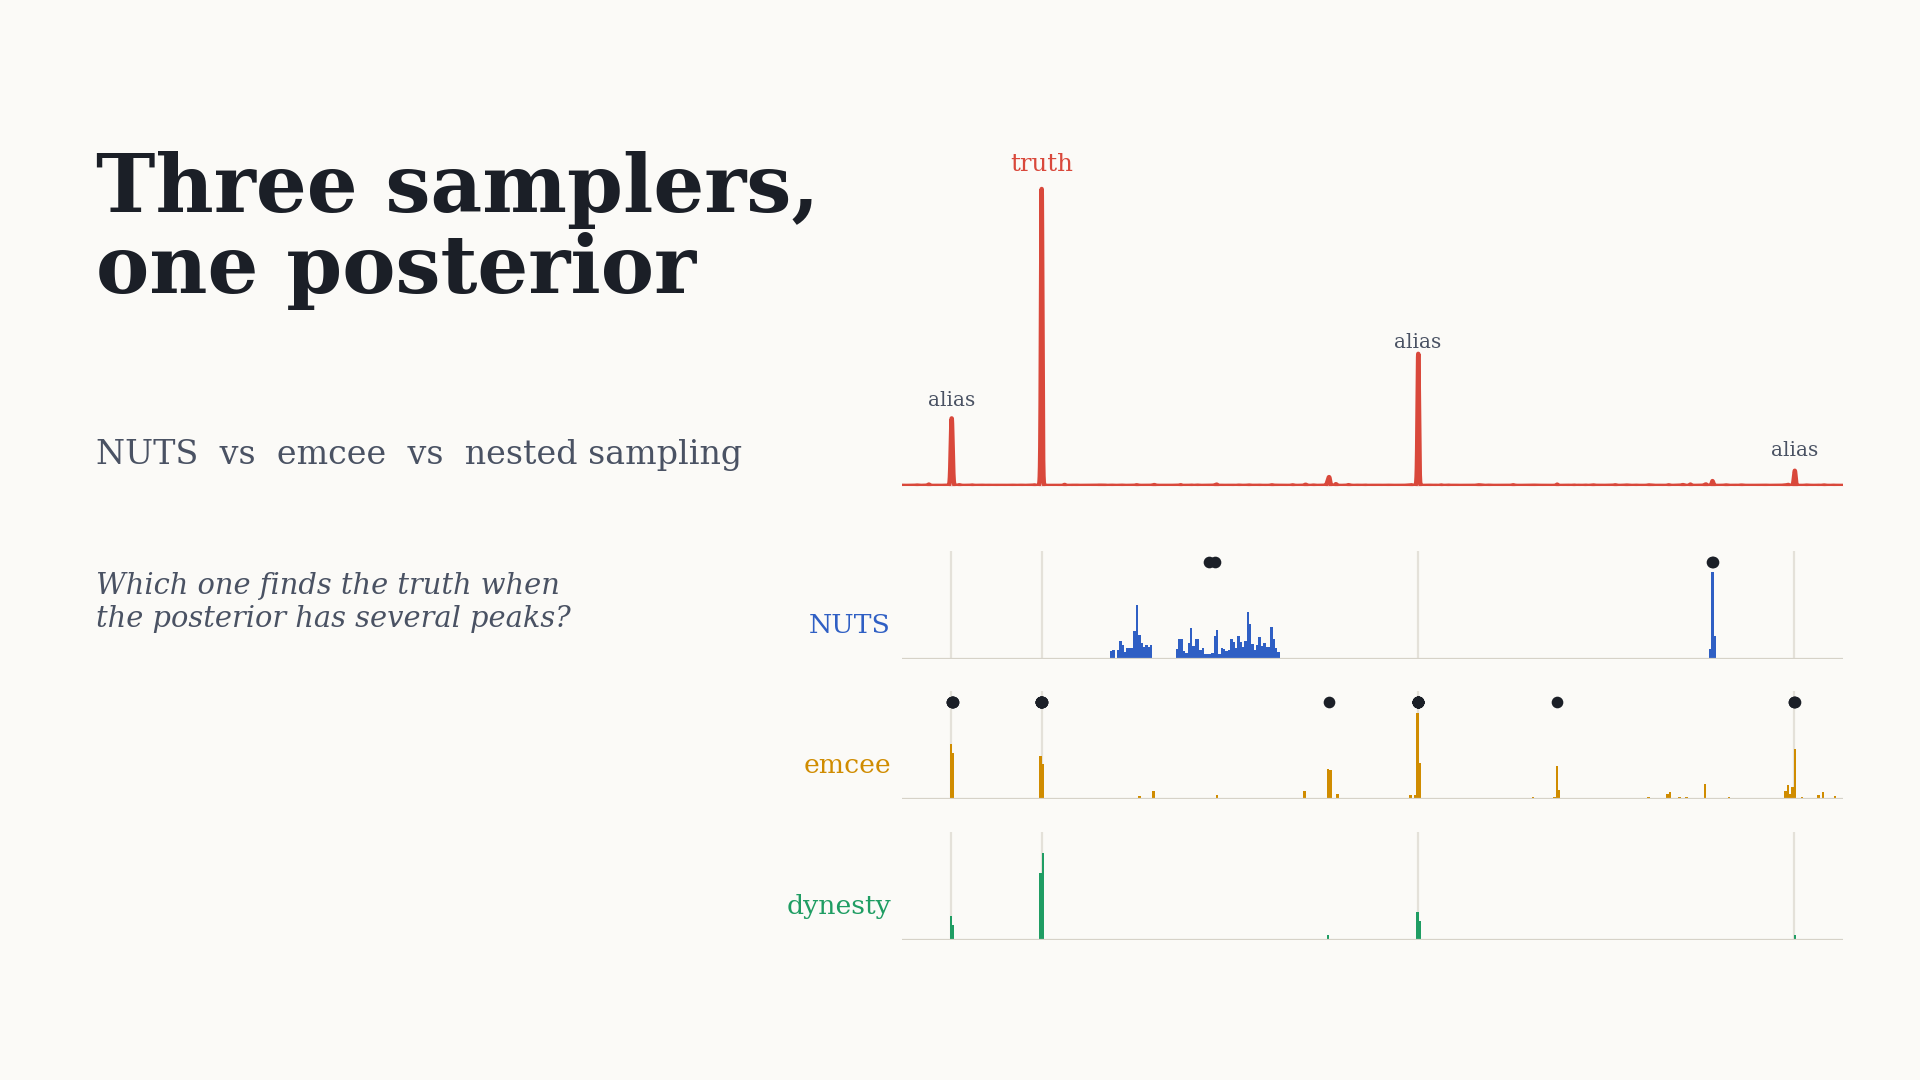
NUTS সবচেয়ে দ্রুত ছিল, মসৃণ সমস্যায় দুই থেকে চার গুণ দ্রুত, কিন্তু বহু-শিখর সমস্যায় সে সম্পূর্ণ ব্যর্থ হয়েছে, এবং এর diagnostics তা স্পষ্টভাবে জানিয়েছে। emcee সহজ সমস্যায় ভালো ছিল, কিন্তু বহু-শিখর সমস্যায় আত্মবিশ্বাসের সাথে ভুল উত্তর দিয়েছে, এবং এর ডিফল্ট আউটপুটে কোনো সতর্কতা ছিল না। dynesty ছিল একমাত্র sampler যে প্রতিটি শিখর খুঁজে পেয়েছে এবং সঠিক evidence দিয়েছে, যদিও এর evidence error bar গুলো আশাবাদী ছিল।
তিনটি পরীক্ষার সমস্যা ধাপে ধাপে কঠিন হয়েছে। প্রথমটি ছিল একটি নিয়ন্ত্রণ: ৪০টি সিমুলেটেড Type Ia supernova ব্যবহার করে flat ΛCDM-এ Ωm ও H0 ফিট করা, যা প্রায় উপবৃত্তাকার posterior দেয়। দ্বিতীয়টি ছিল একটি বাঁকা, সরু রিজ, যেখানে H0 স্থির রেখে Ωm ও dark energy equation of state ফিট করা হয়েছে। তৃতীয়টি ছিল বহু-শিখর সমস্যা: ৮০ দিনে ৪০ রাতে পর্যবেক্ষিত একটি sinusoid-এর কম্পাঙ্ক খুঁজে বের করা, যা একাধিক আলাদা শিখর তৈরি করে।
মূল সত্তা: কোম্পানি: Towards Data Science | ব্যক্তি: Arvi Z.
উৎস: Towards Data Science · সারাংশ: HeadlinesBriefing