
10月9日、Vals AIはコーディングエージェントのチームが費用に見合うかを検証しました。GPT 6 SolとClaude Opus 5.5が、それぞれ単独で、またサブエージェントを伴うチームとして、中程度と最大の推論努力レベルで50のWebアプリを構築しました。チームのコストは1.8~5.1倍でした。チームと単独の比較4件のうち、統計的に有意だったのは1件のみで、中程度の努力レベルのSolが7.3ポイント向上させたものです。Solについては、単独エージェントの推論努力を中程度から最大に上げると11.4ポイント向上し、中程度の努力レベルでチームが加えた効果を上回りました。
この研究は作業の分担に関するもので、エージェントが同じ誤りをするかどうかを扱ったものではありません。それでも、一つの疑問が浮かびます。投票にもう1つのモデルを加えたとき、実際にはいくつの独立した意見が加わるのでしょうか。1785年のコンドルセの陪審定理は、投票者を加えるほど多数決の正答率は1に近づくと示唆しますが、それは各投票者が半数以上正しく、判断が独立している場合に限られます。p = 0.7の場合、3人では78.4%、5人では83.7%、9人では90.1%、25人では98.3%の確率で正答します。
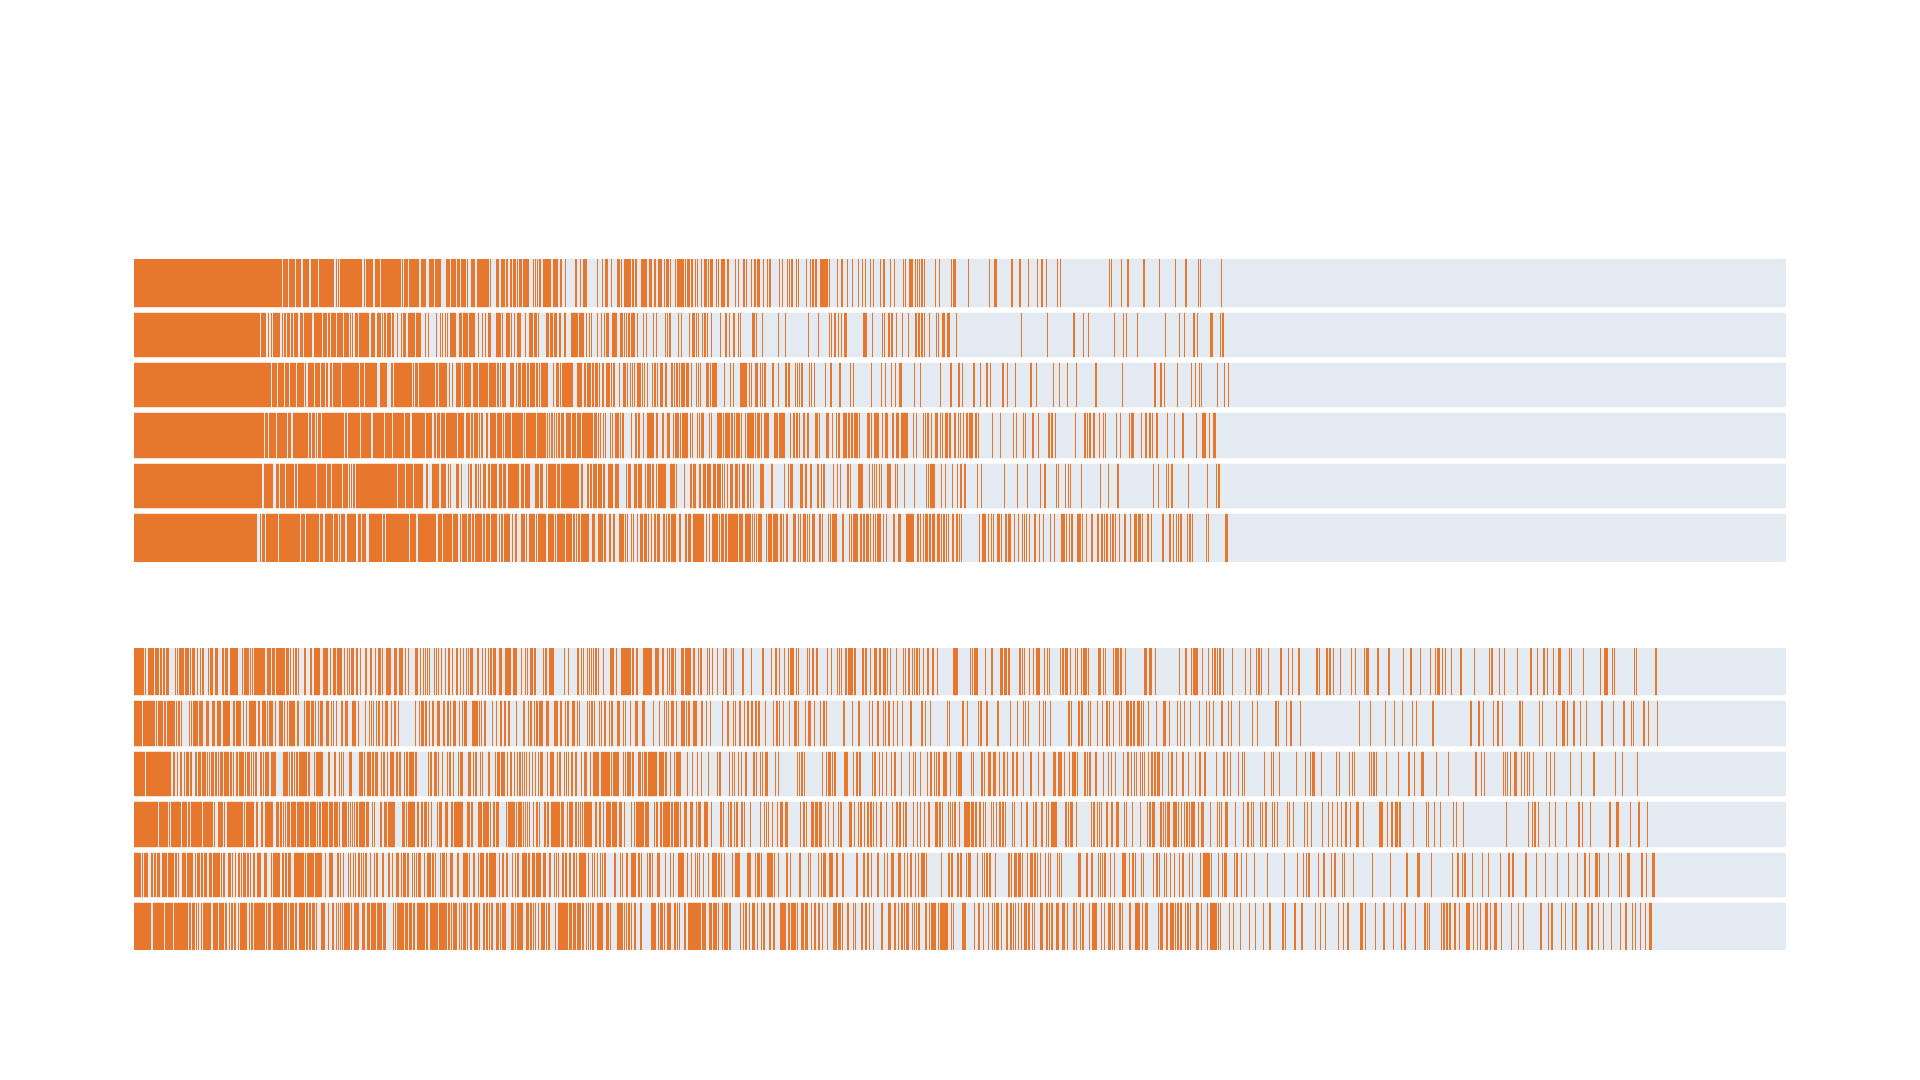
独立性こそが脆弱な前提です。同じ誤ったノートで勉強した5人の友人は同じ間違いを繰り返すため、多数決は自信を持って誤ることになります。重なり合うテキストで訓練され、似た設計をもつ言語モデルも、同じ死角を共有しているかもしれません。シミュレーションがその差を示しています。誤りが独立している場合、5モデルの多数決は83.8%の確率で正しい一方、誤りが重なっている場合は74.4%にとどまります。個々のモデルの正答率は変わらないにもかかわらずです。
この記事は、6つの実在するオープンモデルを1,500の試験問題で検証し、パネルが実際にどれだけの独立した意見を提供するかを推定する式を用いて、この効果を直接測定することを目指しています。
出典: Towards Data Science · 要約:HeadlinesBriefing