
৯ অক্টোবর, Vals AI পরীক্ষা করেছে কোডিং এজেন্টের দলগুলো তাদের দামের যোগ্য কি না। GPT 6 Sol এবং Claude Opus 5.5 প্রতিটি ৫০টি ওয়েব অ্যাপ তৈরি করেছে, একা একা এবং সাব-এজেন্টসহ দল হিসেবে, মাঝারি ও সর্বোচ্চ যুক্তি-প্রয়াসে। দলগুলোর খরচ ছিল একক এজেন্টের চেয়ে 1.8 থেকে 5.1 গুণ বেশি। দল বনাম একক এজেন্টের চারটি তুলনার মধ্যে কেবল একটি পরিসংখ্যানগতভাবে তাৎপর্যপূর্ণ ছিল: মাঝারি প্রয়াসে Sol, যা 7.3 পয়েন্ট বাড়িয়েছে। Sol-এর ক্ষেত্রে, একক এজেন্টের যুক্তি-প্রয়াস মাঝারি থেকে সর্বোচ্চে তুললে 11.4 পয়েন্ট যোগ হয়েছে, যা মাঝারি প্রয়াসে একটি দল যা যোগ করেছে তার চেয়ে বেশি।
ঐ গবেষণা কাজ ভাগ করে নেওয়া নিয়ে, এজেন্টরা একই ভুল করে কি না সে নিয়ে নয়। তবুও এটি একটি প্রশ্ন তোলে: ভোটে আরেকটি মডেল যোগ করলে আসলে কতগুলো স্বাধীন মতামত যুক্ত হয়? ১৭৮৫ সালের কন্দরসে জুরি উপপাদ্য বলে, ভোটদাতা যোগ করলে সংখ্যাগরিষ্ঠের নির্ভুলতা ১-এর দিকে যায়, তবে শুধু তখনই যখন প্রতিটি ভোটদাতা অর্ধেকের বেশি সময় সঠিক হয় এবং তাদের বিচার স্বাধীন হয়। p = 0.7 হলে তিনজন ভোটদাতা ৭৮.৪% সময় সঠিক, পাঁচজন ৮৩.৭%, নয়জন ৯০.১% এবং পঁচিশজন ৯৮.৩%।
স্বাধীনতাই সেই ভঙ্গুর অনুমান। একই ত্রুটিপূর্ণ নোট থেকে পড়াশোনা করা পাঁচ বন্ধু একই ভুল পুনরাবৃত্তি করবে, ফলে সংখ্যাগরিষ্ঠ আত্মবিশ্বাসের সঙ্গে ভুল হবে। একই রকম নকশার, ওভারল্যাপিং লেখায় প্রশিক্ষিত ভাষা মডেলগুলোও একই অন্ধ বিন্দু ভাগ করে নিতে পারে। একটি সিমুলেশন ব্যবধানটি দেখায়: স্বাধীন ভুলে পাঁচ-মডেলের সংখ্যাগরিষ্ঠ ৮৩.৮% সময় সঠিক, কিন্তু ওভারল্যাপিং ভুলে মাত্র ৭৪.৪% সময়, যদিও প্রতিটি মডেলের ব্যক্তিগত নির্ভুলতা অপরিবর্তিত থাকে।
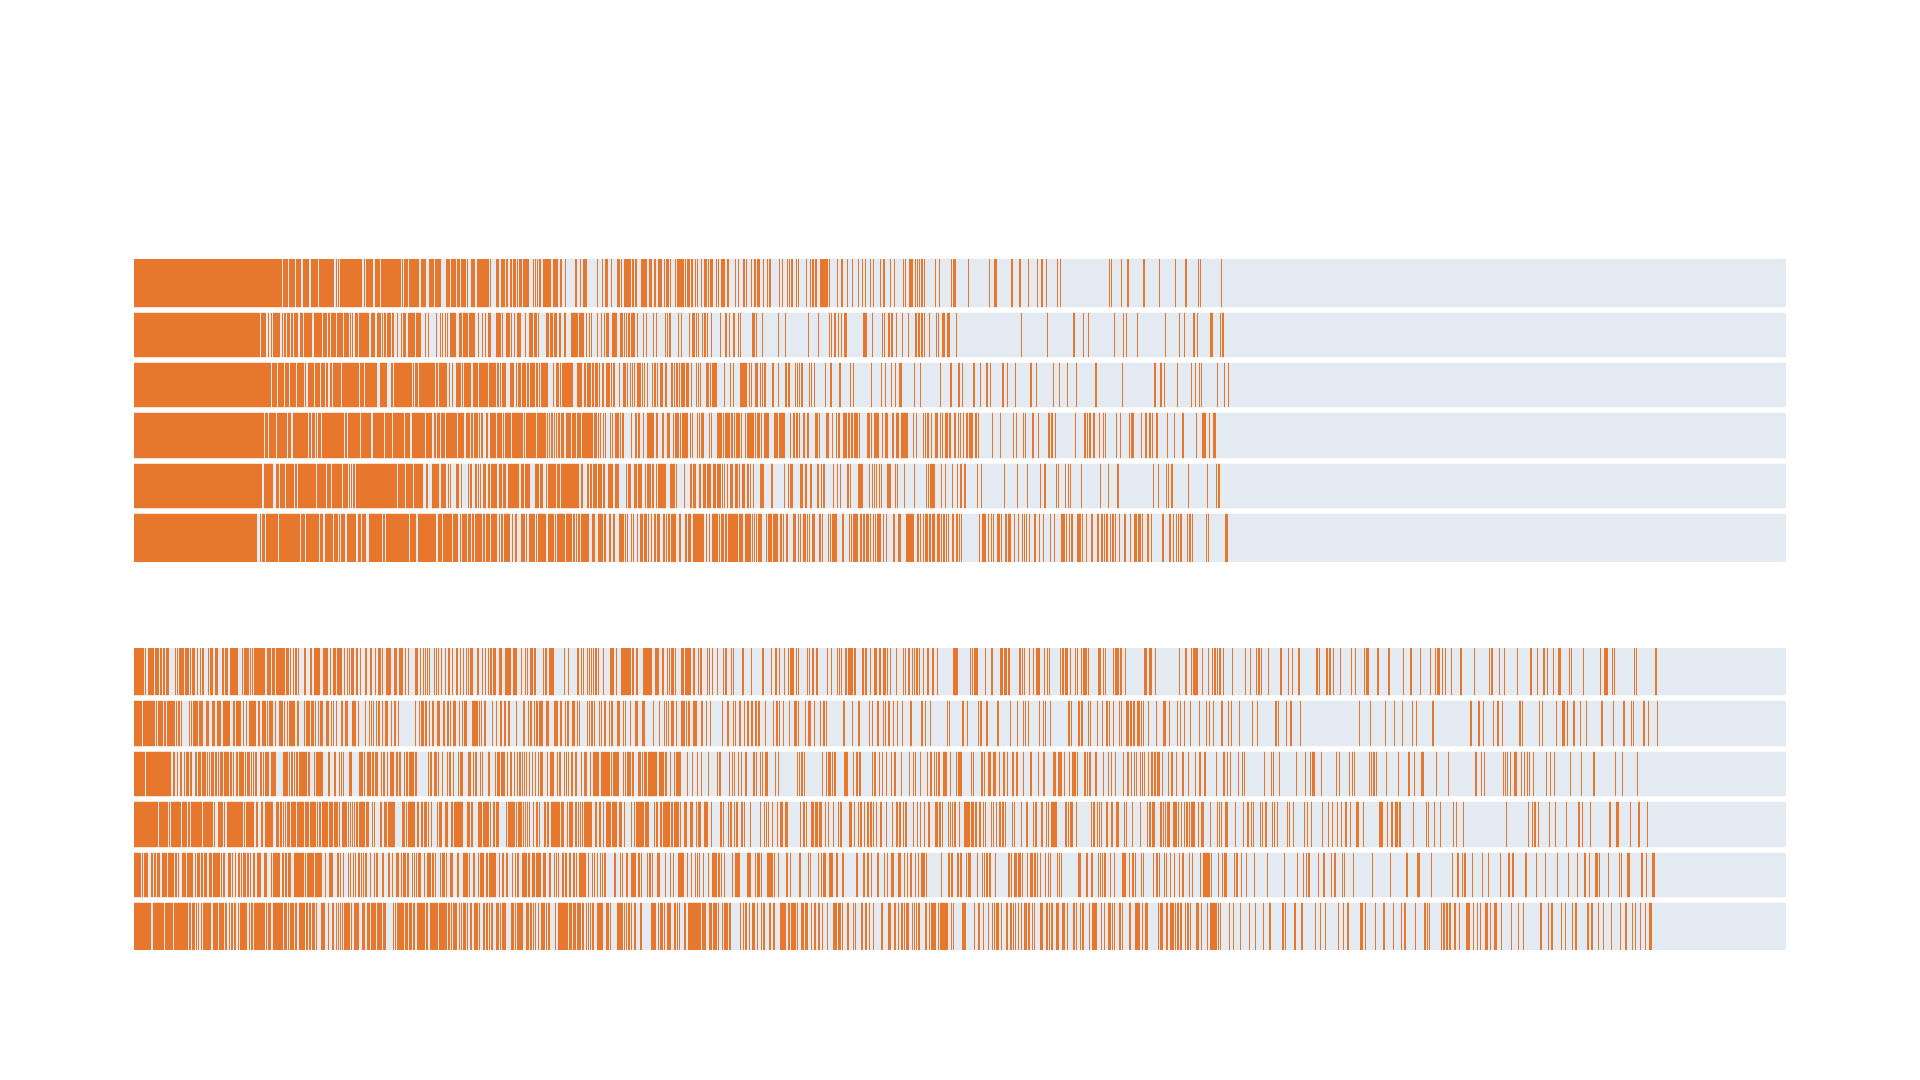
এই নিবন্ধটি ছয়টি প্রকৃত ওপেন মডেলের ওপর ১,৫০০ পরীক্ষার প্রশ্নে এই প্রভাবটি সরাসরি পরিমাপ করতে চায়, এবং একটি সূত্র প্রয়োগ করে অনুমান করে একটি প্যানেল আসলে কতগুলো স্বাধীন মতামত দেয়।
উৎস: Towards Data Science · সারাংশ: HeadlinesBriefing