
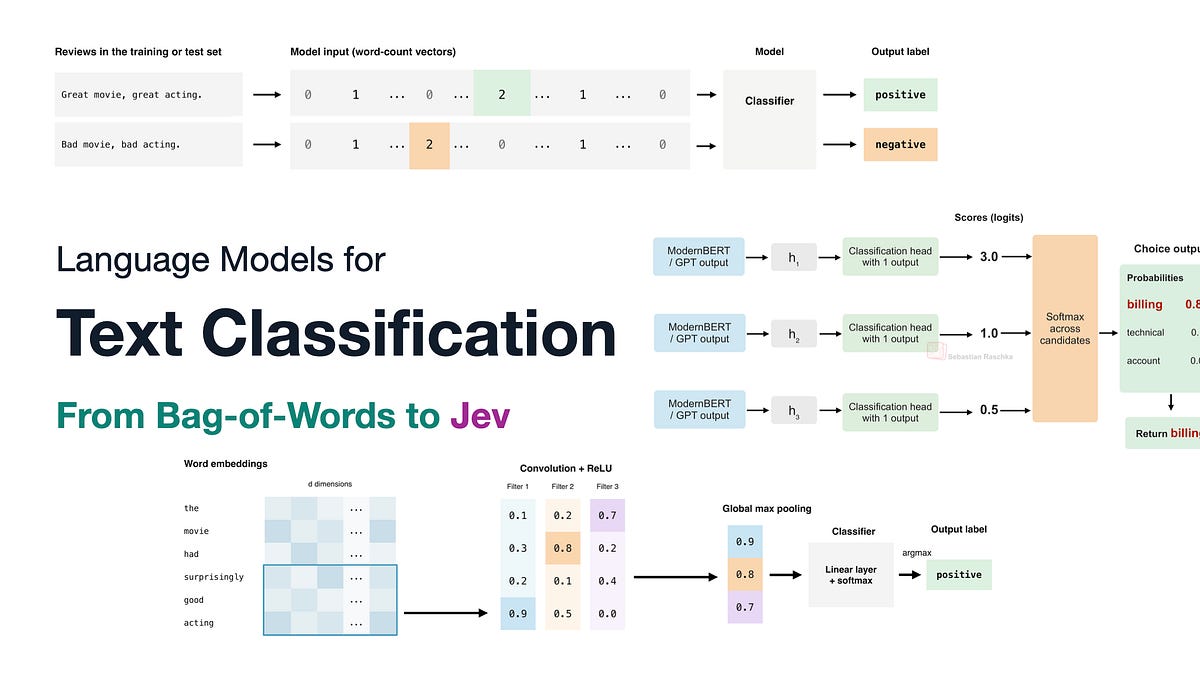
Недавно выпущенная модель Jev AI стала культурным феноменом в технических сообществах. Хотя Jev нацелен на классификацию текста, его часто отвергают как 'просто классификатор', хотя точка зрения автора эволюционировала к признанию его превосходной производительности. Jev обеспечивает более быстрое и дешевое классифицирование по сравнению с универсальными LLM вроде GPT, но остается более универсальным, чем узкие, специализированные модели. Его методология и популярность рассматриваются вместе с историческим контекстом классификации текста.
Статья прослеживает эволюцию классификации текста от представлений мешка слов, используемых с наивным Байесом и логистической регрессией, до современного глубокого обучения. Пятнадцать лет назад мешок слов был стандартом для преобразования переменной длины текста в фиксированные векторы для классификаторов вроде SVM и XGBoost. Применения включали фильтрацию спама и категоризацию новостей, причем allegedly Gmail использовал наивный Байес. Автор отмечает свою раннюю работу по этому подходу, опубликованную на arXiv двенадцать лет назад.
Метод мешка слов преобразует свободный текст в числовые признаки, как показано на примерах рецензий на фильмы. Этот исторический фундамент создает основу для понимания позиции Jev в ландшафте языковых моделей для принятия решений.
Ключевые сущности: Компании: Jev AI, Gmail, arXiv | Люди: Tim Cook, Elon Musk | Местоположения: 123 Main St
Часто задаваемые вопросы: Что такое Jev AI и как он сравнивается с другими моделями?
Jev AI — это специализированная модель классификации текста, которая работает быстрее и более экономически эффективно, чем универсальные LLM вроде GPT, оставаясь при этом более универсальной, чем специализированные классификаторы.