
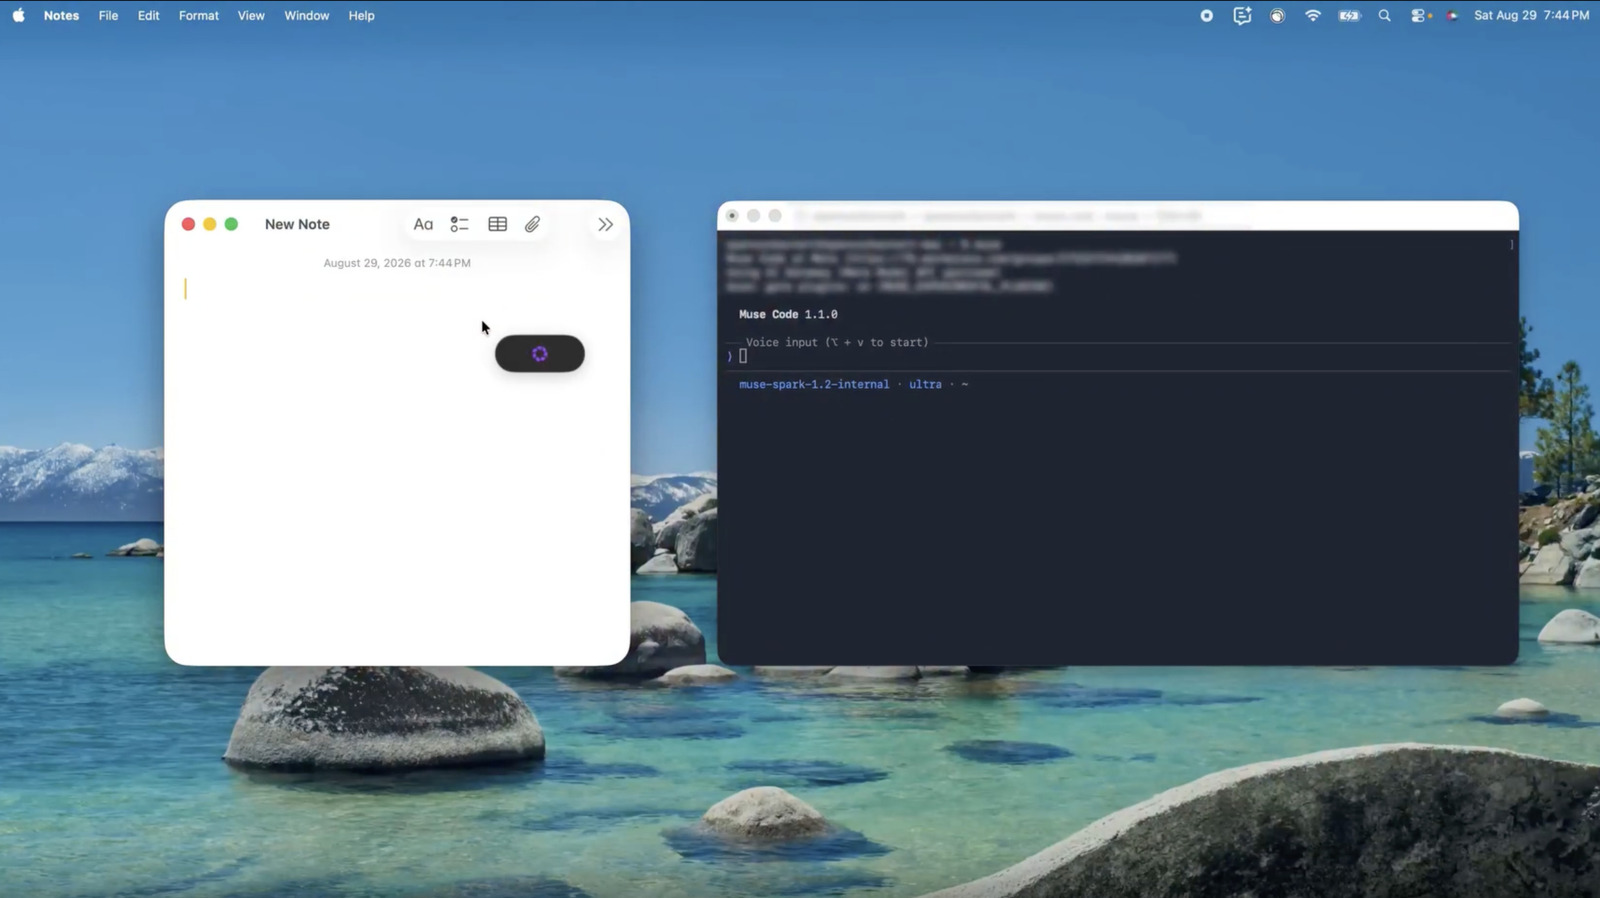
Meta представила свою первую модель аудио в реальном времени, Muse Voice Transcribe, из лаборатории Meta Superintelligence Lab (MSI). Модель может обрабатывать диктовку и транскрипцию для более чем 20 говорящих и одновременно без проблем обрабатывать несколько языков. Генеральный директор Meta Марк Цукерберг поделился примером, демонстрирующим способность модели различать говорящих и переключаться между языками, включая «переключение кодов».
«Модель решает, когда слушать. Она ждет немного дольше на сложных словах и быстрее принимает решения на простых, используя адаптивную задержку для предсказания каждого токена и повышения точности», — объяснил Цукерберг. «Она также справляется с шумным реальным аудио — обучена на более чем 70 языках (с 25 проверенными при запуске), обрабатывает переключение кодов в середине предложения и управляет часовыми сессиями с более чем 20 говорящими».
Релиз Meta последовал за Google Gemini 3.5 Transcribe менее чем через неделю. Пока Google интегрирует свою модель в Android и Chrome, планы Meta относительно Muse Voice Transcribe остаются неясными. В настоящее время модель обеспечивает диктовку в приложении Meta для Mac и доступна разработчикам через Muse Code и API моделей Meta по цене $3 за 1000 аудио минут.
Это последний релиз MSL после агента кодирования и модели с открытыми весами. Демо доступно в исследовательском блоге Meta.
Ключевые сущности: Компании: Meta, Google, Muse, MSI | Люди: Марк Цукерберг, Александр Ван
Источник: Engadget · Сводку подготовил HeadlinesBriefing