
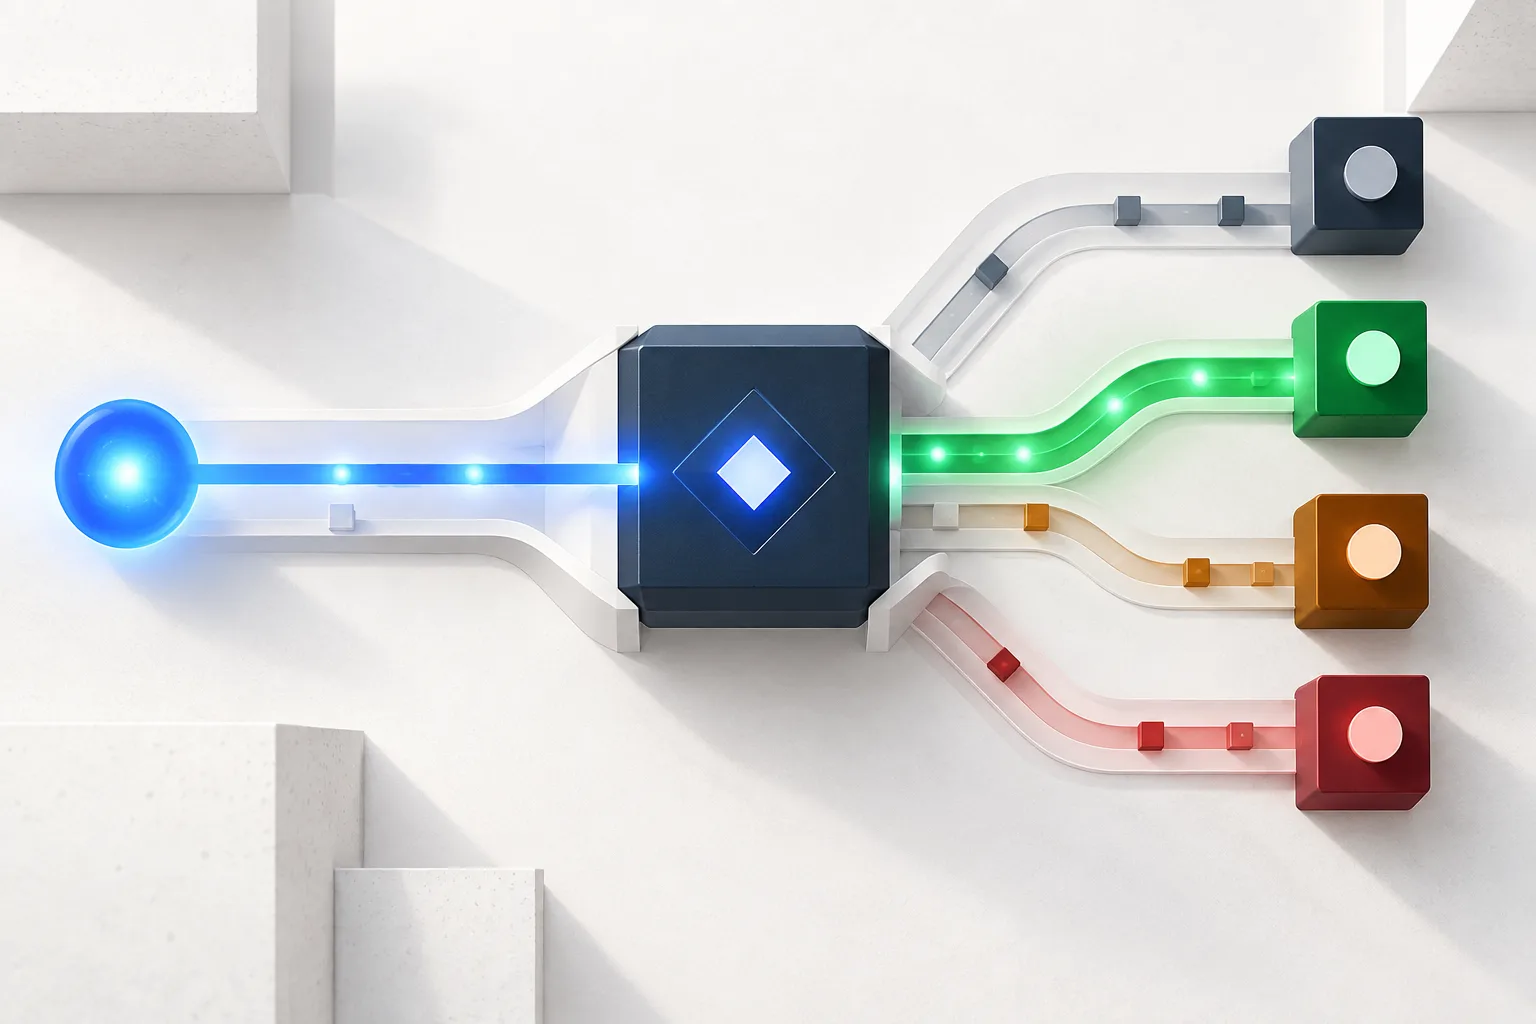
हर मॉडल कॉल को टेक्स्ट जनरेट करने की ज़रूरत नहीं है। रूटिंग अक्सर एक बड़े एजेंटिक सिस्टम के अंदर छिपा हुआ एक छोटा निर्णय होता है, फिर भी कई सिस्टम एक डिकोडर भाषा मॉडल से टोकन दर टोकन उस विकल्प को जनरेट करने के लिए कहते हैं। एक डिकोडर राउटर स्वाभाविक रूप से गलत नहीं है। यह तब उपयोगी होता है जब नीति खुली हो या रूट सेट तेज़ी से बदलता हो। लेकिन एक स्थिर, सीमित रूट सेट एक वर्गीकरण-आकार की समस्या पैदा करता है जिसे एक के रूप में मापा जाना चाहिए।
व्यावहारिक अवसर एक निर्णय परत है: स्पष्ट उम्मीदवार रूट, टाइप किए गए स्कोर, एक थ्रेशोल्ड या परहेज नीति, और नियतात्मक सॉफ्टवेयर शाखाएँ। नवीनता एक नया सिस्टम प्रिमिटिव है, न कि वर्गीकरण की पुनः खोज। Jev एक टाइप किए गए, संभाव्य निर्णय इंटरफ़ेस का एक उपयोगी सार्वजनिक उदाहरण है; इसकी मालिकाना वास्तुकला और प्रशिक्षण उद्देश्य सार्वजनिक नहीं हैं।
दक्षता और सटीकता का प्रदर्शन किया जाना चाहिए, मान लिया नहीं जाना चाहिए। समान रूट, डेटा, नीतियों और मूल्यांकन मेट्रिक्स पर डिकोडर रूटिंग, एक एनकोडर-प्लस-हेड बेसलाइन, और एक संरचित-निर्णय कार्यान्वयन की तुलना करें।
आधुनिक AI का प्रमुख मानसिक मॉडल जनरेटिव है: एक प्रॉम्प्ट प्रदान करें, फिर एक डिकोडर को अगला टोकन भविष्यवाणी करने दें। यह एक असाधारण क्षमता है, लेकिन यह मशीन इंटेलिजेंस का एकमात्र उपयोगी रूप नहीं है। एजेंटिक सिस्टम के अंदर कई क्रियाएँ सीमित परिचालन प्रश्न हैं: किस विशेषज्ञ को यह मामला मिलना चाहिए? क्या आगे बढ़ने के लिए सबूत पर्याप्त है? क्या सिस्टम को कार्य करना चाहिए, बढ़ाना चाहिए या परहेज करना चाहिए?