
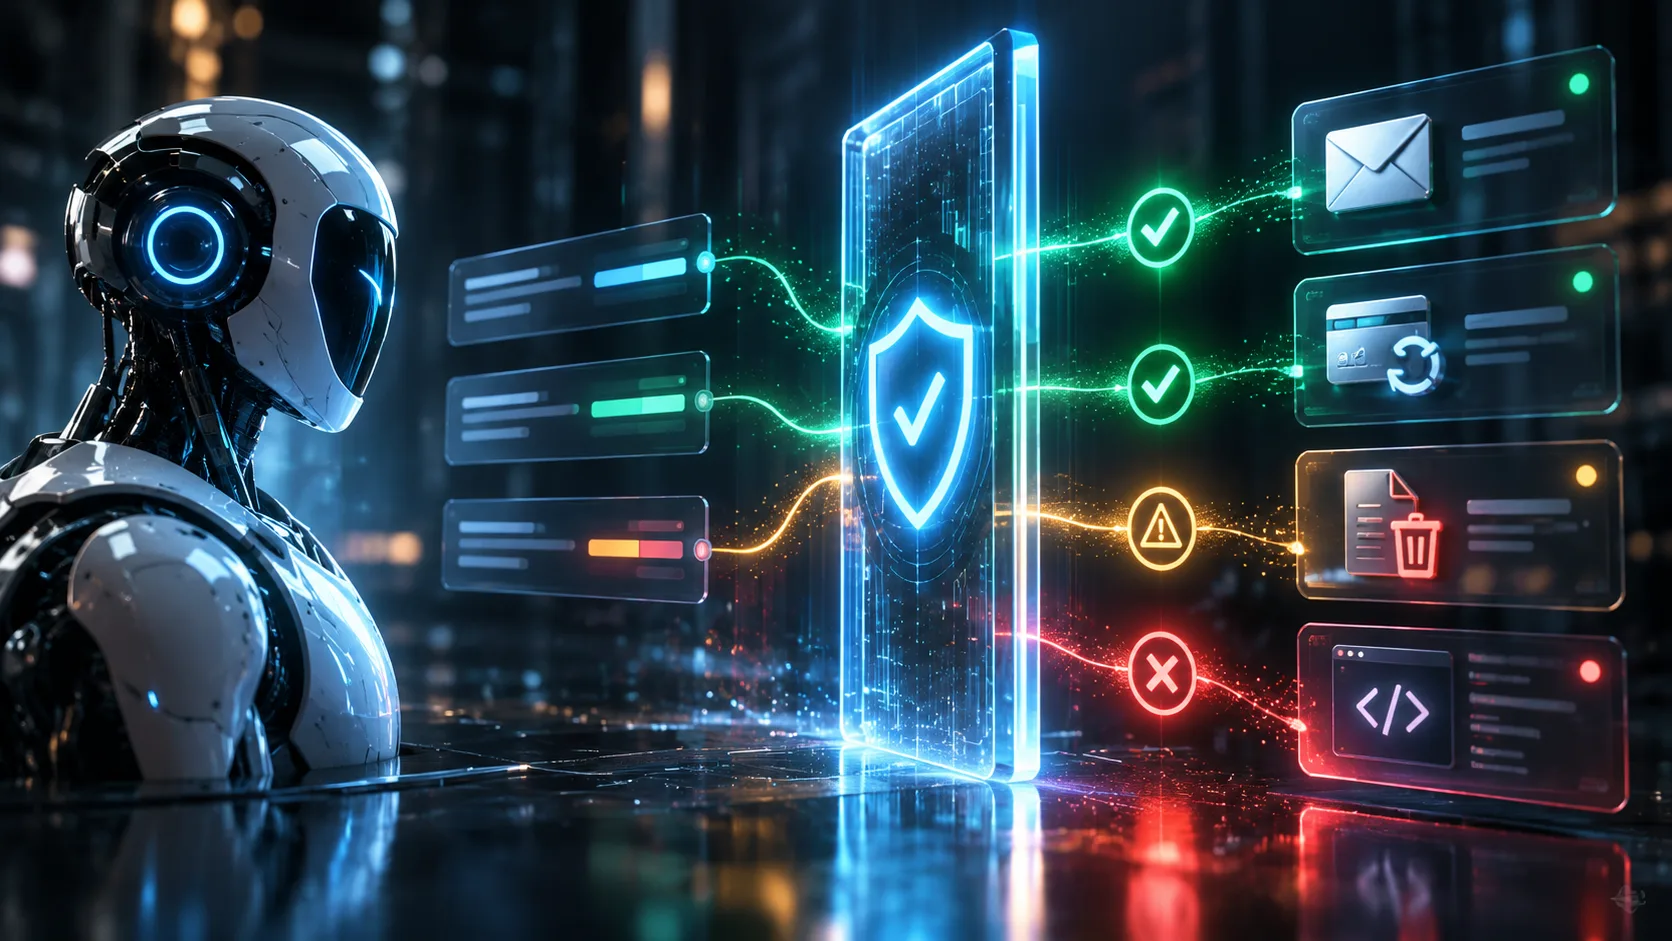
Un agente de IA que solo chatea conlleva poco riesgo, ya que una respuesta equivocada puede volver a pedirse sin más. Sin embargo, en cuanto ese agente puede llamar a herramientas, un error puede significar un correo enviado o un pago transferido, y la solución habitual de colocar un segundo modelo delante para revisar al primero empieza a parecer como contratar a un becario para supervisar a otro becario.
Un caso sencillo muestra el problema. Un cliente recibe dos cargos por una compra de 12 dólares y pide un reembolso a un agente de IA. El agente elige la herramienta correcta y el cliente correcto, pero prepara un importe de 120 000 centavos en lugar de 1200 centavos por cargo. El ID del cliente es válido, el valor es un entero y el esquema lo acepta, así que nada parece roto. El importe está desviado en un factor de cien, el tipo de error que aparece cuando los dólares se convierten a centavos dos veces. Un tope sencillo de 500 dólares detectaría la versión de 1200 dólares, pero no un error de 120 dólares que sigue siendo diez veces lo que el cliente aprobó.
Esa brecha llevó al autor al modelo Jev de Type Safe AI, lanzado el 15 de septiembre como el primero de lo que la empresa llama System One Models. Está en acceso anticipado. En lugar de generar texto, Jev toma el estado de la aplicación y una pregunta acotada, y devuelve una respuesta probabilística tipada, una tarea distinta a la de un modelo de chat normal. Las salvaguardas para entradas y salidas figuran entre sus usos previstos.
El autor señala que la validación de esquemas maneja errores estructurales pero no semánticos, como enviar un correo al destinatario equivocado cuando ambas direcciones son válidas. Un modelo como Jev podría encajar como capa de decisión en un sistema de agentes, aunque el artículo se centra en dónde debe ubicarse y en qué decisiones no debe confiársele, más que en resultados de pruebas comparativas.
Fuente: Towards Data Science · Resumido por HeadlinesBriefing